
对应分析
这个方法是做什么的
把两个定类变量的交叉表画成一张图:行变量的各个类别与列变量的各个类别一起投影到同一个低维平面上,让“哪些类别倾向于同时出现”一眼可见。它做的是几何降维,不是检验——先用 Pearson 卡方判断两个变量是否独立,再把这个 χ² 按维度拆开(示例 4×4 表,χ²(9)=47.563,三个维度的 χ² 分量 43.423+3.509+0.630 相加恰好等于它),看二维平面装下了多少关联信息。
除了对应图,报告给出总惯量(= χ²/N,示例 0.1982)与各维度的惯量、贡献率、累计贡献率;关联强度给 Cramér's V 及其 95%CI 与 Cohen's w;卡③ 另配一张调整标准化残差热力图,逐格标出实际频数是高于还是低于独立假设下的期望。卡④ 的点诊断表是解读对应图的前提:每个类别点的质量 mass、惯量、对各维度的贡献 CTR、cos² 与二维累计质量都在这张表里。
需要准备什么数据
- 行变量 [定类]:1 个,定类变量(分组/标签)
- 列变量 [定类]:1 个,定类变量(分组/标签)
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「行变量 [定类]」的类别数需在 2~20 之间。
- 「列变量 [定类]」的类别数需在 2~20 之间。
- 「行变量 [定类]」的每一组至少 5 个样本。
- 「列变量 [定类]」的每一组至少 5 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 品牌 × 形象词、职业 × 学历这类两个定类变量的对应关系,需要一张可直接放进报告的定位图
- 类别较多、逐格看残差表太累,想先用图找出成簇的类别组合
- 需要在检验之外补充“关联的结构长什么样”,而不只是一个 p 值和一个 V
- 需要论文里规范的惯量分解表(奇异值、惯量、χ² 分量、累计贡献率)
前提:两个变量都必须是定类,各 2~20 个类别,构成至少 2×2 的列联表;每个类别至少 5 个观测;数据表至少 30 行。卡方近似要求期望频数≥5 的单元格占比不低于 80%、最小期望频数≥1,卡① 会实测给出(示例最小期望频数 9.32、达标比例 100%)。期望频数不足时维度惯量与点的位置估计都会不稳。
什么时候不要用它
- 要一次考察三个及以上分类变量:对应分析的两个拖拽区各只收 1 个变量,多变量的共现结构用「多重对应分析」。
- 只需要判断是否关联、以及是哪几格贡献了关联,不需要图:用「卡方检验」看逐格期望频数与调整残差;一个行变量批量扫多个列变量用「列联(交叉)分析」。
- 想给两个变量的联合频数建模、检验特定的交互项(含三维交互):对应分析是描述性的,不能做模型比较,用「对数线性模型」。
- 变量是定量的,你想看的是变量之间的结构:用「主成分分析(PCA)」;想看对象之间的相似性构形,用「多维尺度分析(MDS)」。
- 要在第三个变量分层之后再看关联(控制混杂):本模块不做分层,用「分层卡方分析」。
容易误读的地方
- 行点与列点之间的距离不能直接解读,这是对应图最经典的误读。 模块卡⑤ 的局限段落写明:图上的距离在行点之间、列点之间可直接比较,但行点与列点之间的距离只反映相对关联倾向,不宜作绝对距离解读。所以不能因为某个职业点画得离某个学历点很近,就断言这一组合超额。要判断具体某个行 × 列格子是否真的偏离独立期望,回到卡③ 的残差热力图:示例中 |z|>1.96 的格子共 4 个,最强的是“技术研发”ד高中及以下”,z=5.25、实际频数高于期望。
- 看图之前先看 cos²,低 cos² 的点在图上的位置没有意义。 卡④ 的点诊断表里,cos² 是“该点的惯量被这个维度解释了多少”,二维累计质量则是它在这张图上被刻画得有多充分。示例中“本科”的二维累计质量只有 0.624,模块的结论句直接提示 cos² 较低(如小于 0.3)的类别位置不可过度解读。把一个没被表征好的点当作“居中、无特征”来解释,是把投影损失读成了实质结论。
- CTR 高和被解释得好是两回事。 贡献率 CTR 回答“这个点塑造了该维度多少”,cos² 回答“该维度解释了这个点多少”,两者可以完全脱节:示例“大专”对维度2 的贡献高达 54.14%,而它对维度1 的贡献是 0.00、维度1 的 cos² 也是 0.000。给维度命名要用 CTR 高的那几个类别(示例对维度1 贡献最大的是“高中及以下”),判断某个点能不能解释要用 cos²,两列不能互相替代。
- “前两维累计贡献率 98.67%”装的是关联信息,不是数据的方差。 分母是总惯量 0.1982,而总惯量等于 χ²/N、也等于 Cohen's w 的平方(w=0.445,属中等)。所以这句话的准确含义是“两个变量之间那点关联,98.67% 能画在这张二维图上”,不是“模型解释了 98.67% 的变异”。把它写成后者,会让一个中等强度的关联听起来像一个近乎完美的模型。
- 对应分析本身不产生显著性,图分得开不等于变量有关联。 显著性只来自卡② 那张独立性检验表(示例 χ²(9)=47.563,p<0.001,G²=48.375 结论一致)。如果卡方不显著,对应图画出来的只是抽样噪声的几何投影,此时任何“某类人偏好某类”的解读都不成立;反过来,样本量很大时很小的 V 也会显著,所以要连同 Cramér's V 及其置信区间一起报告(示例 V=0.257,95%CI [0.192, 0.330])。
同一个差异,只把样本量从 20 加到 2000:效应量 Cohen's d 始终是 0.30,p 却从 0.35 掉到小于 0.001。p 变小说明「证据变足」,不说明「差异变大」——差多少要看效应量与它的置信区间。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:主结果(独立性检验与维度惯量分解)
- 输出结果三:可视化(对应图与残差热力图)
- 输出结果四:效应量与事后分析
- 输出结果五:结论与解读
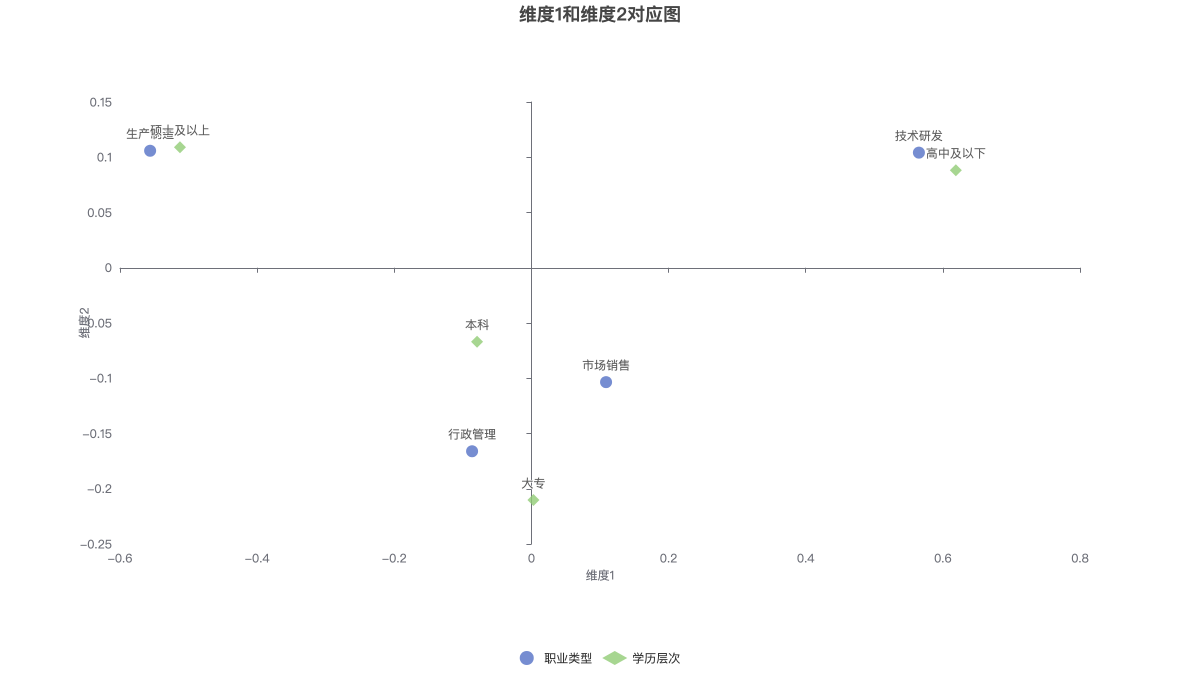
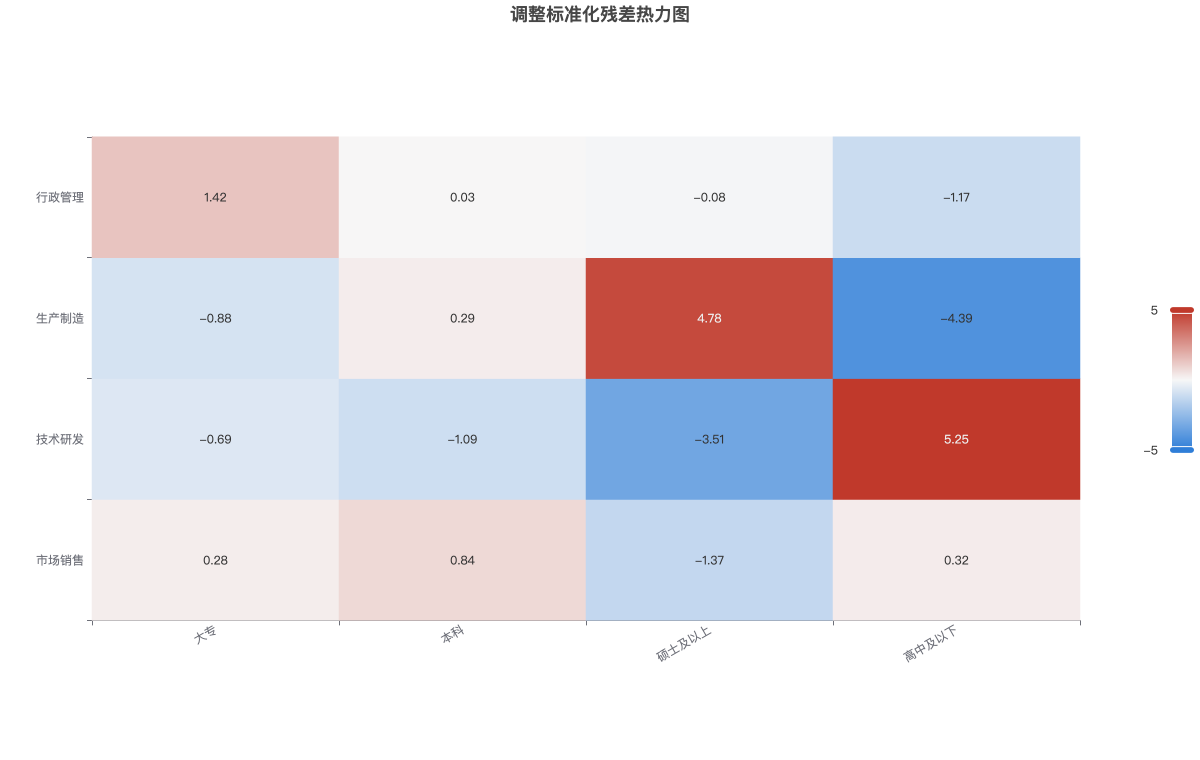
对应图中点与点的距离反映关联程度;残差热力图给出各单元格的调整标准化残差,|z|>1.96 表示该组合的实际频数显著偏离独立性假设下的期望(红色为高于期望,蓝色为低于期望)。