
方差成分分析
这个方法是做什么的
把一个数值指标的总变异拆开,看有多少来自各个随机分组之间的差别,多少留在组内。它回答“波动来自哪里”,不回答“谁的均值更高”——后者要把该变量当固定效应去做方差分析。因变量放一列定量变量,“随机因子”放定类分组变量(可多个,每个至少 2 个水平、每水平至少 2 个观测),“固定效应变量”可选,用来先扣掉你已知且关心其具体水平的因素。估计方法在控件里选,默认 REML,也可改成 ML;因变量、固定效应、随机因子中任一为空的记录整条剔除。
除了各来源的方差、标准差与贡献率,报告还给三样东西。一是该分量是否显著异于 0 的 F 检验,它由把全部因子放进普通最小二乘模型后的 Type II 方差分析给出,平衡设计下是精确检验、不平衡时是近似,与混合模型的分量估计相互独立,可交叉印证。二是固定效应的系数、Wald 检验与 95% 置信区间,其标准误已把随机因子带来的组内相关算进去,因此比忽略层级结构的普通回归更保守;分类型固定效应以字典序首个水平作参照类。三是卡④ 的换算:组内相关系数 ICC(也叫方差分割系数 VPC)、设计效应 DEFF = 1 + (平均组容量 − 1) × ICC、有效样本量 n_eff = N / DEFF,以及对数似然与 AIC / BIC。前提检验在卡①:模型是否收敛、各随机因子水平数是否充足、各水平组内方差是否齐(Levene)、残差是否正态(Shapiro-Wilk),同卡还列出每个随机因子的水平数与组容量分布。
需要准备什么数据
- 放入[定量]因变量:定量变量(数值)
- 放入固定效应变量(可选)(可选):不限
- 放入随机因子:至少 1 个,定类变量(分组/标签)
数据要求
- 数据表至少 8 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「放入随机因子」的类别数需在 2~200 之间。
- 「放入随机因子」的每一组至少 2 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 想知道产品指标的波动主要来自原料批次之间,还是同一批次内部的随机误差
- 多中心研究里,结局指标有多大一部分变异是医院之间的差异贡献的
- 学生成绩中班级或学校层面解释了多少变异,为“要不要上多层模型”定调
- 抽样设计阶段需要一个 ICC 与设计效应,用来估算样本量
最要紧的前提不是数据长什么样,而是你对随机因子的定位:它的各个水平被视为从一个更大的总体里随机抽出来的,你关心的是这个总体的离散程度,而不是抽到的这几个水平谁高谁低。这是随机效应区别于固定效应的根本假定,由研究设计决定,数据本身检验不了;观测独立性同理,卡① 的表注对此写得很直白。其余是常规要求:因变量为定量且存在真实变异,每个水平至少 2 个观测(只有 1 个观测的水平无法把组间变异与组内变异分开),至少 8 条完整记录。还有一条边界:本模块估的是加性方差分量,即每个随机因子一个方差参数,不含随机斜率与复杂协方差结构。
什么时候不要用它
- 你关心的其实是“哪几个水平之间有差异”(只有男 / 女两类,或三种确定的工艺):那些水平不是随机抽来的,应当作固定效应,用「单因素方差分析」。
- 数据是宽表、一行一个评价对象一列一位评价者:那问的是评分者信度,用「组内相关系数(ICC)」。两者相邻但入口不同:本模块要的是长表、随机因子为一列定类变量,只给单一的方差分割系数;ICC 模块要宽表,还要你按评价者是否随机抽样、关不关心系统性偏倚去选 ICC(1,·) / ICC(2,·) / ICC(3,·)。
- 要评量具或测量系统的重复性与再现性(零件 × 操作员 × 重复的平衡完全交叉设计):用「量具GageR&R(测量系统分析)」。
- 还要认真解释固定效应系数:用「混合模型」(注意它只拟合随机截距、不含随机斜率)。
- 因变量是二分类、计数或比例:方差分解建立在正态线性模型上,改用「广义线性混合模型(GLMM)」。
- 两位评价者对同一批对象做的是分类判断(阴性 / 阳性)而非打分:用「Kappa一致性检验」。
容易误读的地方
- 贡献率是相对份额,不是“变异有多大”。 “原料批次贡献 65.91%”只说明它占总方差的份额;残差一变小这个百分比就上升,哪怕批次之间的绝对差别没动。绝对量要看方差与标准差列(本例 7.3897 与 2.7184,后者与因变量自身的标准差 3.4184 同量纲,可以直接比)。数字还随估计方法变:同一份数据 REML 给 7.3897(65.91%),ML 给 6.7421(64.03%)——ML 对方差分量有向下偏倚,是预期行为,但报告必须写明用了哪一种。
- 分量的估计精度取决于随机因子的水平数,不是总观测数。 水平数相当于估计该分量时的样本量,模块把少于 5 个水平直接判为“偏少”,并写明该分量误差很大、很可能被估到边界 0。实测把批次压到 3 个水平、每水平 40 个观测(总量仍是 120 条),ICC 点估计 0.7213 看着很高,95% 置信区间却宽到 [0.3968, 0.9904],几乎等于什么都没说。1000 个观测配 3 个水平照样估不准——所以看贡献率之前,先去卡① 看层级结构那张表。
- 分量恒为非负,“0.0000”不等于“真的没有差别”。 REML 会把负估计截断到边界 0,正因为卡在边界上,报告不给对称的置信区间。实测再加一个只有 4 个水平的“操作员”随机因子,它的方差被估成 0.0000、贡献率 0.00%、设计效应恰好 1.000,而 F(3, 105) = 0.057、p = 0.982——正确读法是“这批数据分不出操作员之间的差别”,至于是真没差别还是水平太少,报告答不了。判断分量是否异于 0 请看 F 与 p 那两列,别看方差是不是印成 0。另外只要有两个及以上随机因子,ICC 那列的 95%CI 会整列变成“—”,因为单因素随机模型的区间公式此时不成立。
- ICC 的点估计与其置信区间不是同一套算法算的,而 ICC 高低的实际后果落在设计效应上。 点估计来自混合模型的 REML / ML,区间由方差分析的 F 统计量导出(矩估计口径),因此点估计不一定落在区间正中——实测把方法从 REML 换成 ML,ICC 由 0.6591 变成 0.6403,区间却原封不动仍是 [0.4579, 0.8529],因为区间那条路根本没走混合模型。后果方面:ICC = 0.6591、平均组容量 10 时 DEFF = 6.932,120 条观测的有效样本量只剩约 17.3;批次压成 3 个水平、组容量 40 后 DEFF 飙到 29.129,只剩 4.1。拿这些行当独立样本去做 t 检验或普通回归,标准误会被严重低估。最后一句边界:方差分解描述的是变异的来源结构,“批次贡献了 65.91%”不等于“批次造成了这些波动”,因果得由设计来支撑。
检验只能拒绝原假设,不能证明它成立。p = 0.42 既可能是真的没有差别,也可能是样本量不够、差别没被检出来,两者从这个 p 值上分不开。规范的写法是「没有证据表明……」;要论证「两者确实相当」,需要另做等价性检验。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:方差成分与固定效应主结果表
- 输出结果三:方差贡献率可视化
- 输出结果四:效应量与聚类结构分析
- 输出结果五:结论与学术表述
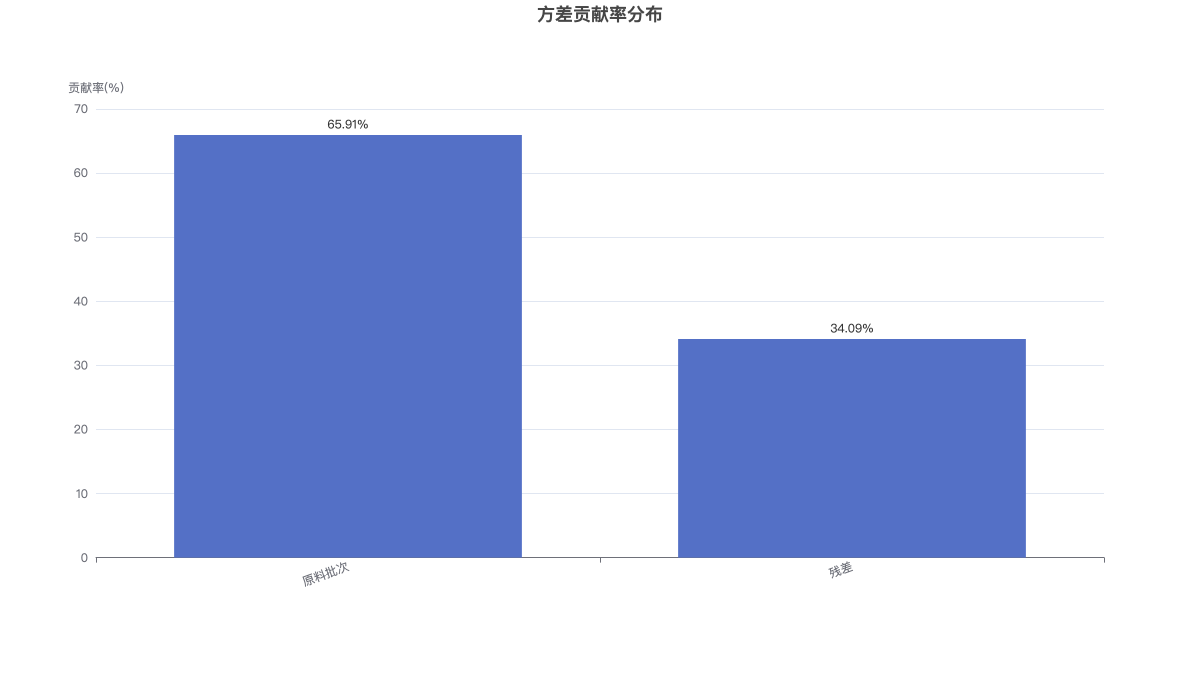
该图展示各变异来源占总方差的百分比,可用于识别主要变异来源;切换到饼图视图可更直观地看到各来源的份额。