
Fisher精确检验
这个方法是做什么的
2×2 列联表的独立性检验。它不做任何大样本近似:固定行、列两个边缘合计后,用超几何分布把所有同样极端或更极端的表格直接枚举一遍,加起来就是精确 p。正因为如此,它不要求期望频数 ≥5——它本来就是卡方近似失效时的替代方案;报告卡①仍会给出期望频数表,供你判断“这次到底该用哪一个”。
它和「卡方检验」问的是同一个问题——两个变量是否独立——差别在于怎么算 p:卡方走的是大样本近似,Fisher 走的是精确枚举,代价是只能处理 2×2 表且计算量随样本量增长。如果你不确定该用哪一种,「卡方检验自动求解器」会按表规模与期望频数替你判。
除了双侧 p,报告还给两个方向的单侧 p、Pearson χ² 与 Yates 校正 χ² 与似然比 G² 作为对照,以及条件极大似然的比值比 OR 及其精确95% 置信区间(与检验同出一个条件分布,因此有零频数格时也算得出来)。第四张卡另给一整套流行病学口径的效应量:以暴露组为分子的 OR、相对危险度 RR、风险差 RD、需暴露人数 NNH(或 NNT)、φ 系数、Cramér's V 与 Yule's Q。第五张卡是可直接誊入论文的方法、结果与局限性表述。
需要准备什么数据
- 分组变量X (行):定类变量(分组/标签)
- 分组变量Y (列):定类变量(分组/标签)
- 权重变量(可选):定量变量(数值)
数据要求
- 数据表至少 4 行。
- 单列缺失率不超过 50%。
- 「分组变量X (行)」必须正好是 2 个类别。
- 「分组变量Y (列)」必须正好是 2 个类别。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 2×2 表且样本较小,有格子的期望频数不足 5
- 表里有零频数格——OR 的常规 Wald 区间此时算不出来,精确法天然可处理
- 罕见结局的病例对照或队列研究,需要报告 OR 及其精确区间
- 表并不小,但你想要一个不依赖近似的确证性 p 值作为佐证
数据要求很低:至少 4 行、缺失比例可到 50%。但行、列都必须恰为 2 分类——这是端点会当场校验的硬约束,把一个 2 类 × 3 类的表喂进去会直接返回 400 错误“Fisher精确检验仅支持2x2表格,当前变量维度为 3x2”(维度按模块自己的行列口径报,与你拖入的先后未必一致),而不是悄悄替你合并类别。另有一个可选的频数权重变量,用于已经汇总好的频数表,权重须为非负数值。观测必须相互独立,每个个体只落进一格。
什么时候不要用它
- 表大于 2×2:用「卡方检验自动求解器」,它会按表规模与期望频数自动选法;或直接用「卡方检验」。
- 两列是同一批对象的前后两次测量(治疗前后是否阳性):独立性前提不成立,用「配对卡方检验」。
- 需要在多个层内控制混杂:用「分层卡方分析」;要同时调整多个协变量则用「逻辑回归」。
- 同一批个体被重复计入(同一患者多次就诊各算一行):p 值会被系统性低估,用「广义估计方程(GEE)」,配对设计则用「条件逻辑回归」。
- 行变量或列变量本身有序,你关心的是趋势而非任意关联:用「Ridit分析」或「有序逻辑回归」。
容易误读的地方
- 报告里有两个 OR,互为倒数,抄错方向结论就反了。 卡②的统计量汇总表给 OR=0.305,它按列联表的原始排列定义(示例中分子是“不吸烟”组中“患病”的比值);卡④效应量表的首行给 OR=3.278,那是流行病学取向(以“吸烟”为暴露组、“患病”为阳性结局)。0.305 × 3.278 ≈ 1,显著性完全等价,表注也写明首行才是论文中应报告的那个。
- 两个单侧 p 的方向以卡②的 OR 为准,不是卡④的。 示例里 H₁: OR>1 那一行的 p>0.999、H₁: OR<1 那一行的 p<0.001,看着像自相矛盾,其实只是两行说的是同一件事的两个方向,取向都以本表的 OR=0.305 定义。表注专门写着“勿套用表6 首行的 OR”。另外单侧 p 只有在设计阶段就写明了方向性假设时才可以报,事后择优挑单侧会抬高第一类错误率。
- 谁是暴露组、谁是阳性结局,是按类别名称自动推断的。 卡④的表注写明:“该方向由类别名称自动推断,若与研究设计相反,请在数据中重新编码类别后重跑。”所以在誊写 OR、RR、RD 之前,先去看那张“分组发生率”表的行标签,确认“暴露/试验组”“参照/对照组”指的确实是你想的那两组。
- 不显著不等于无关联,这个检验在小样本下尤其保守。 它以两个边缘合计为条件,实际的第一类错误率低于名义 α,检验效能因此低于卡方——卡⑤的局限性说明写明了这一点。结果不显著时该看的是 OR 的精确区间有多宽:区间从 0.5 一直到 4,说明的是样本量不足,不是“两者无关”。
- OR 不是风险倍数,结局不罕见时它会明显夸大关联。 示例总体“患病”率 36.33%,OR=3.278,而同一份数据的 RR 只有 2.139、风险差 RD=0.266。队列与随机试验设计应优先报 RR 与 RD(RD 可直接换算成 NNT/NNH);病例对照设计因为发生率无法从设计中估计,只能报 OR。
检验只能拒绝原假设,不能证明它成立。p = 0.42 既可能是真的没有差别,也可能是样本量不够、差别没被检出来,两者从这个 p 值上分不开。规范的写法是「没有证据表明……」;要论证「两者确实相当」,需要另做等价性检验。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二: Fisher 精确检验表(主结果表)
- 输出结果三: 交叉图
- 输出结果四:效应量与事后分析
- 输出结果五:结论与解读
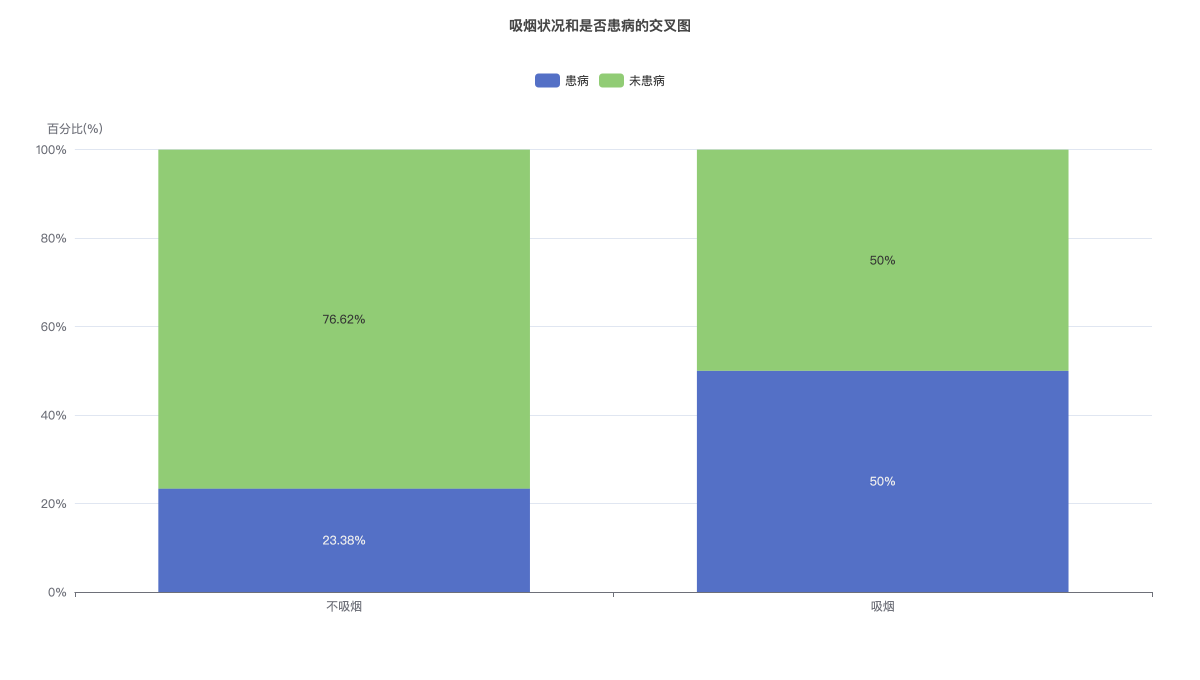
您可以通过图表上方的控件切换指标(如频数、行/列百分比)和图表类型;也可用切换器切到「表格」查看列百分比数据表。