
Kappa一致性检验
这个方法是做什么的
两位或多位评价者把同一批对象归到互斥的类别里(阳性 / 阴性 / 可疑,合格 / 不合格,轻 / 中 / 重),Kappa 衡量他们的判定有多吻合。它和“一致率”的关键区别是扣掉了随机的部分:κ = (p_o − p_e) / (1 − p_e),其中 p_o 是实际落在对角线上的比例,p_e 是两人的类别使用倾向彼此独立时、纯靠机遇也会碰巧一致的比例。所以 κ 永远不会比一致率好看。
除了 κ、置信区间与 Landis & Koch 分级,报告还给出解释 κ 所必需的三个配套量:κ_max(保持两侧边际分布不变时 Kappa 能达到的上限)、κ / κ_max,以及把期望一致率固定为 1/k、因而不受边际不平衡影响的 PABAK。前提部分对每一对评价者做 Bowker 对称性检验(2×2 时即 McNemar),用来分辨分歧是随机的还是系统性的——卡①给的是它们的原始 p,自始至终不做多重性校正。卡④另有一张 Holm-Bonferroni 校正表,但校正的是各配对 Kappa 的 z 检验 p,不是 Bowker 的 p,两者别看串了。顶部“方法”下拉四选一:简单 Kappa(默认)、线性加权、平方加权、Fleiss Kappa。
需要准备什么数据
- 放入分类变量 (≥2列,Fleiss需≥3列):2~50 个,定类变量(分组/标签)
- 可选:频数权重变量(≤1列)(可选):定量变量(数值)
数据要求
- 数据表至少 20 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「放入分类变量 (≥2列,Fleiss需≥3列)」的类别数需在 2~20 之间。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 两名医生对同一批影像的阴阳性判读是否一致
- 两名编码员对同一批开放题、访谈文本的分类编码是否一致(内容分析的编码信度)
- 三位以上评价者做分类判定:选 Fleiss Kappa,它给的是全体评价者的一个总体 κ,而不是逐对的 κ
- 等级判定(轻 / 中 / 重、1~5 级):选加权 Kappa,让“差一级”比“差两级”受到更轻的惩罚
数据要摆成一行一个对象、一列一位评价者,所有人使用同一套互斥且穷尽的类别,每人对每个对象只判一次。有一条容易踩的硬边界:某位评价者若整列都是同一个类别,常数列会被拦下——但理由不是“Kappa 无定义”。整列同类时 p_o 与 p_e 恒相等,κ 必然为 0,是有定义的;拦它是因为这一列不携带任何一致性信息。p_e 真的等于 1、Kappa 才无定义的情形,只发生在全部评价者都只用到 1 个类别的时候。另外还有一个可选的“频数权重变量”拖拽区,但它救不了汇总表:本模块按整表行数要求至少 20 行,2×2 汇总表只有 4 行、3×3 只有 9 行,实测都被“少于Kappa一致性检验所需的至少 20 行”这一条挡在门外。所以本模块要的是逐例数据(一行一个对象、一列一位评价者),频数权重只在整表行数本身够的时候才用得上。
什么时候不要用它
- 评价者给的是连续分数而不是类别:用「组内相关系数(ICC)」。
- 你关心的是排序一致(多位评委对若干方案排名次):用「Kendall一致性检验」。
- 列是问卷题目而不是评价者,你要问的是量表的内部一致性:用「信度分析」。两者都叫信度,看的东西却完全不同——Cronbach α 的列是题目,问这些题是不是在测同一个构念;Kappa 的列是评价者,问不同的人对同一件事判得一样不一样。
- 两列本来就是两个不同的变量(性别 × 是否付费),你要问的是它们有没有关联:用「卡方检验」。两个方法读的是同一张列联表,问题却不同:卡方问“两列是否独立”,Kappa 问“两列是否落进同一格”。极端情况看得最清楚——两位评价者完全反着判(甲说阳性乙必说阴性),卡方会极度显著,Kappa 却是负的。
- 你想问的是“甲是不是比乙更容易判阳性”(两人的边际分布有没有系统差别),而不是逐个对象是否吻合:用「配对卡方检验」;卡① 的 Bowker 对称性检验在 2×2 时就是它。
- 你要评估的是判得对不对而不是彼此一致不一致:一致性回答不了这件事,需要拿金标准来比,用「ROC曲线分析」这类给出灵敏度、特异度的方法。
容易误读的地方
- 别把一致率当成 Kappa 报出去,两者能差出一整个档次。 示例中第一对评价者的观察一致率 p_o = 0.787,看着不错;但类别有 3 个、边际又大致均匀,纯靠机遇就能达到 p_e = 0.334 的一致率,扣完之后 κ 只有 0.680。反过来,κ 也因此不能像百分比那样直觉解读——它是“超出机遇的那部分一致性,占最大可能改进空间的比例”。
- 一致率很高而 Kappa 很低,先怀疑“Kappa 悖论”,别急着判定评价者不可靠。 当某个类别的发生率极高(比如 95% 的对象都判阴性)时,p_e 会逼近 p_o,κ 被压得很低,哪怕一致率高达 90%。第四张卡的 κ_max 就是用来分辨这件事的:它是保持两侧边际不变、把一致性拉满之后 Kappa 所能达到的天花板。κ 接近 κ_max,说明边际几乎没有构成限制,剩下的是随机分歧,出路是减少个案判读的随意性;κ 明显低于 κ_max,才说明两人对类别的使用倾向不同,属于系统性偏倚,出路是统一评分标准而不是加强训练。同一张表里的 PABAK 不受边际不平衡影响,可以作为补充参考,但不能替代 Kappa 报告。
- 这里的 p 值几乎不携带信息。 检验的原假设是 κ = 0,即“一致性完全出于机遇”——这是低到不能再低的门槛,样本量稍大就几乎必然显著。示例中三个配对的 p 全部小于 0.001,可这只说明它们好过瞎猜。真正决定结论的是 κ 的取值与置信区间下限(示例中约 0.58)。另外主结果表里的标准误是零假设下的 ASE₀,只服务于那个 z 检验;95% 置信区间用的是另一套 ASE₁,两者口径不同,不要拿标准误自己乘 1.96 去造区间。
- 类别有序就该用加权 Kappa,无序类别绝不能用。 简单 Kappa 把“轻判成中”和“轻判成重”当成同样严重的分歧,对等级资料明显不合理;但科室、渠道、品牌这类无序类别之间没有“距离”可言,加权 Kappa 的权重就失去了意义。方法一换,区间的算法也跟着换:简单 Kappa 用闭式的 ASE₁,加权 Kappa 改用对对象重抽样的 Bootstrap 百分位区间与置换检验,报告时要写清楚用的是哪一种。
- Kappa 高只说明大家一致,不说明大家判得对。 所有评价者完全可以一致地犯同一个错误——同一套有偏的诊断标准、同一份有歧义的编码手册,都会让 κ 很漂亮而结论全错。一致性是准确性的必要条件,不是充分条件;要证明判得准,只能与金标准比较。
ICC 的格子里是分数、Kappa 是类别、Kendall 一致性检验是名次;前两者一行一个被评对象、一列一位评价者,Kendall 恰好相反。表拖反了不会报错,只会算出一个几乎为 0 的 W。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:Kappa 一致性检验主结果表
- 输出结果三:一致性可视化
- 输出结果四:效应量与一致性诊断
- 输出结果五:结论与学术表述
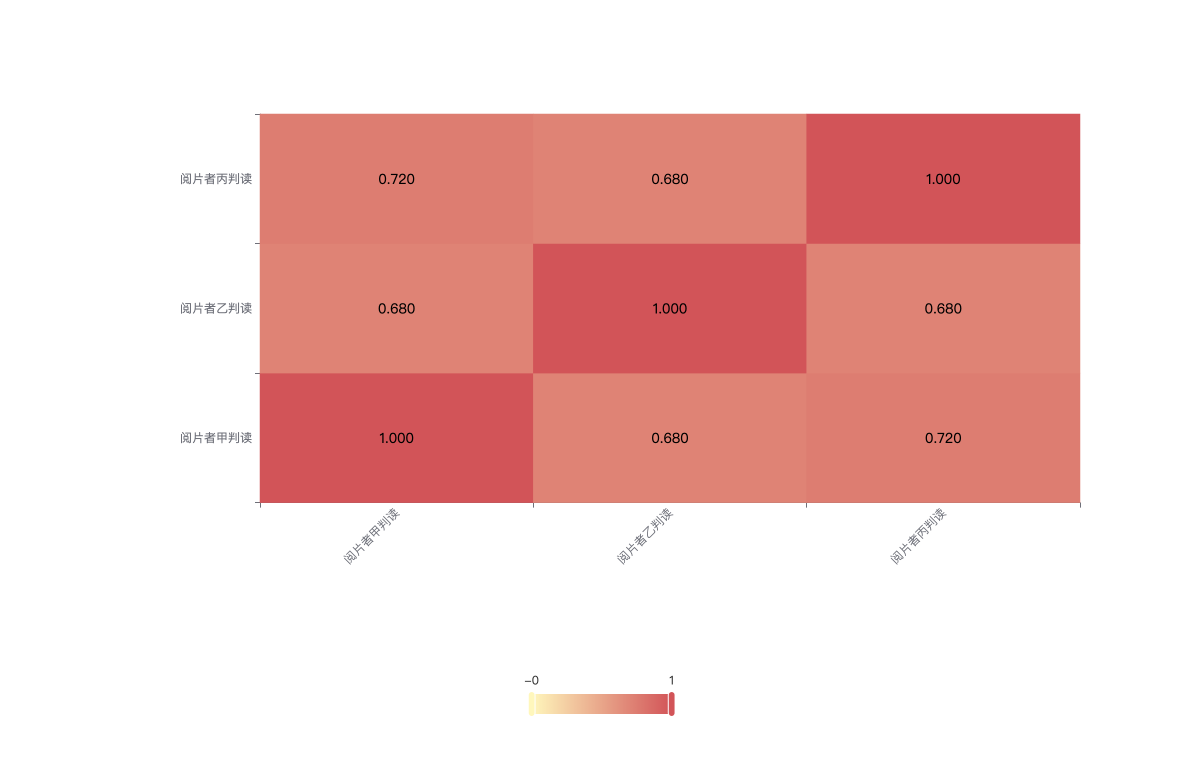
该热力图展示所有评价者配对之间的 Kappa 系数。对角线恒为 1(评价者与自身完全一致),矩阵沿对角线对称。