
LightGBM回归
这个方法是做什么的
预测一个数值型因变量的梯度提升实现,两处工程取舍决定了它的脾气:一是把连续特征分箱成直方图再找切点,训练快、内存省;二是按叶子优先生长——每一轮只挑当前增益最大的那个叶子继续分裂,不保证树是平衡的。所以同样的深度限制下,它比按层生长的实现更能往深处钻,在大样本上更贴合,在小样本上也更容易钻进噪声。默认 200 轮、学习率 0.1、叶子数 31、最大深度 6。定类自变量可直接拖入,管线内独热编码;不产出回归系数。
报告共五张卡。主结果口径是 5 折 KFold 交叉验证:表4 给验证折 R²、RMSE、MAE 的均值、折间标准差与 95%CI,另附“训练折均值”与一次留出测试集两列,表5 是逐折明细——这一族八个模块的报告结构相同,但逐折明细在本模块尤其值得逐行看:本次折间标准差 0.2797,是八个模块里最大的(见下)。卡① 给建模设置与前提诊断(n∶p 比、尺度差异、VIF、因变量分布形态、疑似数据泄漏、重复观测);卡③ 给逐折 R² 柱状图、拟合散点与残差图;卡④ 给置换重要性、Cohen f² 与相对均值基线的 RMSE 降幅;卡⑤ 给论文用的规范表述。
需要准备什么数据
- 放入因变量Y:不限
- 放入自变量X:至少 1 个
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 30%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 样本量较大(上万条起)、特征维度高,别的树集成已经慢到不可接受
- 关系非线性且带交互,定量与定类自变量混杂
- 愿意把叶子数、轮数、学习率当成一组参数一起调,并以交叉验证均值为准取舍
- 只需要预测精度与变量重要性排序,不需要系数与显著性检验
前提:因变量必须是连续数值且有真实波动。有效样本量建议 ≥30,且“样本量 / 独热编码后特征维度”比值 ≥10。模块的数据要求里另有一条针对本算法的提醒:按叶子生长时,小样本上叶子数过大会直接过拟合。本模块的样本量瓶颈还有一条没写进这句提醒里:每个叶子至少 20 个样本是库的默认下限,训练样本不足时叶子数根本长不到你设的值(见下)。所选变量上有缺失的整行会被剔除。
什么时候不要用它
- 因变量是类别:用「LightGBM分类」。
- 样本量只有几百条:按叶子生长在小样本上极不稳(见下)。同为提升树但默认按层生长、更保守的「XGBoost回归」是更合适的对照;样本量小又想要稳定系数,直接用「岭回归(Ridge)」。
- 要系数、标准误与 p 值:本模块一项都不给。用「线性回归 (最小二乘法)」;自变量多且想同时筛选用「Lasso回归」。
- 要预测训练取值范围之外的样本:提升树不能外推,用「线性回归 (最小二乘法)」;沿时间外延用「时间序列分析(ARIMA)」。
- 观测之间不独立(同一对象多期、分层嵌套):交叉验证会把同一个体拆到两边,R² 虚高;用「混合模型」或「面板模型」。
容易误读的地方
- R² 可以是负数,本次示例就出现了。 表5 逐折明细里第 5 折 R²=−0.2016,交叉验证 95%CI 的下限是 −0.1030。R² 为负的含义很具体:在那一折的验证样本上,模型的预测还不如“不看自变量、一律预测训练集均值”。它不是“解释了负的变异”,也不是数值错误。只要 95%CI 的下限落在 0 以下,“这个模型有预测能力”这句话就没有证据,哪怕均值 0.2444 看起来还说得过去。
- 折间标准差 0.2797 比均值本身还大,这才是本次报告的主结论。 五折的 R² 从 −0.2016 一路跳到 0.5498,卡⑤ 也直接写了“折间波动较大,泛化结论对样本划分敏感”。默认 200 轮 × 学习率 0.1 已经把训练折拟合到 R²=0.8140,而三个自变量与因变量的 Pearson r 只有 0.6257、0.5008、0.4365(卡① 表2),信号本就不强——多出来的拟合力气都花在学随机波动上,换一批划分模型就变一个样。遇到这种情况,正确的动作是把交叉验证结果连着折间标准差一起报,而不是在五折里挑一个好看的数字。
- 小样本上“叶子数”和“最大深度”这两个控件很可能都没生效。 LightGBM 另有一个没有暴露在控件里的默认下限:每个叶子至少 20 个样本。本次 192 条训练样本,因此每棵树最多只能长到 9 个叶子——实测就是 6~9 个,离设定的 31 差得很远;把“叶子数”从 31 调到 8、或把“最大深度”从 6 调到 8,训练折与验证折的 R² 都几乎不动。所以看到报告说过拟合明显时,在小样本上先动这两个旋钮多半白费力气,真正管用的是减少“迭代轮数”、降低“学习率”或增大样本量。树实际长成什么样,控件和报告里都看不到。
- 折间不稳的时候,卡④ 的变量重要性排序更不可信。 置换重要性只在那一次留出测试集(本次 48 条)上算了 20 遍随机重排,反映的是“在那一次划分上训练出来的那个模型里”谁被用上了。这 48 条是与交叉验证错开种子另抽的一批,不是某一折的副本;但交叉验证跑在全部 240 条上,它们仍落在各折的训练折里,所以“留出测试集”那一列也不构成第二次独立验证。而且这一次的划分本身就格外不利:留出 R² 只有 0.0807,比表5 里五折中的四折都低。本次只有“广告投入”的 ΔR²=0.2688、95%CI[0.1228, 0.4781] 下限大于 0,“门店面积”只有 0.0143,“促销折扣力度”更是 −0.0151、占比栏直接写“—(无正向贡献)”——而模型本身在不同折之间连 R² 都稳不住,排序自然更没有保障。重要性也不是因果效应,不等价于回归系数的显著性;要后者请用「线性回归 (最小二乘法)」。
- 不能外推,直方图分箱让这件事更绝对。 连续特征在训练时就被切成有限个箱子,超出最大箱边界的新值一律落进最后那个箱;配上每棵树的输出都来自训练样本残差,自变量走出训练范围后预测值锁死为一个常数。本模块示例数据里“门店面积”是 55.1~389.6 平米,超出这段的预测没有依据;预测前先看卡① 表2 的“取值范围”列。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:主结果表(交叉验证性能)
- 输出结果三:可视化(逐折性能 / 拟合散点 / 残差)
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
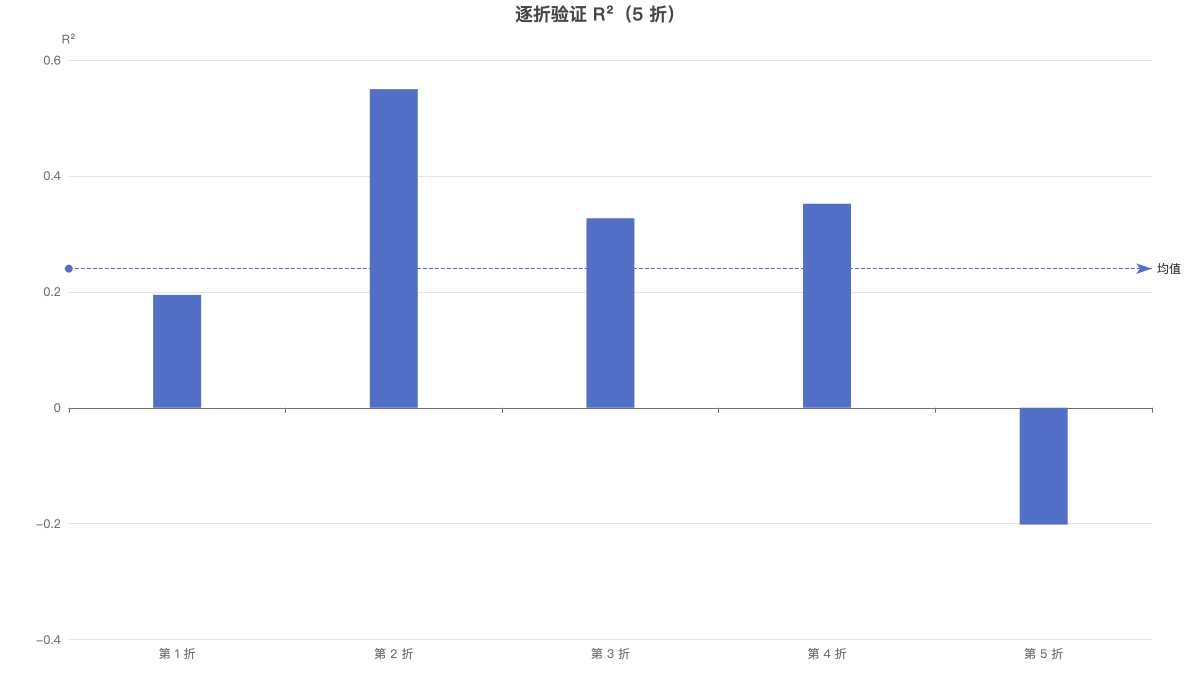
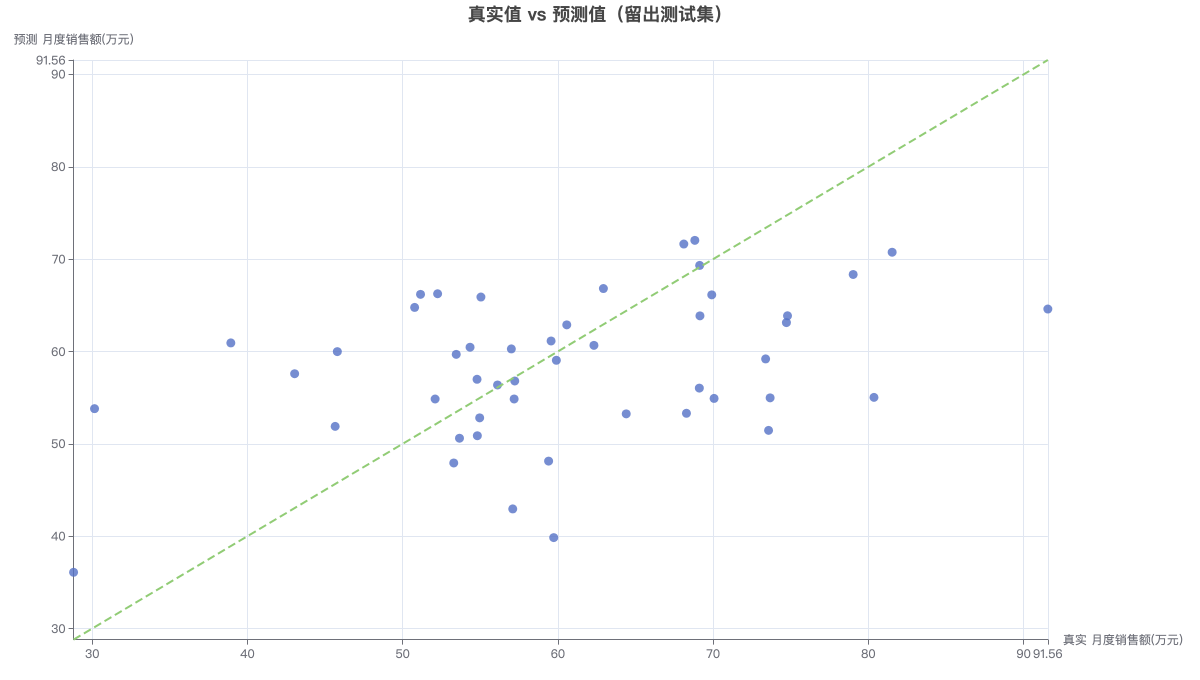
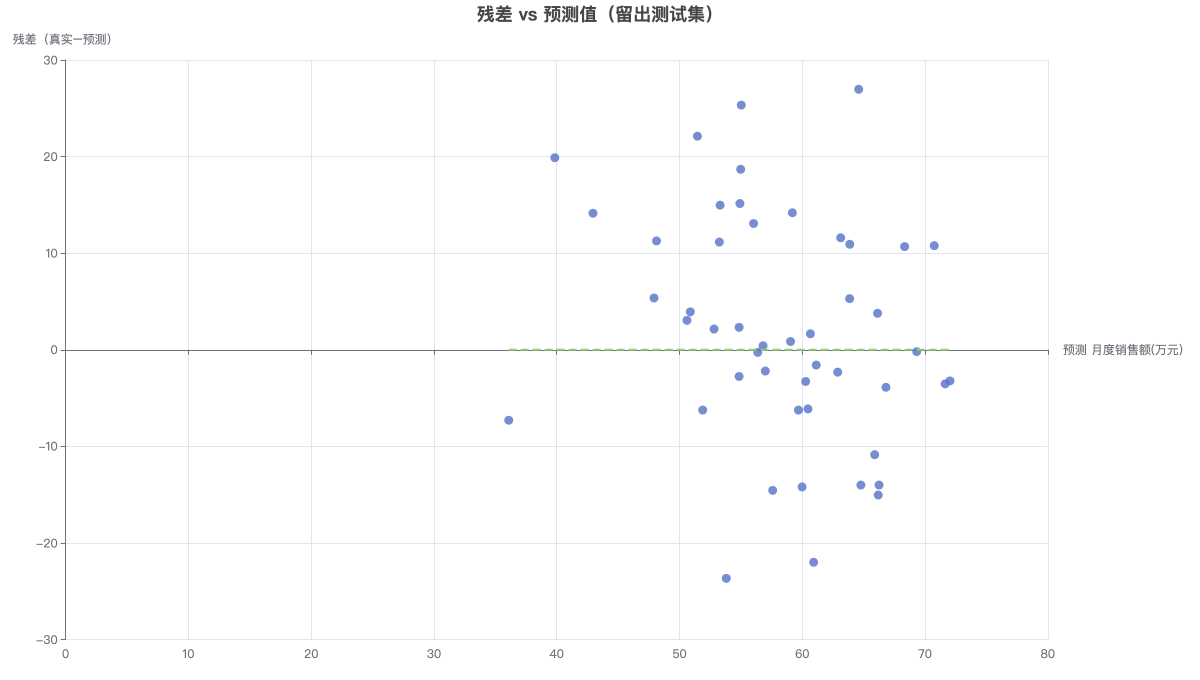
三张图分别回答:模型在不同数据划分下稳不稳(逐折 R²)、预测值贴不贴近真实值(散点)、误差是否随预测水平系统性变化(残差图)。