
似不相关回归(SUR)
这个方法是做什么的
一次给多个定量因变量各建一个回归方程、共用同一组自变量,再联合估计。Zellner(1962) 的想法是:这几个方程虽然各有各的因变量,但扰动项可能同期相关——同一家门店的销售额与毛利,会被同一场天气、同一次促销事故同时推高或压低。把这层相关利用起来,广义最小二乘可以比逐个方程做最小二乘更有效率。本模块用 linearmodels 的 SUR 以广义最小二乘联合估计,协方差类型为稳健(robust)。
这份报告真正的落点是跨方程的残差相关结构,那是逐个跑回归拿不到的东西:卡① 给 Breusch-Pagan 跨方程独立性检验(H0:各方程残差互不相关)与每个方程各自的残差正态性检验,卡③ 是残差相关热力图,卡④ 给残差同期相关矩阵,以及每个方程的 R²、Wald χ² 与 Cohen f²。要注意各方程的整体检验用的是 Wald χ² 而不是 F——表注写明在 linearmodels 的稳健协方差下它是渐近 χ²(自变量个数)。
需要准备什么数据
- 放入[定量]因变量 Y(多方程,≥2 个):至少 1 个
- 放入[定量]自变量 X(各方程共用):至少 1 个
数据要求
- 数据表至少 20 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 有几个结果指标由同一批自变量解释,你想在一张表里同时呈现,并说清它们不是互相独立的
- 你想知道这几个结果的“意外波动”是不是同源,也就是扰动项有没有同期相关
- 因变量之间量纲不同、不适合合成一个综合指标,但又不愿分开报告显得零散
- 需要一次性给出多个方程的系数与稳健标准误,便于横向对照同一个自变量在不同结果上的作用
至少需要 2 个定量因变量(各构成一个方程),以及至少 1 个各方程共用的定量自变量;因变量与自变量不能是同一列,否则该方程用自身预测自身而完全共线。每个方程含常数项共“自变量个数+1”个待估参数,有效样本量须不少于“自变量个数+3”,声明的行数下限是 20;所有参与列须为定量且非常数列。
什么时候不要用它
- 只有一个因变量:用「线性回归 (最小二乘法)」,SUR 在单方程下没有任何意义。
- 自变量是定类分组,你要检验的是这几个因变量的联合组间差异:那是多元方差分析的问题,用「多变量方差分析」,它给 Wilks' Λ 等多元统计量并可放入定量协变量。
- 你关心的是两组变量之间的整体关联结构,而不是逐方程的系数:用「典型相关分析」。
- 多个因变量是同一批时间序列,且彼此还要滞后影响:SUR 只处理同期相关,用「VAR向量自回归模型」。
- 某个方程里的自变量是内生的:SUR 不解决内生性,联合估计也修不了这个偏误。用「两阶段回归」,或用「GMM 估计」。
- 各方程本应使用不同的自变量集合(这也正是 SUR 效率优势的来源):本模块强制共用同一组,实现不了。只能对每个因变量分别跑「线性回归 (最小二乘法)」,代价是拿不到跨方程的残差相关检验。
容易误读的地方
- 本模块强制各方程共用同一组自变量,据 Zellner 定理,此时 SUR 与逐方程最小二乘的结果完全相同,联合估计不产生效率增益。 卡④ 的结论文案与卡⑤ 的模型局限都把这一条写死了。核对过:演示数据里方程“月度销售额”的广告投入系数 3.7540、稳健标准误 0.4772,与在同一份数据上单独做一次带稳健协方差的最小二乘所得的系数与标准误四位小数完全一致,两个方程共八个参数无一例外。所以不要在论文里写“采用 SUR 联合估计以提升效率”——在这个设定下这句话不成立。
- 那这份报告的增量在哪?在 Breusch-Pagan 与残差相关矩阵。 它回答的是“这几个方程该不该放在一起看”。演示数据 χ²(1)=0.131、p=0.7173,非对角残差相关系数只有 0.033,报告直接判“同期相关不明显,SUR 与逐方程 OLS 近似等价”。这个不显著本身就是可以写进结论的发现:两个结果指标的意外波动各走各的。
- Breusch-Pagan 不显著,不等于两个因变量彼此无关。 它检验的只是残差的同期相关。两个因变量完全可以因为共用自变量而高度相关——那部分关联已经被 Xβ 解释掉,不会留在残差里。反过来,残差不相关也不排除滞后相关或非线性关联。把这行 p 值读成“两个结果变量互相独立”是典型的误读。
- 各方程的整体检验是 Wald χ²,照抄成 F 检验会与口径不符。 表注明确写了 linearmodels 稳健协方差下为渐近 χ²(自变量个数),非 F 分布。它只有一个自由度参数(自变量个数),没有残差自由度那一项,论文里写成“F(3, 116)=…”既错了分布也多编了一个自由度。
- 每个方程的 R² 与 Cohen f² 只描述它自己,不度量方程组整体。 卡④ 的 f² 由该方程的 R² 换算(f²=R²/(1−R²)),表注还写明它“度量的是整方程的效应量,不区分具体是哪个自变量在起作用”。演示数据两个方程的 R² 是 0.6072 与 0.4877,这是两条独立的信息,既不能取平均当成“模型组的解释力”,也不能因为一个方程拟合更好就说这套自变量整体更适合它——那要看研究问题,不是看 R² 排序。
检验只能拒绝原假设,不能证明它成立。p = 0.42 既可能是真的没有差别,也可能是样本量不够、差别没被检出来,两者从这个 p 值上分不开。规范的写法是「没有证据表明……」;要论证「两者确实相当」,需要另做等价性检验。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:各方程回归系数表
- 输出结果三:残差相关热力图
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
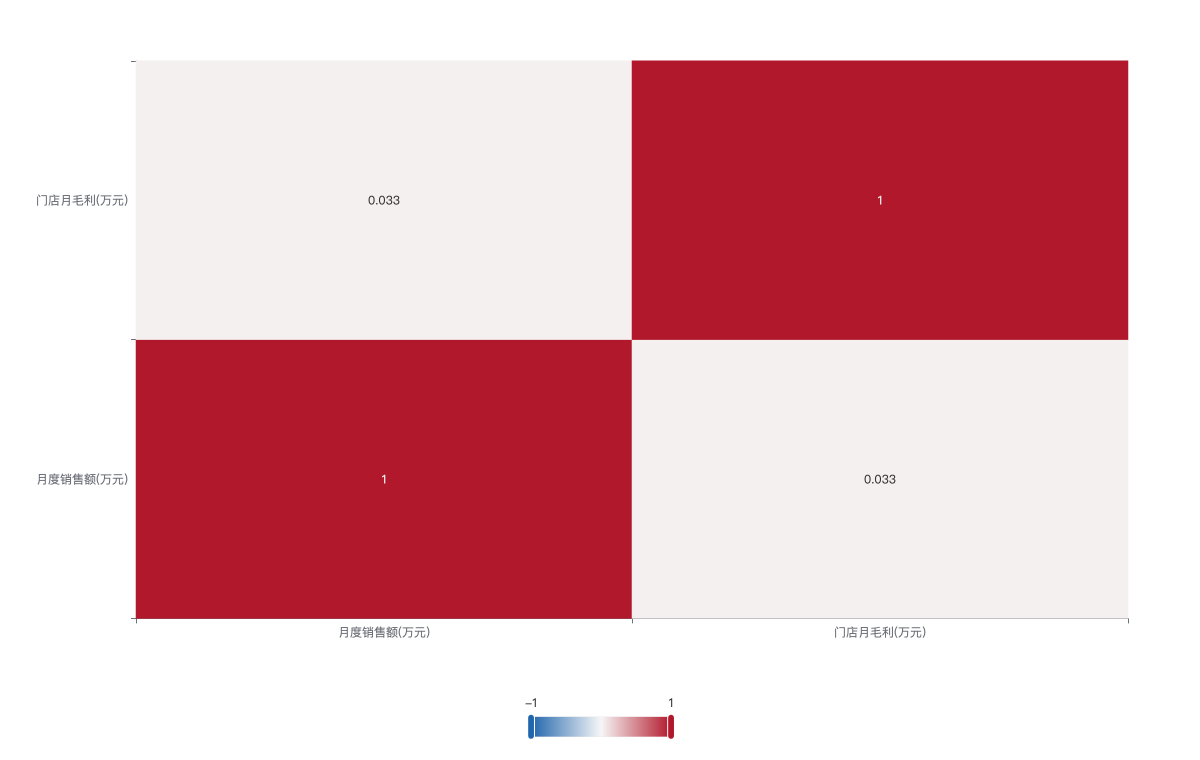
颜色越偏红/蓝表示正/负相关越强,越接近白色表示越接近不相关。可用图上方切换器在「热力图 / 表格 / 柱状图」之间切换查看同一份相关矩阵。