
PSM-DID
这个方法是做什么的
PSM-DID 把两件事接在一起:先按倾向得分在各时期内做 1:1 无放回最近邻匹配(分时期匹配是为了不破坏后面要用的 2×2 结构),再在匹配样本上估 Y ~ Treat×Post + 协变量,交互项系数就是 ATT。匹配负责让两组的可观测特征可比,差分负责扣掉共同的时间趋势与不随时间变化的个体差异——两步各治一种病,这也是它比单独做匹配或单独做差分更常被要求的原因。演示数据上 ATT = 6.4830(稳健标准误 1.0760,95%CI [4.3660, 8.6000])。
报告里“前提”占的篇幅比结果多:卡① 给倾向得分模型与伪 R²、共同支撑区间、卡钳取值与被丢弃的处理单元数、逐协变量的匹配前后标准化偏差、Rubin's B 与 R,以及匹配样本的 2×2 分布;卡③ 是 Love plot 与倾向得分分布图;卡④ 给标准化 ATT、相对效应、未匹配全样本 DID 的对照值,以及 300 次分时期随机重排处理标签的安慰剂经验 p 值。注意卡② 系数表用的是计量经济学惯例的星档——一颗星是 p<0.1、两颗是 p<0.05、三颗是 p<0.01,表注已声明,与心理学和医学期刊常用的三档不同,照抄星号进论文前先核对你投稿期刊的口径。
需要准备什么数据
- 放入[定量]结果变量 Y:1 个,定量变量(数值)
- 放入[定类]处理组 Treat:1 个,定类变量(分组/标签)
- 放入[定类]时期 Post:1 个,定类变量(分组/标签)
- 放入[定量]协变量 X (可多个):1~50 个,定量变量(数值)
数据要求
- 数据表至少 40 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「放入[定类]处理组 Treat」必须正好是 2 个类别。
- 「放入[定类]时期 Post」必须正好是 2 个类别。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 政策实施前后各有一期观测,处理组与对照组的基线特征差得明显
- 需要同时回应“两组本来就不一样”和“那段时间大家都在涨”这两种质疑
- 审稿人要求看 Love plot、Rubin's B/R 这类正式的均衡性证据
- 想知道“匹配这一步到底改变了多少”——卡④ 会把未匹配全样本 DID 的结果并排列出来
处理组变量与时期变量都必须是 0/1 二分类且各自同时含两类;处理组 × 时期的四个单元格都要有样本,最常见的失败原因是处理组只出现在政策之后;协变量必填至少一个,且必须是定量列,模块没有哑变量编码路径。
什么时候不要用它
- 有多期面板,想画事件研究图并正式检验平行趋势:本模块只有前后各一期,卡① 会把平行趋势那一项如实登记为“未做”。要检验它就得用「双重差分(DID)」,它提供事前各期交互项的联合检验与逐期动态效应。
- 只有一期截面,根本没有“前后”:差分做不起来,退回「倾向得分匹配 (PSM)」,它另给三种标准误口径与四种替代估计量的对照。
- 两组基线本来就可比:演示数据匹配前平均 |SMD| 已经只有 5.97%,匹配后 ATT 6.4830 与未匹配全样本 DID 6.3629 只差 0.1201——这时匹配这一步没做什么事,直接用「双重差分(DID)」更简洁,还能做事件研究。
- 是否受处理由一条分数线决定:用「断点回归(RD)」,它在断点邻域给出接近随机化的比较,不必依赖倾向得分。
- 担心的是没测到的混杂:匹配和差分都对付不了它,差分只能吃掉“不随时间变”的那部分。若能找到只影响处理、不影响结局的外生变量,用「两阶段回归」。
- 协变量里含定类变量:本模块不做哑变量编码,请先在数据处理里编码;若你要的只是把定类特征作为控制变量而不是匹配变量,可以直接用「面板模型」或「线性回归 (最小二乘法)」,它们能自动处理定类自变量。
容易误读的地方
- 卡钳不是越严越好。 实测把卡钳从默认的 0.2 收到 0.001:匹配率由 90.00% 掉到 6.67%(只剩 12 对),平均 |SMD| 不降反升,从匹配前的 5.97% 升到 13.08%,ATT 从 6.4830 跳到 10.2988、区间宽到 [1.0261, 19.5715],安慰剂经验 p 也从 0.0033 变成 0.0565。反方向把卡钳放到 999(等于不设卡钳),180 个处理单元全部匹配上,ATT 变成 6.3629,与完全不做匹配的全样本 DID 一模一样。卡钳要按均衡性结果调,不是按“看起来严不严”调。
- “平均 SMD 下降了”会盖住单个协变量变差。 演示数据默认设定下,企业规模的 |SMD| 由 −1.7% 变成 −4.3%,均衡性表里“偏差减少幅度”那一列是 −158.9%(负值即变差),而摘要里那句“平均 |SMD| 由 5.97% 降至 2.61%”完全看不出来。均衡性要逐行读,别只看汇总数字。
- 平行趋势在这里根本没有被检验过。 卡① 那一行的判定就是“未做”,说明写得很明确:前后各一期估不出政策前的组间趋势差,不能因为 ATT 显著就认为平行趋势成立。卡④ 的安慰剂检验也替代不了它——那一卡的结论文案专门强调,所有这些检验都无法替代平行趋势假设。这条前提只能靠制度背景与理论论证,报告里必须写出来。
- 这里的标准误在两个方向上偏小,模块自己承认了。 卡⑤ 的标准误口径说明写着:HC1 协方差把“匹配好的样本”当成给定的数据,既没计入倾向得分是估计出来的(Abadie-Imbens 2016 调整项),也没计入“哪些个体被匹配进来”本身的抽样波动。所以 p 值贴着 0.05 的结论要特别谨慎。「倾向得分匹配 (PSM)」那套 Abadie-Imbens (2006) 方差是为配对差均值推导的,对这里的回归型 ATT 不直接适用,模块选择不套用、只如实标注缺口。
- Treat 与 Post 的主效应不是政策效应。 卡② 的结论文案点明:处理组主效应刻画的是政策前两组的基线差异,时期主效应刻画的是共同时间趋势,二者本身都不能单独当作因果结论。演示数据里处理组主效应 1.8132 带两颗星(p=0.022),它说的是“试点企业本来就比非试点高 1.8”,与政策效果无关。
报告里有什么
- 输出结果一:数据概览与前提检验(均衡性与共同支撑)
- 输出结果二:PSM-DID 回归结果(ATT)
- 输出结果三:均衡性与共同支撑可视化
- 输出结果四:效应量与稳健性检验
- 输出结果五:结论与学术表述
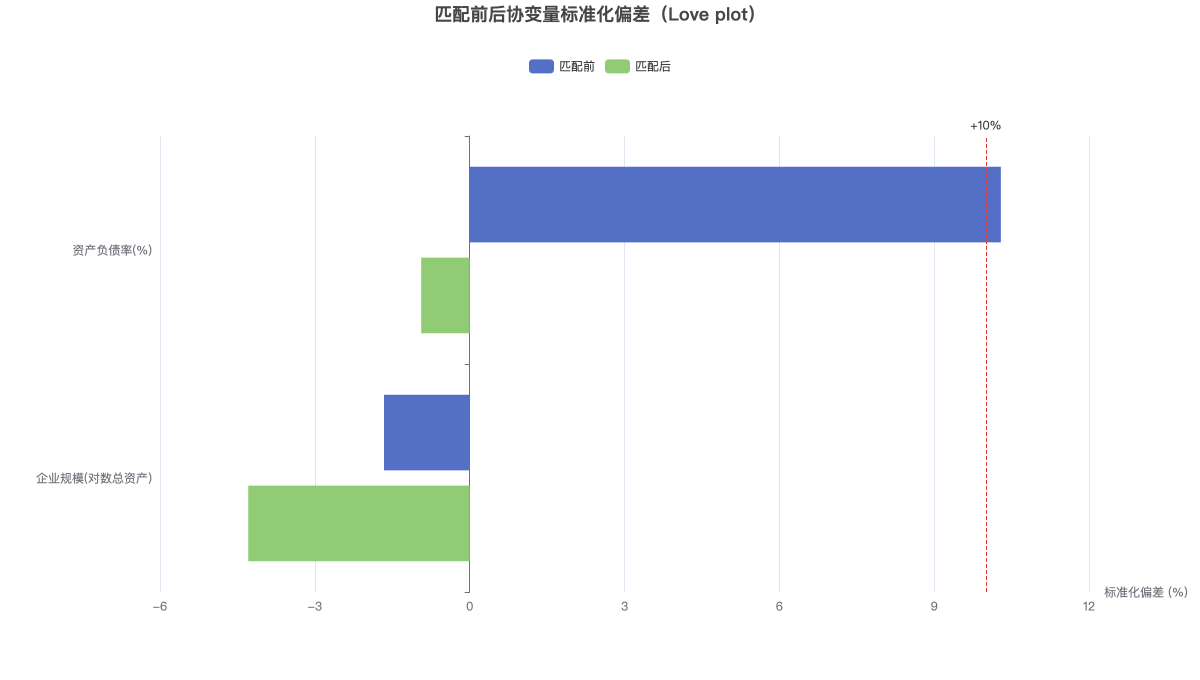
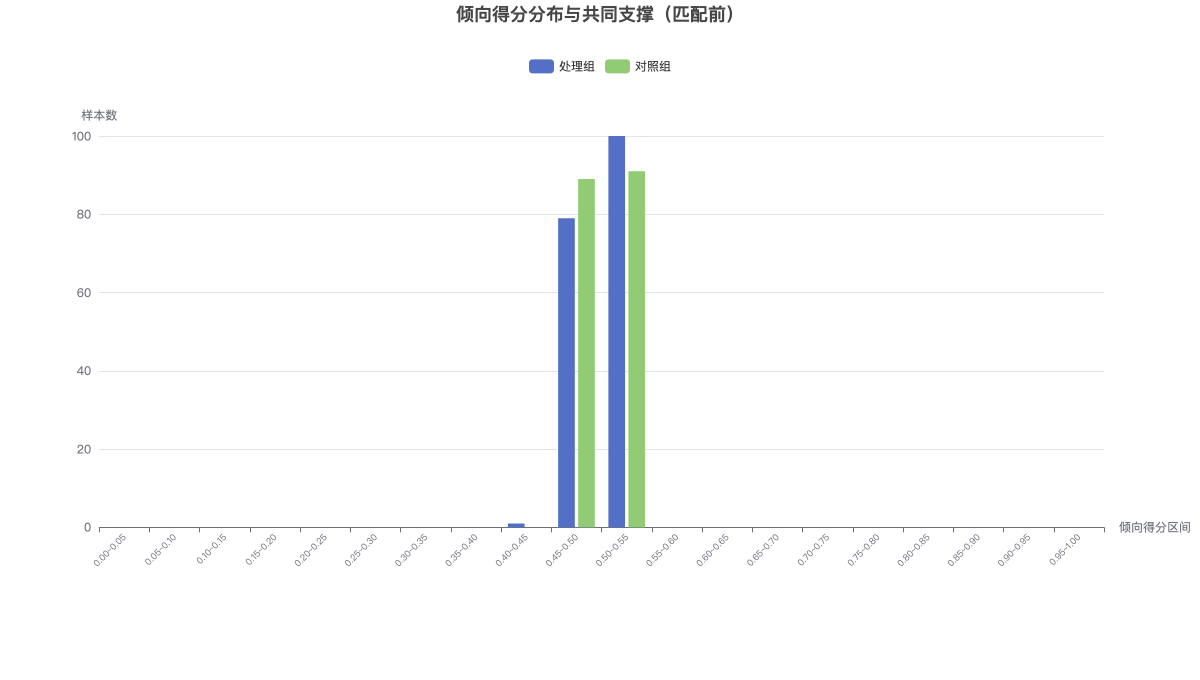
上图为 Love plot:每个协变量的匹配前后标准化偏差并排对比,红色虚线为 ±10% 参考线;下图为两组倾向得分的分布直方图,二者重叠的区域即共同支撑区。两图均可用右上角切换器切到「表格」视图读取精确数值。