
配对卡方检验
这个方法是做什么的
同一批对象被分类了两次(干预前后各判一次、同一批标本用两种方法各测一次、1:1 配对的病例与对照各记一次),问这两次的边际分布有没有变化。2×2 时就是经典的 McNemar 检验,原假设是“由 A 转 B 的概率 = 由 B 转 A 的概率”;类别多于两个时自动推广为 Bowker 对称性检验,检验整张方表关于主对角线是否对称。
检验的全部信息只来自不一致对(非对角线):示例 300 对里一致 206 对、不一致 94 对,χ²(1)=8.947 完全由 32(阳转阴)与 62(阴转阳)这两个数决定。除主检验外,报告给出不依赖大样本近似的 McNemar 精确二项检验、边际比例差及其配对口径的 Wald 区间(−0.100,95%CI[−0.162, −0.038]),以及第四张卡的 McNemar OR = b/c、Cohen's g,还有一个换角度的指标 Cohen's κ(0.356)——它衡量的是两次测量对每个个体归类得一不一致,与边际是否同质完全是两回事。
需要准备什么数据
- 配对变量1 (干预前):定类变量(分组/标签)
- 配对变量2 (干预后):定类变量(分组/标签)
- 权重变量(可选):定量变量(数值)
数据要求
- 数据表至少 10 行。
- 单列缺失率不超过 50%。
- 「配对变量1 (干预前)」的类别数需在 2~10 之间。
- 「配对变量2 (干预后)」的类别数需在 2~10 之间。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 干预前 / 干预后,同一批患者的某个指标是否阳性
- 同一批标本分别用金标准与新方法检测,两者阳性率有无系统差别
- 同一批用户在改版前后是否点击、是否付费
- 1:1 匹配的病例对照研究里,病例与对照的暴露状态是否不同
数据要摆成一行一个对象、两列分别是两次的判定结果,且两列必须使用同一套类别(端点会取并集补 0,非方表直接拒绝)。第一张卡会核查 b+c≥25 这条卡方近似判据,不足时提示以精确二项检验为主要结果。还有一个可选的频数权重区:拖入的列会被真当成“这一行代表多少个对象”,示例加一列恒为 2 的权重后配对总数由 300 变成 600。但它救不了小的汇总表——一张 2×2 汇总表只有 4 行,实测被“当前数据表共 4 行,少于配对卡方检验所需的至少 10 行”直接挡下。
什么时候不要用它
- 两列来自两组不同的对象(试验组一列、对照组一列):这是独立样本,应改用「Pearson卡方检验」;若是 2×2 且期望频数偏小,用「Yates校正卡方检验」或「Fisher精确检验」。
- 同一批对象被测了三次及以上、结果是二分类:McNemar 只处理两次,应改用「Cochran's Q 检验」。
- 两列是两位评价者对同一批对象的判定,你问的是“他们判得一样不一样”:那是一致性问题而不是边际问题,用「Kappa一致性检验」。
- 配对的两次结果是有序等级(治疗前后的轻/中/重):Bowker 只看对称性、不利用顺序,应改用「配对样本Wilcoxon检验」。
- 两次测量的是连续数值(前后血压、前后评分):用「配对样本T检验」。
- 匹配设计里还要校正协变量、或每个层里病例对照不止一对一:用「条件逻辑回归」。
容易误读的地方
- 权重列是真按人头加权的,放错一列就能凭空放大显著性。 实测:给示例每行加一列恒为 2 的权重,配对总数 N 由 300 变成 600、χ² 由 8.947 涨到 18.516、边际比例差的置信区间由 [−0.162, −0.038] 收窄成 [−0.144, −0.056],而点估计 d=−0.100 纹丝不动——效应一点没变,显著性却翻了一倍。权重区只能放“这一行代表多少个对象”的频数计数;把剂量、评分这类数值指标顺手拖进去,得到的 p 值没有任何意义。它也不校验整数(填 1.5 实测 N=450、χ²=13.730 照跑不误)。
- 一致率高不构成“不该显著”的理由。 示例总体一致率 68.67%、一致对多达 206 个,可它们一个都不进 χ² 的计算。McNemar 问的不是两次测量像不像,而是两个转变方向是不是一样多;即使 1000 对里有 990 对一致,只要剩下 10 对全是同一个方向,照样会显著。反过来,不一致对越少检验效能越低,第一张卡的“信息利用率”一行(示例 94/300 = 31.33%)就是提示这件事。
- 边际分布相同不等于个体判得一致,这是两个能各自独立成立或失败的结论。 完全可以出现“阳性率前后都是 50%、p 远大于 0.05”,而个体层面 A 转 B 与 B 转 A 各占一半、κ 低到接近 0。示例给了 κ=0.356(Landis & Koch 判为“一般”),它和 p=0.003 讲的是不同的事,报告时两个都要给,不能互相替代。
- 方向要照定义读,不要只看正负号。 边际比例差那一行把自己的定义写在了行名里:前测的阳性占比减去后测的阳性占比。示例 −0.100 表示后测的阳性占比比前测高了 10 个百分点(164/300 升到 194/300);第四张卡同时写着 32 例由阳转阴、62 例由阴转阳,两处互相印证。哪一类被当成公式里的第一类由类别取值的排序决定,换一套标签用词(阳性/阴性 换成 有/无)符号就可能反过来,所以每次都要回表头核一眼。
- 2×2 用的是 Edwards 连续性校正,不是教科书里最朴素的那个 McNemar 公式。 表注写明 χ² = (|b−c|−1)²/(b+c),比未校正版本略小、略保守。若你拿手算或别的软件的未校正结果来对,数值对不上是正常的,写论文时要说明用的是校正版;不一致对偏少时更应以精确二项检验为准(示例两者都给出 p=0.003)。
左边是同一批对象测两次,分析的是每个人自己的差值,个体差异被抵消掉;右边是两拨不同对象各测一次,分析的是两组的整体水平,个体差异留在组内。数据是哪一种,决定了该用哪一族方法——摆错了不会报错,只会悄悄换掉你在检验的东西。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:配对卡方检验主结果表
- 输出结果三:边际分布对比可视化
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
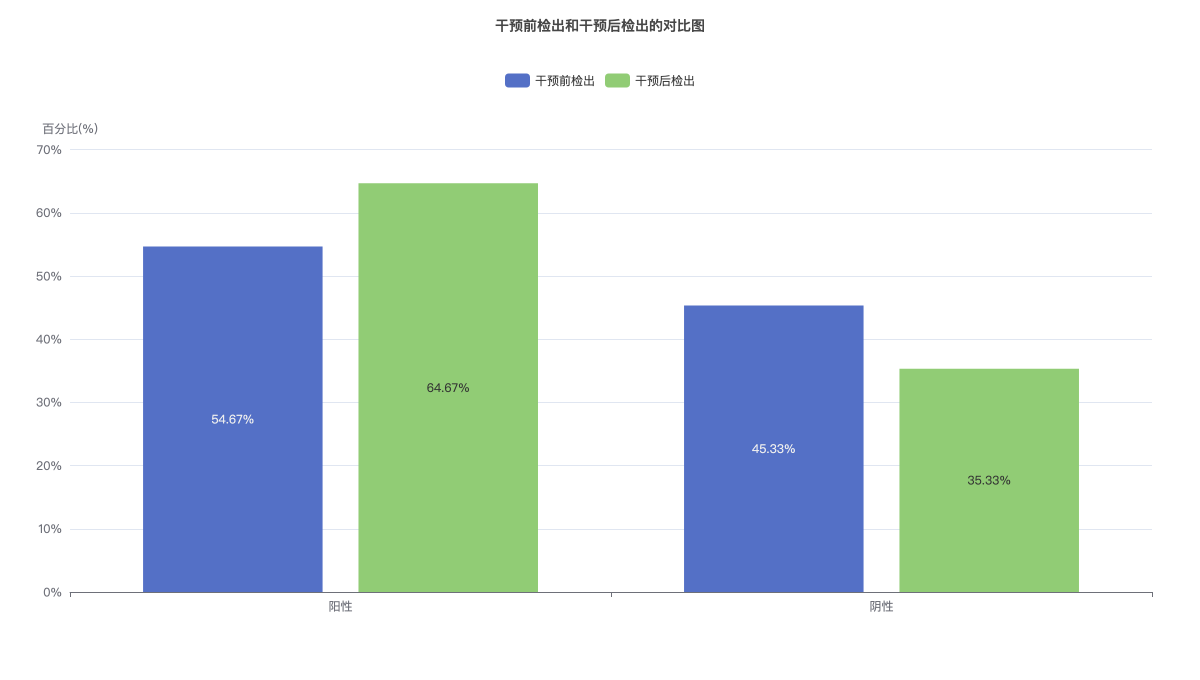
您可以通过图表上方的控件切换图表类型(柱形图/条形图),也可用右上角的视图切换器在「柱状图 / 条形图 / 折线图 / 表格」之间互切;表格视图给出各类别在两次测量下的频数、构成比与百分点变化。