
数据概览
这个方法是做什么的
一次把整张表体检一遍:多少行多少列、每一列是定量还是定类、各缺了多少、有多少个不同取值、集中趋势与取值范围是什么。核心是卡② 的三线表——一行一个变量,定量列给均值±标准差与 Shapiro-Wilk 正态性检验,定类列给众数与类别数,两类变量并排放在同一张表里。卡① 另外点名四类结构性问题:常数列、高缺失列、疑似标识列,以及完全重复的记录。
它不做任何假设检验,因而没有“显著 / 不显著”的结论;卡④ 本该放效应量的位置换成了数据质量指标——整体完整率、完全记录率、重复记录率、按 1.5 倍四分位距栅栏算的异常值占比,以及逐变量的唯一率、变异系数、偏度与峰度。卡⑤ 把这些拼成一段可以直接誊进论文“数据来源与预处理”小节的表述,并给出“这份数据是否可用”的综合判定。
数据要求
- 数据表至少 3 行。
- 本方法允许所选变量含缺失值——缺失本身就是分析对象的一部分,不会因为「完整记录不够」被拦下。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 刚拿到一份数据、还不知道它长什么样时的第一步
- 合并了多张表,或者数据是别人交接过来的:确认没有整列常数、没有重复行、没把编号列当成分析变量
- 在决定后续走参数方法还是非参数方法之前的摸底
- 论文要交代样本量、变量构成、缺失情况与异常值的识别口径
只要 3 行数据就能跑,不限变量类型,也不会因为缺失率高或存在常数列而被拦下——这些恰恰是它要如实报告的东西。需要留意的只有一条:变量是定量还是定类,优先采用前端标注的类型,未标注时按取值特征推断;若推断结果与业务含义不符,请先回前端改变量类型再重跑,不要在报告里绕过它。
什么时候不要用它
- 只关心少数几个定量变量的完整分布细节(十三个百分位数、均值的置信区间、偏度峰度的 z 值、离群栅栏区间):用「描述性统计」,本模块每个变量只给一行。
- 变量是分类的,要逐个类别的频数、占比与占比的置信区间:用「频数分析」。
- 要按组拆开看定量变量(男 vs 女、各门店):用「分类汇总」;若还要判断组间差异是否具统计学意义,两组用「独立样本T检验」、三组及以上用「单因素方差分析」。
- 要把正态性本身当成结论来报告:本模块对每个定量列只跑一次 Shapiro-Wilk,没有 Q-Q 图与 P-P 图,也不做多变量的校正,用「正态性分析」。
- 想弄清缺失是怎么产生的:本模块只报每列缺了多少、完整记录还剩多少,不判断缺失机制、也不还原缺失模式,用「缺失模式分析表」;确定要把缺失补上,再按情形选「多重插补」或「均值估计/回归插补」。
- 要看两个分类变量之间有没有关系:用「列联(交叉)分析」。
容易误读的地方
- “未检验”“不适用(定类变量)”和“不满足”是三件不同的事。 正态性那一列只对定量列执行,且要求该列有 3~5000 个有效观测且不是常数:定类列写“不适用(定类变量)”,条件不满足的定量列写“未检验”——这两种写法都不能读成“服从正态”,那一格根本没有得出过结论。反过来,写“不满足”也不必然意味着非换方法不可:Shapiro-Wilk 的功效随样本量增长,几千行数据里无关紧要的偏离也会被判显著,最终判断要连同卡④ 的偏度、峰度一起看:示例里“满意度得分”p=0.026 被判为不满足,可它的偏度只有 0.038,真正的偏离来自峰度 −0.888,也就是分布比正态更扁平,这与“均值不能用”完全是两码事。
- 变量类型是判定出来的,不是数据自带的。 用 1/2/3 编码的“部门”很容易被推断成定量变量,于是卡② 给它算均值±标准差、卡④ 给它算变异系数与偏度峰度——“部门均值 2.31”不是一个有含义的数。遇到这种行,正确做法是回前端把该列改标成定类再重跑,而不是在解读时自行忽略。
- “完全无缺失的记录数”才是后续分析真正能用的样本量。 整体完整率按单元格算,完全记录率按行算,两者可以差得很远:缺失若分散在不同行,98% 的单元格完整也可能只剩一半的完整行。回归、因子分析这类多元方法默认整行删除,用的正是这个数,而不是表头上的总行数。
- 落在 1.5 倍四分位距栅栏外的点不等于“错误数据”。 卡④ 的异常值占比按 Tukey 栅栏算,右偏分布天然就会有一批点落在栅栏外——示例里“月收入”标出 4.00%、“工作年限”2.67%,而这两个变量的质量标记恰好是“强偏态”,说的其实是同一件事。删不删取决于它是不是录入错误、是不是属于你的研究总体;因为被标出来就删,等于人为把分布削成正态。要压住极端值的影响,用「缩尾处理(Winsorize)」;想改善分布形态,用「数据变换(Box-Cox/Yeo-Johnson)」。
- “唯一率接近 100%”只有对定类变量才是“疑似编号列”的信号。 连续变量本来就几乎每个取值都不同,示例里“月收入”的唯一率 98.67%,它显然不是 ID。同理,“存在结构性问题的变量数”是一个提示计数而不是拦截:示例里那 2 个变量是因为强偏态被计进去的,它们照样可以分析,只是要换非参数方法或先做变换。把这个数读成“有 2 个变量不能用”,会白白丢掉可用信息。
报告里有什么
- 输出结果一:数据集规模与结构
- 输出结果二:变量清单三线表
- 输出结果三:类型与缺失分布可视化
- 输出结果四:数据质量指标
- 输出结果五:数据可用性结论
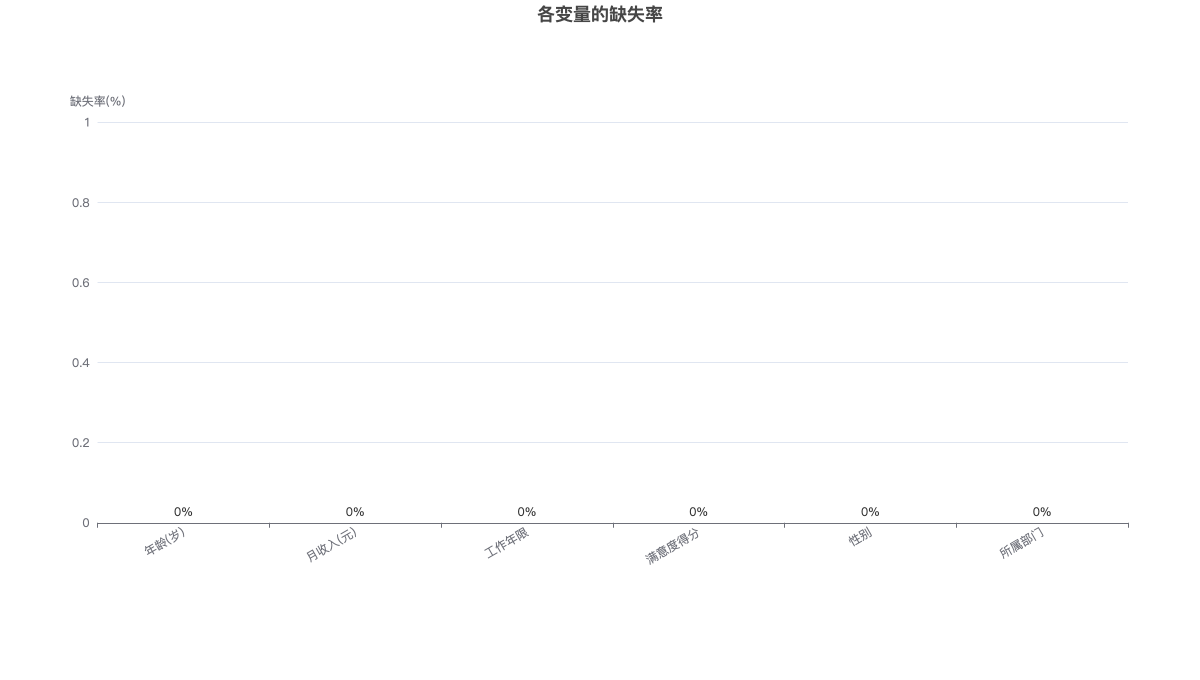
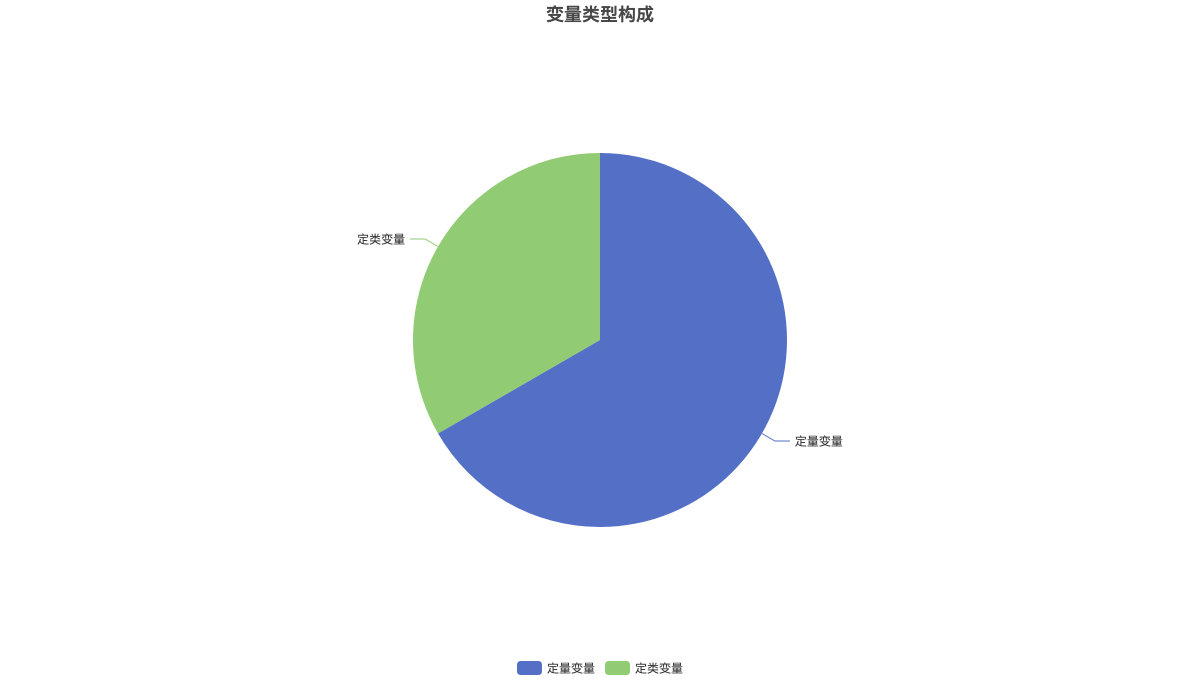
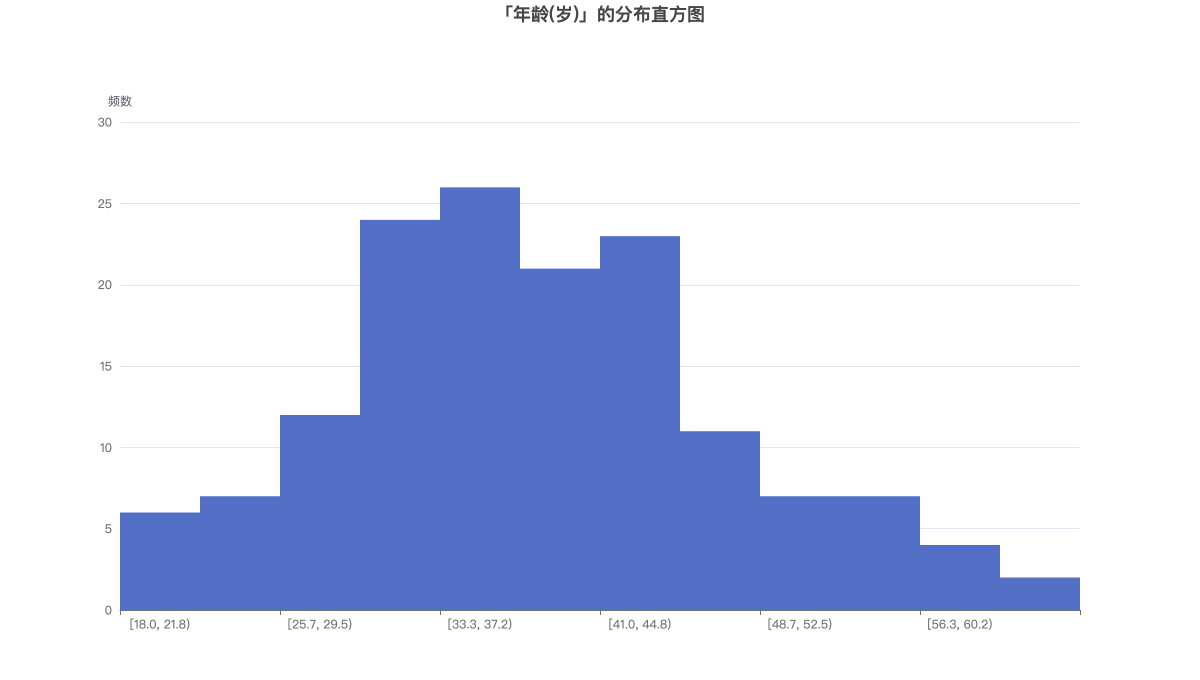
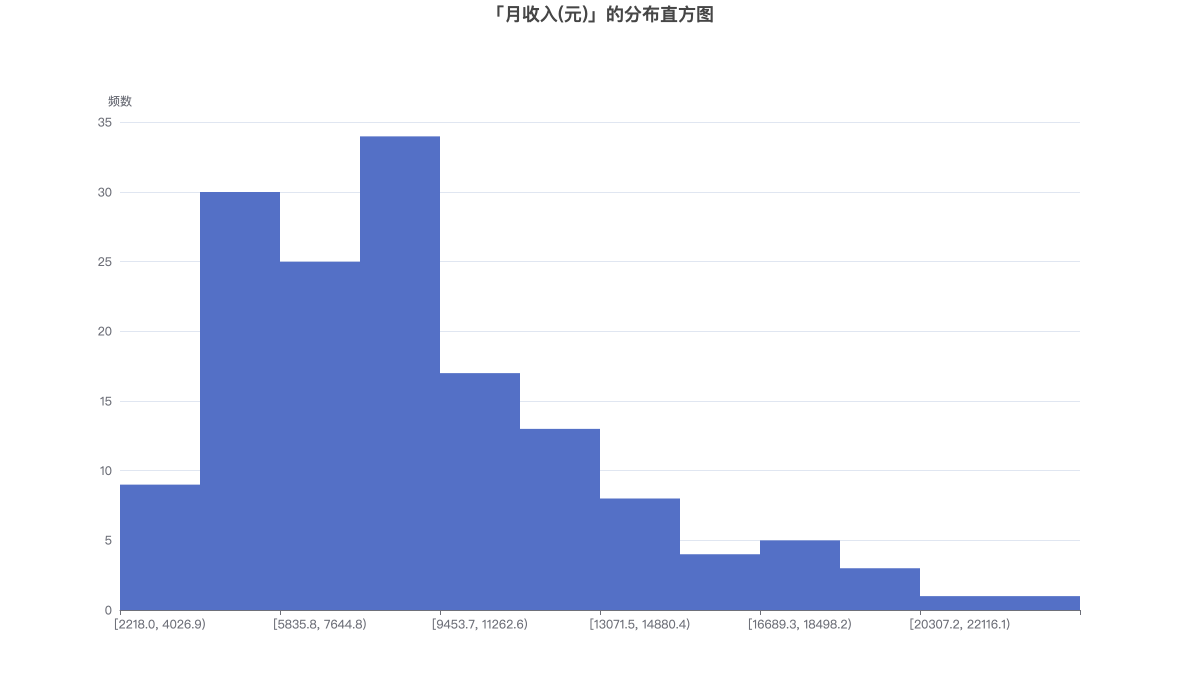
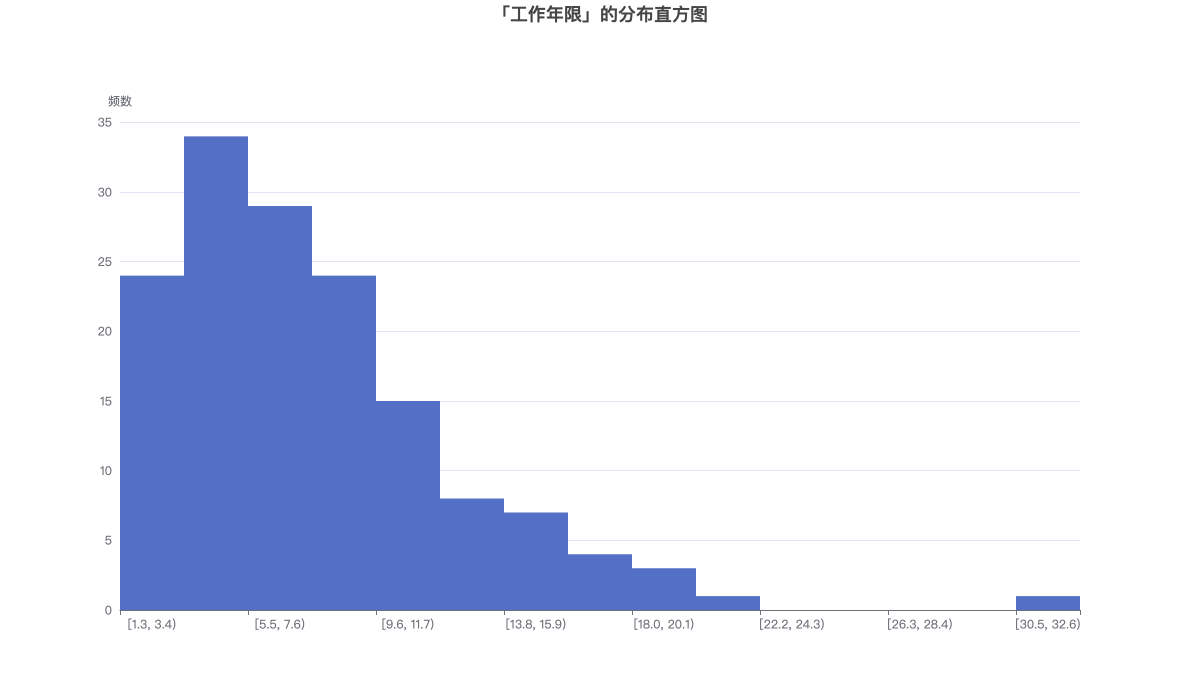
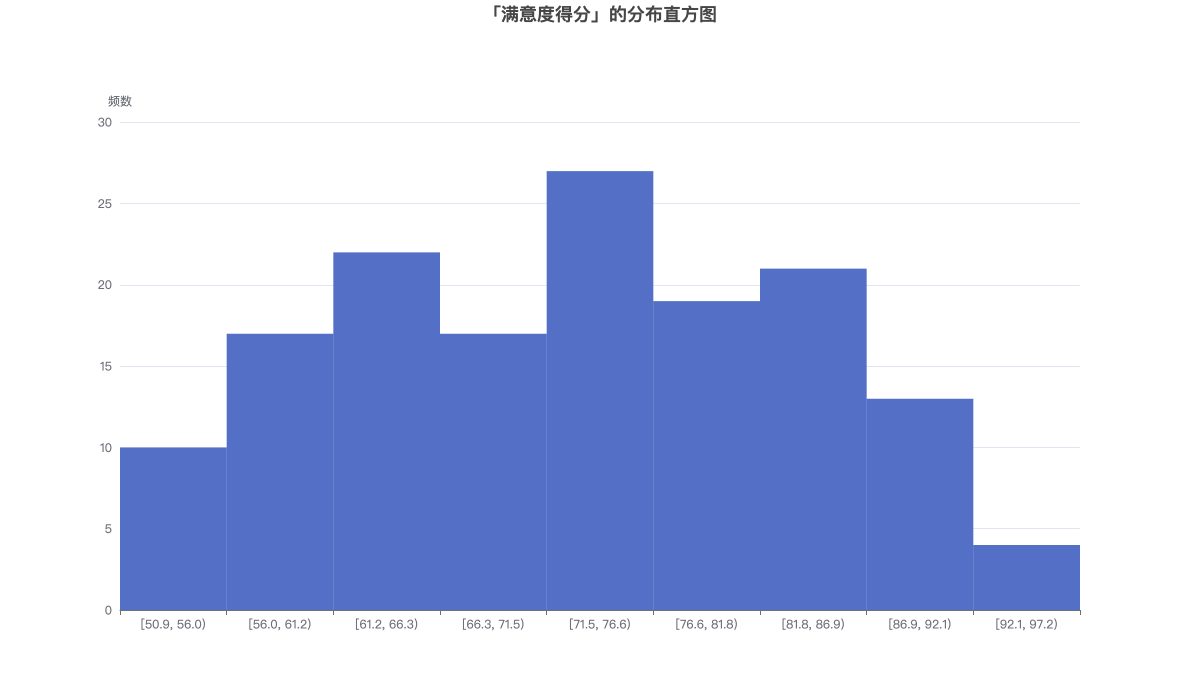
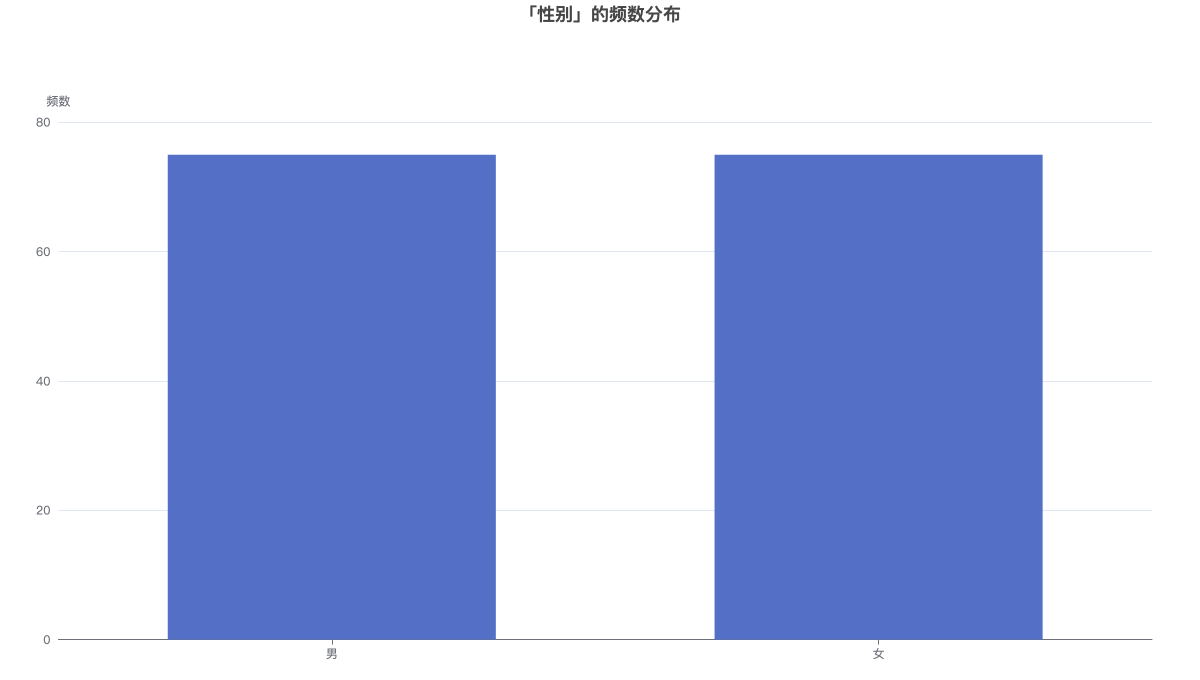
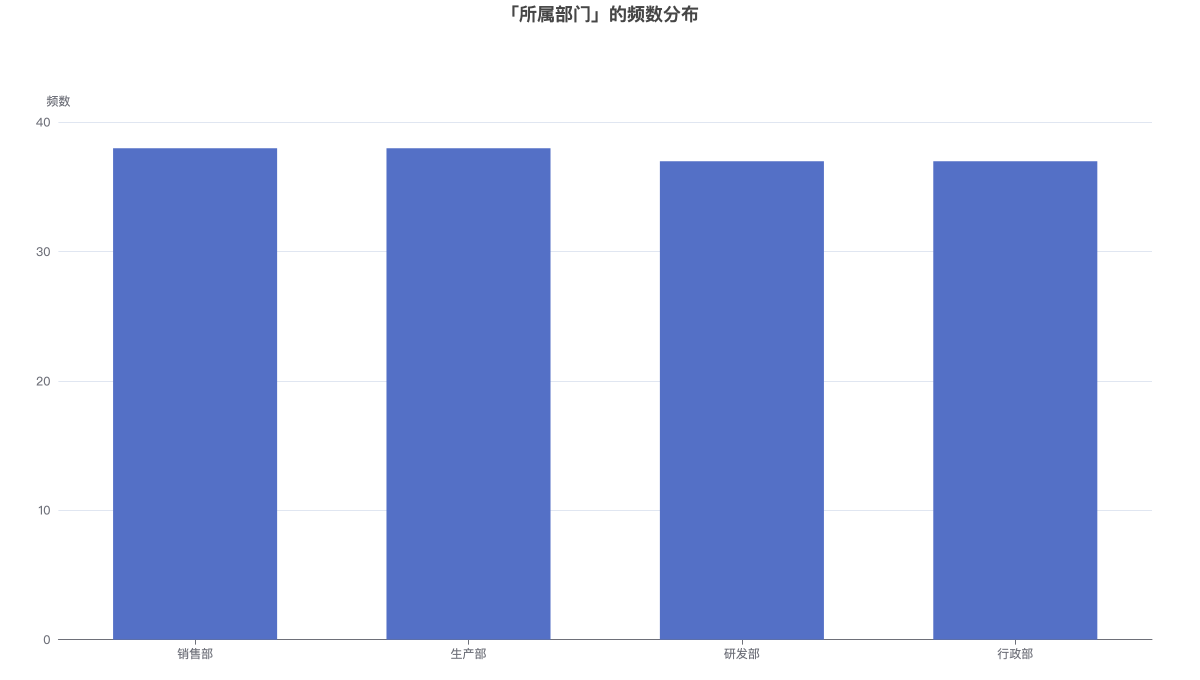
卡③ 先给出全局视角的缺失率与类型构成,再逐个变量展示分布形态与描述统计侧表。