
概率单位回归(剂量分析)
这个方法是做什么的
生物测定里的经典方法:一组剂量、每个剂量下有多少受试对象、其中多少出现了反应,据此拟合剂量与反应率的关系,并反解出“要多大剂量才能让一半对象出现反应”,也就是 ED50 / LD50。连接函数取标准正态分布的分位数 Φ⁻¹(这就是“概率单位”的由来),模型假定反应概率的正态分位数随(变换后的)剂量线性上升。
这类研究的效应量不是 p 值而是剂量本身:ED50 回答“要多大剂量”,probit 斜率 β₁ 回答“剂量变化有多敏感”(示例 1.972,倒数 0.507 即升高一个 probit 单位所需的剂量),组间相对效力回答“两种制剂谁更强、强多少倍”。报告还给完整的有效剂量路径表(1%~95% 各响应概率对应的剂量与区间)、Abbott 自然响应率校正后的逐组反应率,以及三项前提实测:剂量-反应单调性(Spearman ρ=0.978)、Pearson 拟合优度(χ²(13)=7.483,p=0.876)、异质性因子 h(0.576)。
需要准备什么数据
- 放入 [定量] 响应数变量:1 个,定量变量(数值)
- 放入 [定量] 总数变量:1 个,定量变量(数值)
- 放入 [定量] 剂量变量:1 个,定量变量(数值)
- 放入 [定类] 分组变量(可选):定类变量(分组/标签)
数据要求
- 数据表至少 3 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「放入 [定类] 分组变量」的类别数需在 1~10 之间。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 药物或农药的半数致死剂量 LD50、半数有效剂量 ED50 测定
- 消毒剂、辐照剂量等“多大强度能让多少比例失活”的效力试验
- 比较两个批次或两种制剂的相对效力(把批次拖进分组区,模型按平行线假定各给一个截距)
- 需要报告 ED10 / ED90 来刻画有效剂量跨度、评估治疗窗宽窄
数据必须是按剂量组汇总的格式:一行一个剂量组,含剂量、受试总数 n、阳性反应数 r,而不是逐个体的 0/1 记录。至少要 3 个互不相同的剂量水平(否则截距与斜率之外留不出拟合优度的自由度),响应数不得超过总数。两个控件都会实质改变结果:“数据转换”决定在原始剂量还是对数剂量上建模,“自然响应率”是 Abbott 校正用来扣除非药物本底反应的 c 值,默认 0.005 并不等于“不校正”——你的空白对照本底若不是 0.5%,应按实测值填写。
什么时候不要用它
- 数据是逐个体的 0/1 记录(每行一名受试者,暴露量与是否发生各一列):本模块吃的是汇总表,应改用「二分类概率单位回归(Probit)」,或用连接函数不同但用途接近的「逻辑回归」。
- 只有一两个剂量水平:估不出曲线,也谈不上 ED50,此时能做的只是比较组间反应率,用「Pearson卡方检验」或样本小时用「Fisher精确检验」。
- 反应是连续测量的量(抑制率、酶活力、体重变化)而不是“多少例出现了反应”:用「线性回归 (最小二乘法)」,需要曲线形状时用「拟合工具箱」。
- 反应率随剂量不单调(出现毒物兴奋效应等):probit 的单调假定不成立,模型结论无效;只能用「拟合工具箱」按多项式描述形态,但它给不出 ED50 及其置信区间。
- 你关心的是“多久发生”而不是“多大剂量”:用「Kaplan-Meier生存分析」。
- 除剂量外还要校正别的协变量:分组区只能放一个变量,应把汇总表展开成逐例数据后用「逻辑回归」建模。
容易误读的地方
- 剂量变换选错,同一份数据能从“拟合良好”翻成“完全不可用”,而模块不会替你换。 实测把示例的数据转换由常用对数改成不进行:拟合优度 p 由 0.876 跌到 <0.001,异质性因子 h 由 0.576 暴涨到 6036.838,第一批的 ED10 算出 −1.456——一个负数剂量,ED50 的置信区间成了 [−122.012, 147.568]。生物测定的剂量-反应通常只有在对数剂量上才接近 probit 线性,对数变换是常规而非可选项。看到 ED 为负、或区间跨越 0,第一件事就是回去检查这个下拉框。
- 拟合优度那一行的 p 值读法与别处相反:这里 p 大才是好事。 它的原假设是“模型拟合充分”,示例 p=0.876 表示观测频数与模型期望没有显著偏离。同一张表里剂量效应的 Wald 检验则是 p 小才显著。两行读法相反,表注专门提示过这件事,混起来读会得出与事实完全相反的结论。
- 异质性因子 h 明显大于 1 时,报告会自动把所有置信区间按 √h 放宽,于是区间宽度里混进了“模型不对”的成分。 实测无变换那次 h=6036.838、√h=77.697,第一张卡明写全部置信区间与曲线置信带都已按此放宽。这种极宽的区间不是“数据噪声大”的意思,而是模型与数据不匹配的后果;正确处置是换变换、换模型或查试验条件,不是照着那个宽区间下结论。示例正常情形 h=0.576≤1,不作修正。
- 相对效力的分子分母要看清,而且它只在平行线假定成立时才有唯一定义。 表注写明 R = ED50(基准组) / ED50(本组):示例第二批 R=1.854(95%CI[1.453, 2.365])表示第二批更强,因为它只需 3.979 就能达到第一批要 7.376 才能达到的效果。平行性检验 χ²(1)=0.000、p=0.993 支持这个前提;若平行性被拒,两条曲线的水平间距会随反应水平变化,一个 R 概括不了,必须分别报告各组的 ED50。剂量未作对数变换时“比”失去尺度依据,模块会自动改报 ED50 差值。
- 越靠近两端的 ED 值越是外推出来的,区间会急剧变宽。 示例第一批 ED50=7.376 的区间是 [6.209, 8.761],宽度约 2.5;而 ED95=50.354 的区间是 [38.580, 65.722],宽度超过 27。把 ED01 当作安全阈值、ED99 当作保证剂量报出去时,必须同时给出置信区间,否则读者会以为那个点估计和 ED50 一样可靠。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:Probit 回归主结果表
- 输出结果三:剂量-反应曲线(Probit 拟合 + 95%置信带)
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
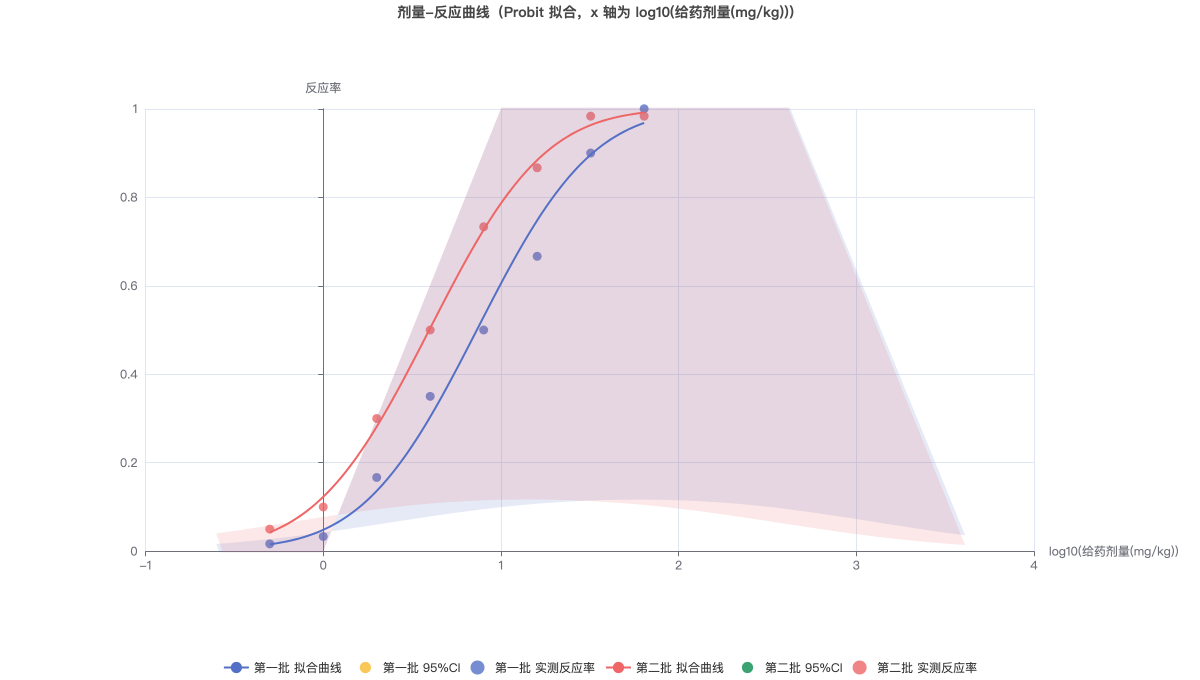
横轴为建模尺度的剂量(log10(给药剂量(mg/kg))),纵轴为反应率。散点是各剂量组的实测反应率,实线是 Probit 模型的拟合曲线,阴影为拟合值的 95% 置信带(已按 Abbott 逆变换回原始反应率尺度,与实测点同尺度可直接比对)。可用右上角的视图切换器切到「表格」查看逐组的实测率与预测率。