
支持向量回归(SVR)
这个方法是做什么的
预测一个数值型因变量,思路和这一族其它算法都不同:它先把样本用核函数映射到高维空间,再在那里找一条“管道”把数据穿起来——落在管道内(残差绝对值小于 epsilon)的样本完全不计误差,只有捅出管壁的那些样本才受惩罚,并成为决定回归函数的支持向量。所以最终模型只由少数样本撑起来,天然带正则。核函数可选 rbf、linear、poly、sigmoid,惩罚系数 C 控制对越界误差的追究力度,epsilon 决定管道多宽,gamma 提供 scale / auto 两档。定类自变量可直接拖入,管线内独热编码;不产出回归系数(linear 核也不例外,报告里没有系数表)。
报告共五张卡。主结果口径是 5 折 KFold 交叉验证:表4 给验证折 R²、RMSE、MAE 的均值、折间标准差与 95%CI,另附“训练折均值”与一次留出测试集两列,表5 是逐折明细。卡① 给建模设置与前提诊断(n∶p 比、定量特征尺度差异、VIF、因变量分布形态、疑似数据泄漏、重复观测、预处理泄漏防护);卡③ 给逐折 R² 柱状图、拟合散点与残差图;卡④ 给测试集上 20 次随机重排的置换重要性、Cohen f² 与相对均值基线的 RMSE 降幅;卡⑤ 给论文用的规范表述。本模块读表4 的顺序与树模型相反:要先看“训练折均值”的绝对水平(本次 0.4092),它偏低时落差小也不是好消息(见下)。
需要准备什么数据
- 放入因变量Y:不限
- 放入自变量X:至少 1 个
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 30%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 中小样本(几十到几千条),关系非线性,你想要一条全局光滑的预测函数而不是阶梯状的树输出
- 数据里有少量温和的噪声点,希望它们落进不敏感带里被直接忽略
- 自变量个数不多且都经过挑选,独热之后维度不会膨胀
- 只需要预测精度与变量重要性排序,不需要系数与显著性检验
前提:因变量必须是连续数值且有真实波动。有效样本量建议 ≥30,且“样本量 / 独热编码后特征维度”比值 ≥10。本模块的数据要求里另有一条:训练复杂度随样本量超线性增长,超大样本会很慢——同族别处的样本量瓶颈都压在下限,本模块的这条压在上限。所选变量上有缺失的整行会被剔除。
什么时候不要用它
- 因变量是类别:用「支持向量机分类(SVM)」。
- 样本量很大(上万条起):训练时间随样本量超线性增长,等不起;改用直方图算法、为大样本设计的「LightGBM回归」。
- 自变量里有类别数很多的定类变量:独热之后维度膨胀,核函数算出的距离被大量 0/1 列稀释,效果会明显下降;这种数据交给按变量逐层切分的「GBDT梯度提升回归」。
- 要系数、标准误与 p 值:本模块一项都不给;用「线性回归 (最小二乘法)」,自变量多且互相相关时用「Lasso回归」或「ElasticNet回归」。
- 观测之间不独立(同一对象多期、分层嵌套):交叉验证会把同一个体拆到训练折与验证折两边,R² 虚高;用「混合模型」或「面板模型」。
容易误读的地方
- “epsilon间隔”和“惩罚系数C”都作用在因变量的原始量纲上,而因变量不会被标准化。 管线里的 z 标准化只作用于自变量——卡① 表3 的“预处理泄漏防护”行列出的是“缺失中位数/众数填补 + z 标准化 + 独热编码”,对象是特征,因变量原样送进模型。所以默认的 epsilon=0.1 在示例数据里就是“0.1 万元销售额”,而因变量的标准差是 13.027,这条不敏感带宽不到标准差的百分之一,等于没起作用。反过来,若你的因变量是 0~1 的比率,epsilon=0.1 会把大半个取值范围吞进管道,模型直接退化成一条近乎水平的线。换一个因变量就必须重设 epsilon,量级参考是因变量标准差的百分之几到十分之几。
- 本次落差只有 0.0630,是欠拟合,不是泛化得好。 表4 里训练折 R²=0.4092、验证折 R²=0.3461——关键在于训练折本身也只有 0.41,模型连训练数据都没拟合上。默认 C=1 同样带因变量量纲,对一个标准差 13 的因变量来说这个惩罚太弱,模型宁可让残差留在那里。看到落差小别先高兴,要同时看训练折那一列的绝对水平:训练折高、验证折低是过拟合,两边都低是欠拟合,处理方向正好相反(前者降复杂度,后者加大 C 或减小 epsilon)。同一张表最右的“留出测试集”(0.3230)是另一次划分,种子与交叉验证已错开,不是某一折的副本;但交叉验证跑在全部 240 条上,那 48 条仍在各折的训练折里,所以它也不构成第二次独立验证。
- 和这一族其它七个模块不同,本模块可以外推——但“可以”不等于“可信”。 用默认 rbf 核时,新样本一旦远离所有支持向量,核函数值衰减到 0,预测收敛到一个常数截距,既不会像树模型那样被夹在训练集因变量的范围内,也不会沿趋势延伸;换成 linear 核则是真正的线性外推,能给出训练范围之外的数值(实测:其余自变量固定在训练集中位数、广告投入设到 1000 万元,linear 核给出 3152.86,训练集因变量却只到 98.86)。这两种行为都来自核函数的数学性质,不来自数据支持。要在训练范围外做有依据的预测,仍应回到能给出预测区间的「线性回归 (最小二乘法)」。
- 四个超参互相牵制,而产品里没有网格搜索。 核函数、C、epsilon、gamma 要一起定才有意义,gamma 还只给了 scale 和 auto 两档、不能填数值。本模块只能手工改一个参数、重跑一次、比较表4 的“交叉验证均值”。这里有个容易忽略的坑:用交叉验证 R² 反复挑参数,挑出来的那个数字本身已经乐观了,因为选择和评估用的是同一批数据。参数定下来后最好在一批全新样本上复核,或者拿超参更少的「随机森林回归」做个对照。
- 三个变量都“稳健贡献”,不代表它们有因果作用。 本次卡④ 三个自变量的置换重要性 95%CI 下限都大于 0(ΔR² 依次 0.2349、0.1505、0.1038),三者之和 0.4892 明显大于模型在留出测试集上的 R²(0.3230)——ΔR² 不是把 R² 切成几份,而是各自独立地问“打乱这一列模型掉多少”,加起来没有意义。卡④ 的说明也逐字写着它“不是因果效应,也不等价于线性回归中的系数显著性”;整份报告不含任何针对自变量的 p 值。需要系数与显著性检验,请用「线性回归 (最小二乘法)」。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:主结果表(交叉验证性能)
- 输出结果三:可视化(逐折性能 / 拟合散点 / 残差)
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
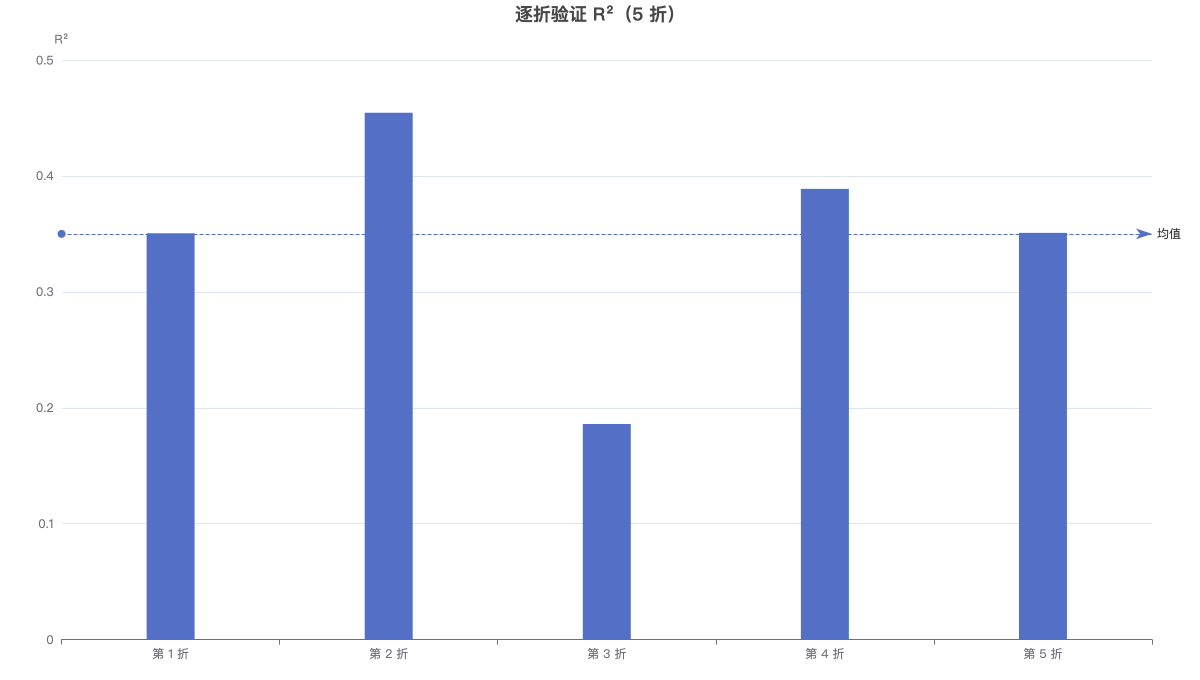
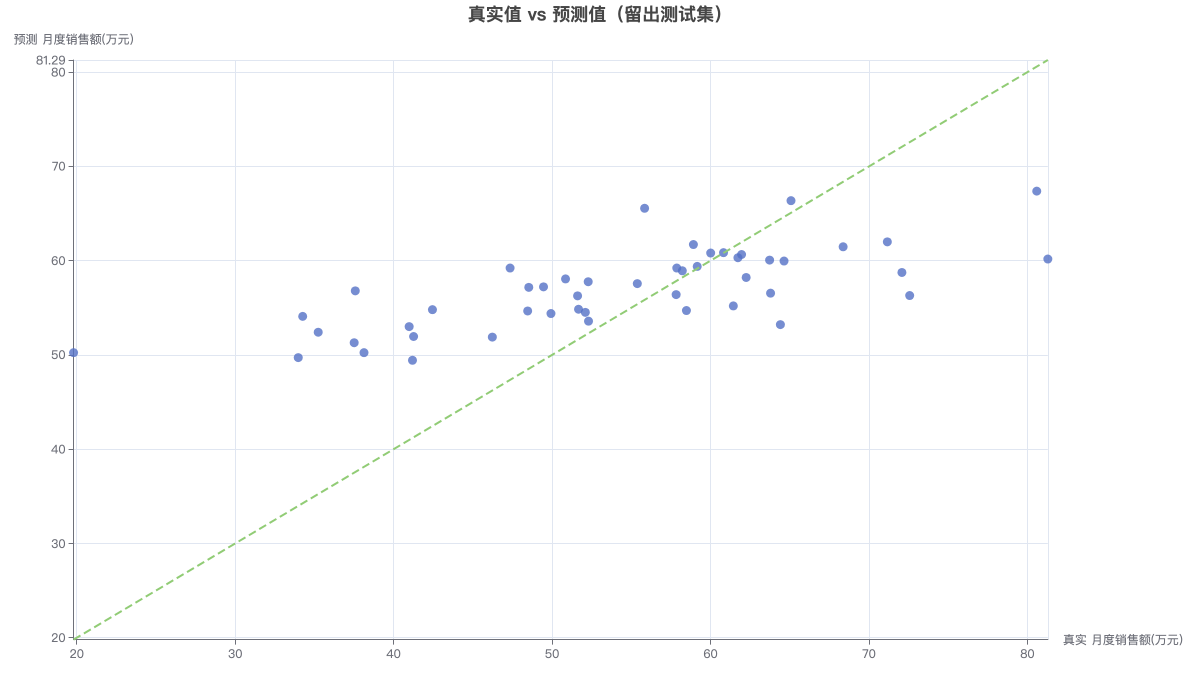
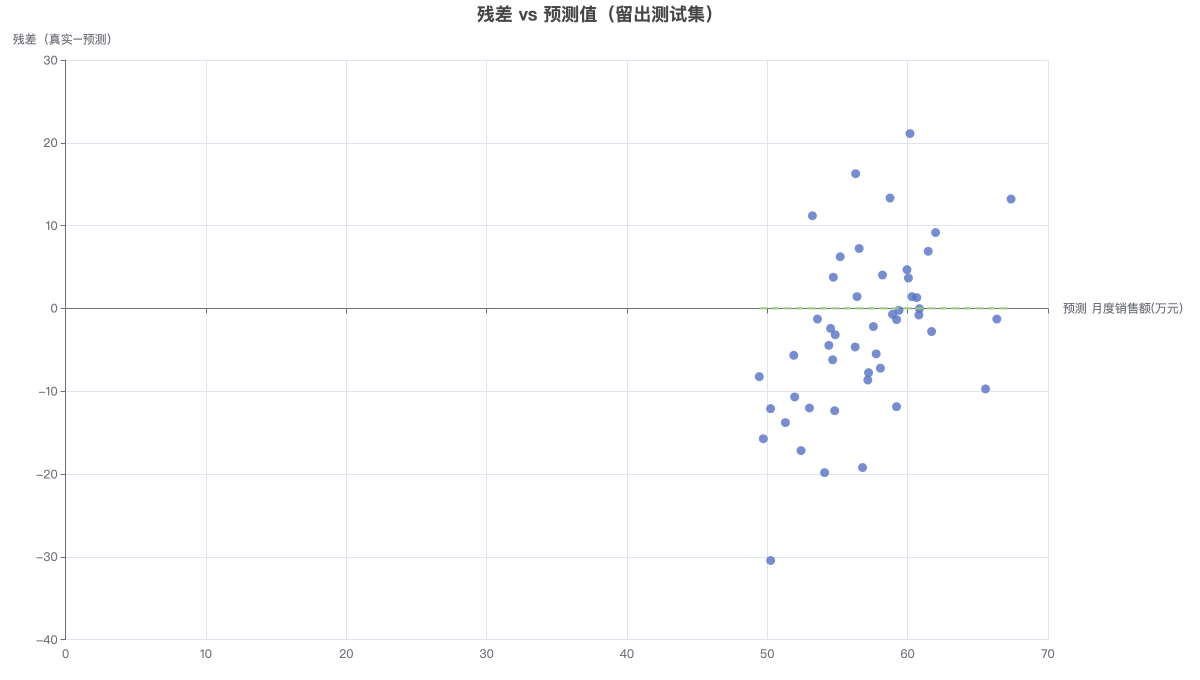
三张图分别回答:模型在不同数据划分下稳不稳(逐折 R²)、预测值贴不贴近真实值(散点)、误差是否随预测水平系统性变化(残差图)。