
两比例(率差)功效
这个方法是做什么的
回答“要检出两组之间的事件发生率差异,每组需要多少人”,以及“现有这两组人,检出这样的率差把握有多大”。拖入 1 个恰好两水平的分组变量和 1 个二分类结局变量,控件里只填显著性水平 α(默认 0.05)。效应量不是率差本身,而是两比例专用的 Cohen's h = 2·arcsin√p₁ − 2·arcsin√p₂——先做角变换再相减,这样在率接近 0 或 1 时比直接的率差稳定;惯例是 |h| ≈ 0.2 小、0.5 中、0.8 大。
卡① 摆三张表:两组的事件数、样本量、事件率及其 Wilson 得分法 95% 置信区间;正态近似适用条件的逐组核对(每组 np 与 n(1−p) 是否都 ≥ 5);以及前提检验表,其中包括“两组事件率不相同”这一行——率完全相等时 h = 0,所需样本量发散,给不出有限的建议。卡② 给事后功效与达到 80% / 90% 功效所需的每组人数。卡③ 是功效随每组样本量变化的曲线。卡④ 给四张表:MDES(|h|) 及其换算成的可检出 p₂ 范围、α 三档对照、1:0.5 / 1:1 / 1:2 三种分配比的人数需求、按 ×0.5 / ×0.75 / ×1.25 缩放率差的情景。卡⑤ 是速览表与论文表述。引擎是 statsmodels 的 NormalIndPower(正态近似,双侧)。
需要准备什么数据
- 放入[定类]分组变量:1 个,定类变量(分组/标签)
- 放入[定类]二分类结局:1 个,定类变量(分组/标签)
数据要求
- 数据表至少 20 行。
- 单列缺失率不超过 30%。
- 「放入[定类]分组变量」必须正好是 2 个类别。
- 「放入[定类]二分类结局」必须正好是 2 个类别。
- 「放入[定类]分组变量」的每一组至少 2 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 设计随机对照试验,主要结局是“有效 / 无效”,论证两组各收多少例
- 疫苗、器械或营销 A/B 试验的转化率比较,估算每组曝光量
- 已有两组率,想知道现有规模能检出多大的率差
- 对照组资源受限只能按 1:2 招募,看总样本量要多付出多少
- 用预实验的两组率做保守情景规划,为正式方案定例数
前提有三条:两组相互独立;结局必须恰好二分类,多于两类得先归并;每组的期望事件数与期望非事件数都不能太少。最后一条决定正态近似能不能用,卡① 第二张表会逐组把 np 与 n(1−p) 算出来,任一个小于 5 就明确标为不满足。
什么时候不要用它
- 分组多于两个、或结局多于两类:用「卡方检验(独立性)功效」,它按 Cohen's w 处理任意行列的列联表。
- 结局是连续数值而不是“是否发生”:用「两独立样本t检验功效」。把连续结局人为砍成二分类再用本模块,会丢掉大量信息、抬高所需样本量。
- 同一批对象在前后两个时点各测一次二分类结局:那是配对数据,检验用「配对卡方检验」。产品没有它的功效模块,按两独立比例算会低估配对设计的效率。
- 任一组的 np 或 n(1−p) 小于 5(罕见结局最容易踩):正态近似失效,卡② 与卡④ 的数都不能用,检验应改用「Fisher精确检验」;产品没有精确功效模块,此时只应报告“样本量不足以支撑近似”。
- 检验的是单组率是否等于某个给定值:那是单样本问题,用「二项式检验」,本模块要求恰好两组。
- 关心的是调整协变量后的 OR 而不是粗率差:分析用「逻辑回归」。产品没有它的功效模块,本模块的每组人数只能当作未调整情形下的粗略下限。
容易误读的地方
- h 不是率差,“检出 5 个百分点的差”这句话本身不完整。 角变换把接近 0 和 1 的区域拉开了:从 0.05 涨到 0.10 对应 |h| ≈ 0.19,而从 0.45 涨到 0.50 同样是 5 个百分点,|h| 只有约 0.10——所需样本量与 h² 成反比,后者大约是前者的三到四倍。所以规划时必须同时说清基线率和目标率,只给一个率差没法算。卡④ 把 MDES 换算成“可检出的 p₂ 范围”时给的是两段(本例以 p₁ = 0.6000 为基准,p₂ 要低于 0.3474 或高于 0.8270),而不是围绕 p₁ 对称的一个区间,原因正在这里。
- 事后功效 0.7328“偏低”,不是“再补几个人就能显著”的理由。 本模块只有 α 一个控件,h 只能由这两组观测率算出,于是事后功效与率差检验的 p 值由同一份数据唯一决定,一一对应。功效低就等于 p 大,是同一件事的两种说法,拿它论证“样本量不够所以没做出来”是循环论证。该问的是卡④ 的问题:当前样本量在 80% 功效下只能检出 |h| ≥ 0.5115,也就是 p₂ 低于 0.3474 或高于 0.8270——你在专业上关心的那个率,落在这个可检出范围里吗?
- 卡② 的“71”是每组 71,合计 142。 表注写明所需样本量是等组设计(ratio = 1)下的每组人数;卡④ 的 α 敏感性表干脆把“每组 × 2 = 合计”写进了单元格。同一张卡里还有两个口径:事后功效按你数据的实际分配比算,达标人数按等组算,两组人数悬殊时并排读会打架。分配比表也不是“1:2 省人”的意思——本例 1:1 合计 142,1:0.5 合计 161,1:2 合计 162,等组在总量给定时功效最高。
- 两个置信区间口径不同,别混着比。 卡① 单组率的 95% CI 用 Wilson 得分法(小样本与极端率下比 Wald 更可靠,且天然落在 [0,1] 内);率差的 95% CI 则是 Wald 法并截断到 [−1, 1]。二者不是同一套方法,看到“两组率的区间有重叠”也不能据此断定率差区间一定跨 0。
- 规划下一次研究,用率差的置信下限,别用点估计。 卡④ 的结论文案原话就是这个:本例观测率差 0.2333,95% CI [0.0595, 0.4072],按点估计每组 71 人,按 ×0.5 的保守情景(p₂ 从 0.3667 抬到 0.4833)就要每组 285 人,差四倍。观测率是有噪估计且倾向被高估,正式论证该代入的是文献里的对照组率加上专业上认可的最小有意义率差,不是这次数据自己算出来的那一对率。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:功效与所需样本量
- 输出结果三:功效曲线(功效随每组样本量变化)
- 输出结果四:敏感性分析(MDES 与 α/分配比/率差敏感性)
- 输出结果五:结论与样本量报告表述
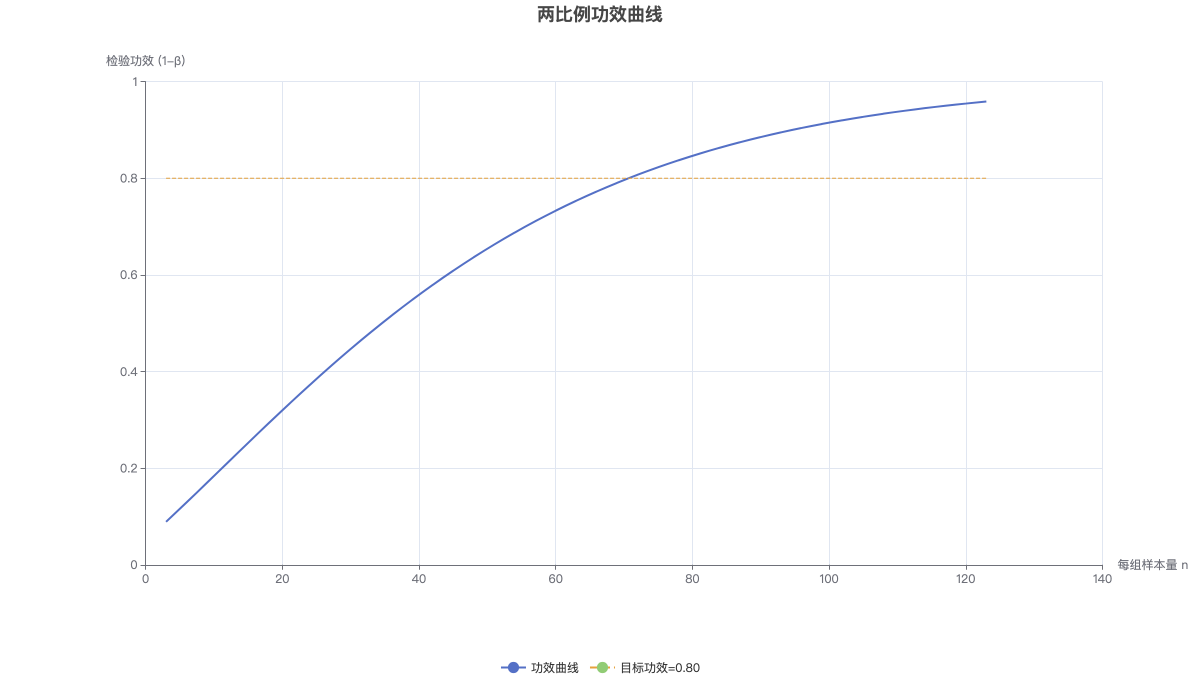
横轴为**等组设计下的每组样本量**,纵轴为在观测效应量 |h| = 0.4713、α = 0.050 下的检验功效 (1-β),橙色虚线为 0.80 目标功效参考线。可用右上角切换器切到「表格」逐点读数。