
交叉分析【单选&多选】
这个方法是做什么的
拿一个分组变量(性别、学历、渠道这类单选题)去横扫一道多选题的各个选项,回答“不同人群在这道多选题上的选择偏好是否不同”。单选变量只能放 1 个,多选项至少 2 列且必须是 0/1 编码。它不对整张共现表做一次卡方——那会让同一位受访者被重复计数——而是把每个多选项还原成“未选/已选 × 各类别”的 2×C 列联表逐项检验,每位受访者在每张表里恰好计入一次。
主结果表给出逐项的 χ²、df、p 与 Holm 校正后的 p(族系是这个单选变量下的全部多选项),2×2 表默认施加 Yates 连续性校正,最小期望频数不足 5 时自动改用 Fisher 精确检验。卡④ 给关联强度:Cramér's V 及其 95%CI、Bergsma 偏倚校正 V,单选变量恰为 2 类时另给 φ 与优势比 OR。卡③ 除交叉汇总图外还画“已选”格的调整标准化残差热力图,卡④ 对 Holm 校正后整体显著的表做逐格事后定位。
需要准备什么数据
- 单选题(分类变量):定类变量(分组/标签)
- 多选题(0/1变量):至少 2 个,定类变量(分组/标签)
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「单选题(分类变量)」的类别数需在 2~20 之间。
- 「多选题(0/1变量)」必须正好是 2 个类别。
- 「单选题(分类变量)」的每一组至少 5 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 问卷报告里“男性和女性的购买考虑因素有什么不同”这类交叉分析
- 一个人口学变量对一道多选题的全部选项批量扫描,并需要控制多重比较
- 需要关联强度而不只是显著性(Cramér's V、φ、OR 及其置信区间)
- 需要定位到具体是哪个类别在哪个选项上偏离了独立期望(逐格残差)
前提:单选变量须为定类,2~20 个类别、每个类别建议至少 5 个观测;多选列必须恰为 0/1,且每个选项都要既有人选中又有人未选中(全选或全不选的列无变异,构造不出 2×C 表);同一列不能同时放进两个区;数据表至少 30 行。类别数超过 20 会让期望频数普遍偏低,应先在“数据处理 → 标签”里归并低频类别。
什么时候不要用它
- 要同时用好几个分组变量交叉这道多选题(性别、会员等级一起看):本模块的单选区只收 1 个,用「交叉分析【多选&单选】」,它的单选区可以放多个,并按每个单选变量分别划分 Holm 族系。
- 两边都是多选题(购买考虑 × 期望改进):用「交叉分析【多选&多选】」,它把每一对选项还原成受访者层面的 2×2 表。
- 两边都是单选题:不涉及多重响应,一个行变量扫多个列变量用「列联(交叉)分析」;只做一对且要看逐格期望频数用「卡方检验」;期望频数不足的 2×2 表用「Fisher精确检验」。
- 只想看这道多选题自己的分布,不涉及分组:用「多选分析」,它给普及率与响应率、Cochran's Q 主检验与选项间的两两比较。
- 分组变量是定量的(年龄、收入、消费金额):本模块只接定类变量,要么先分箱成类别,要么以“是否选中某一项”为因变量做「逻辑回归」,直接估计连续自变量的效应。
容易误读的地方
- 表里的百分比是列百分比,分母是那一类人的总数,不是选中该项的人数。 示例中“购买考虑-价格实惠”那格写着 62 (62.00%),意思是 100 位女性中有 62 人选了它。同一列各行的百分比相加不等于 100%(示例“女”这一列四项相加是 185%),因为一人可多选。如果你想要的是“选了这一项的人里男女各占多少”,那是行百分比,本模块的表不给,要换到「交叉分析【多选&单选】」——它的交叉表正是那个口径。
- φ 与 OR 的负号是方向不是强度,方向锚在哪一类上写在表注里。 表注说明方向按“已选 × 女”定义:φ>0、OR>1 表示“女”选中该项的比例与优势高于“男”。示例“购买考虑-售后完善”的 φ=−0.261、OR=0.341,读作“女性明显更少选它”,而它恰恰是四项里关联最强的一项——|φ| 就等于这张表的 Cramér's V=0.261。把负号当成“关联很弱”是常见的读反。
- Cramér's V 的置信区间下限经常是 0.000,那不能读成“没有关联”。 区间由观测 χ² 反解非中心 χ² 得到并截断到 [0,1],而样本 V 本身有正偏倚:示例前三项的 V 分别是 0.101、0.142、0.130,下限却都是 0.000。表注给的处理办法是此时改看偏倚校正 V(对应为 0.072、0.123、0.109)。关联的有无以 Holm 校正后的 p 为准,不以区间是否碰到 0 为准。
- 逐格残差表里没出现的选项,不等于“它没有任何格子偏离期望”。 表注写明:只对 Holm 校正后整体显著的 2×C 表做逐格事后分析,整体不显著时逐格解读会大幅抬高假阳性。示例中只有“购买考虑-售后完善”进了这张表(4 个格子全部显著)。另外 2×C 表里“未选”行的残差与“已选”行大小相等、符号相反,热力图只画“已选”行就是因为另一行是冗余信息,不是漏画。
- 四次检验共用同一批受访者,不能当成四个独立结论。 Holm 校正控制的是“同一单选变量下全部多选项”这个族系的错误率,但同一位受访者在 4 个选项上都作了答,各次检验彼此相依。卡⑤ 的解释边界原文提示:各项检验结果应作为一组线索整体解读,而非彼此独立的证据。所以“4 项中 1 项显著”不能反推出某个独立的发现率,也不能据此说“另外三项证明没有性别差异”。
报告里有什么
- 输出结果一:样本、编码合规性与期望频数前提
- 输出结果二:交叉列联表与独立性检验(主结果表)
- 输出结果三:交叉汇总图与残差热力图
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
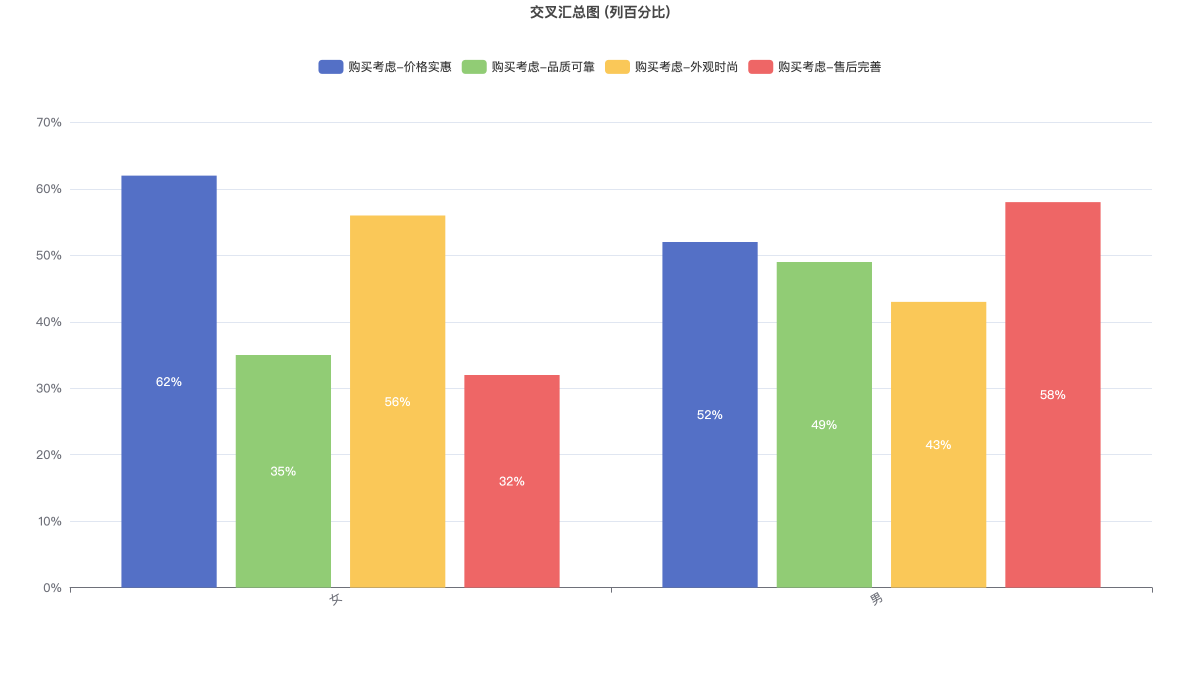
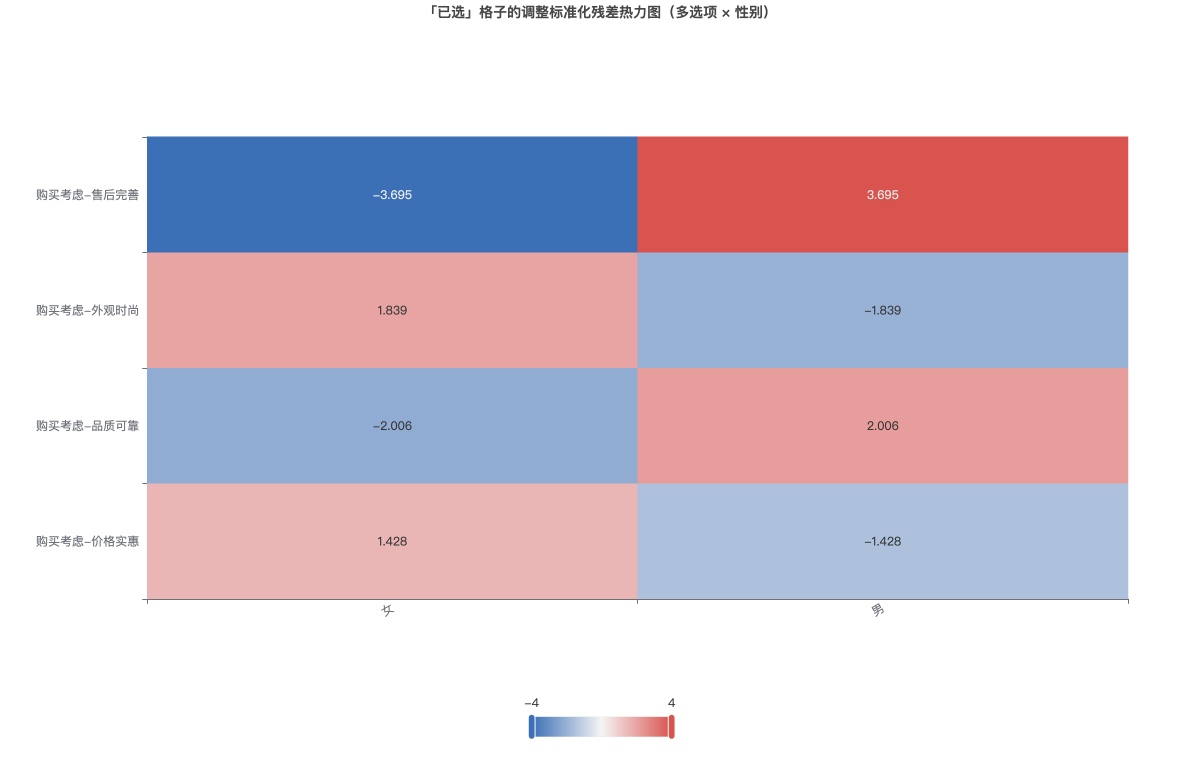
上图可通过下拉框切换指标(百分比/频数)与图表形态,也可用右上角视图切换器在柱状图、条形图、折线图、雷达图与表格之间切换。下图为各多选项「已选」格子的调整标准化残差热力图:红色表示该类别选中此项的人数显著多于独立假设下的期望,蓝色表示显著少于期望,|z|>1.96 对应未校正的 p<0.05。