
Cochran's Q 检验
这个方法是做什么的
同一批被试在 3 个及以上条件或时点上,各被记录了一个“是 / 否”型结局,本检验问的是这几个条件下“是”的比例是不是全都相等。数据摆法是一行一个被试、一列一个条件,同一行的几个取值来自同一个人——这正是它与「卡方检验」的分界:那边比的是不同的人分在不同组,这边比的是同一批人在不同条件下。
除了整体的 Q、df 与 p,报告还给 Kendall's W 和“最大阳性率差”两个效应量;卡④自动把 k(k−1)/2 对全部做一遍事后 McNemar 精确检验,附 Holm 校正 p、配对优势比 OR 及其 95% 置信区间;卡①除了各列的阳性率,还会告诉你有多少行其实没提供信息,以及 N·k 是否达到卡方近似所需的 24。
需要准备什么数据
- 放入配对的 [二分类] 变量:至少 3 个,定类变量(分组/标签)
数据要求
- 数据表至少 8 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「放入配对的 [二分类] 变量」必须正好是 2 个类别。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 同一批患者在用药前、用药 1 周、用药 4 周三个时点的“有效 / 无效”
- 同一批受访者对 3 个及以上方案分别回答“会买 / 不会买”
- 同一批样本用 3 种试剂各测一次的“阳性 / 阴性”
- 同一批学生在 3 套试卷上的“通过 / 未通过”
- 多选题里各选项的勾选率是否一致(同一个人对每个选项都有一个 0/1)
前提是:每一列都恰好两个取值;不同被试之间互相独立(同一行内不独立,正是本方法要利用的东西);含缺失的行整行剔除。它与「配对卡方检验」是推广关系——k=2 时 Cochran's Q 就等于不带连续性校正的 McNemar 卡方,所以本模块直接要求至少 3 列,两列的情形不必绕到这里来。
什么时候不要用它
- 各列来自互不相同的被试(三组人各自的合格率):那是独立样本的比例比较,用「卡方检验」。
- 只有两个配对条件:用「配对卡方检验」,结果与 Q 等价且更直接。
- 结局多于两类或是有序等级(无效 / 好转 / 治愈):用「多配对样本Friedman检验」。
- 结局是连续数值的重复测量(三个时点的评分):用「重复测量方差分析」。
- 只有一个二分类变量,想看它的比例是否等于某个理论值:用「二项式检验」。
- 需要同时控制协变量,或各被试的观测次数不一致:Q 做不到,用「广义估计方程(GEE)」。
容易误读的地方
- 哪一类被记成“1”是按取值的文本排序自动定的,不看语义。 每一列各自把两个取值排一次序,排在后面的那个记为 1。“是 / 否”“有效 / 无效”正好排对,但“阳性 / 阴性”会把阴性记成 1。若各列编码一致,全体反过来并不改变 Q 与 p,只是卡①、卡③里的“阳性率”实际是阴性率,方向解读整个反掉;若只有部分列反了(一列写“是/否”、另一列写“阳性/阴性”),各列的“1”根本不是同一件事,Q 值本身就错了。动手前把所有列统一成同一套编码。另外,卡①表头上的“1”标签取自第一个变量的映射,各列编码不一致时这个标签也在骗你。
- Q 显著只说明 k 个阳性率不全相等,不说明它们在单调变化。 样例的 31.67% → 43.33% → 75.00% 看着像一路上升,但 Q 对列的先后顺序完全不敏感——把三列打乱重排,Q 一分不变。想论证“随时点递增”需要另做趋势检验——卡⑤会提示 Cochran-Armitage,但产品未提供该方法,本模块不提供、菜单里也找不到;退而求其次的可执行路径是把有序条件两两拆开、逐对看卡④的 McNemar 精确检验是否同向,或退回描述性的比例趋势图。Q 的星号替代不了趋势检验。
- 全 0 或全 1 的行对 Q 没有任何贡献。 这些被试在 Q 的分子与分母里相互抵消,所以卡①专门列了一行“有效信息行数”。样例中 N=60,其中 5 行全 0、12 行全 1,真正提供信息的只有 43 行。结局发生率很低或很高时,绝大多数行都是全 0 或全 1,此时 N 看着很大而检验效能极低。看到 N 大却不显著,先看这一行再下结论。
- 事后比较要看 Holm 校正那一列,而且每一对的有效样本远小于 N。 k 个条件有 k(k−1)/2 对,多比一次就多一分假阳性风险,卡④因此并排给出原始 p 与 Holm 校正 p。同时要注意 McNemar 只用“不一致对”:两个条件都阳性或都阴性的被试完全不参与计算——样例里 N=60,而“用药前 vs 用药 1 周”这一对的不一致对只有 19 个,那一格的 p 值实际上只由这 19 个人决定。
- 缺失是整行剔除,不是按列剔除。 一个被试在任何一个时点缺一次,他在所有时点上的数据都不进分析。若缺失与结局有关(比如效果差的人中途退出),留下的完整案例就是一份有偏的样本,Q 的结论会系统性地偏乐观,而这不是增大样本量能解决的问题。卡①会给出因缺失剔除的行数与比例,先看那个数字有多大。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:Cochran's Q 检验主结果表
- 输出结果三:阳性率分布可视化
- 输出结果四:效应量与事后两两比较
- 输出结果五:结论与学术表述
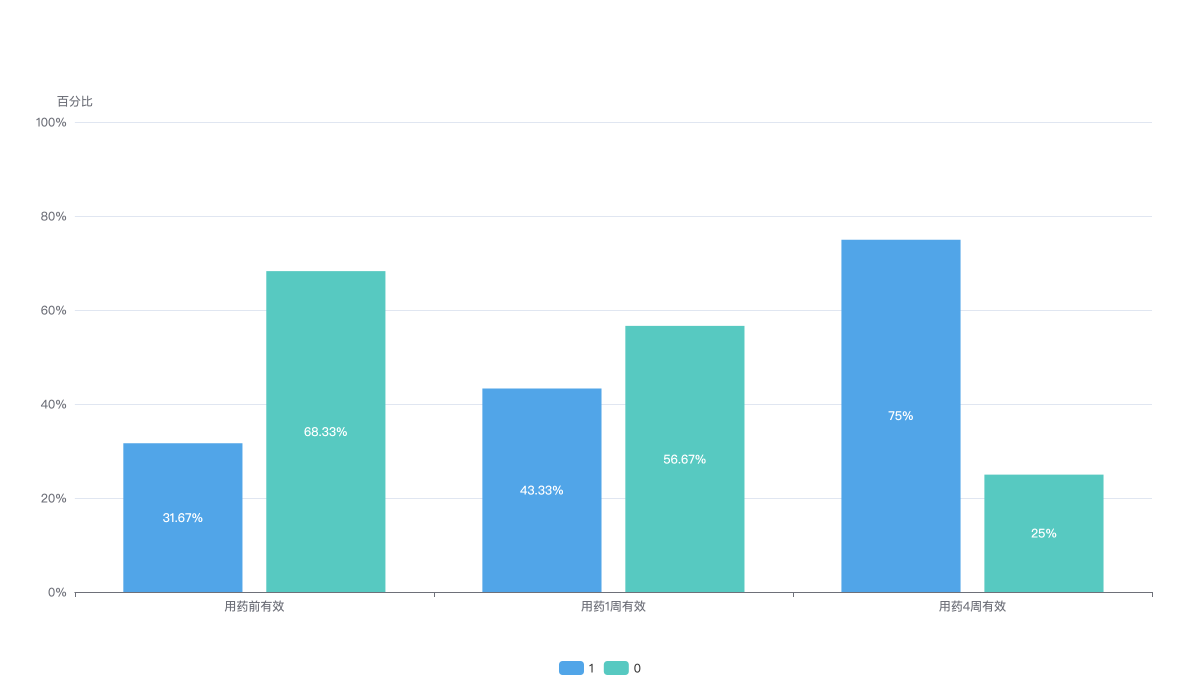
可通过上方下拉框切换指标与图表形态,或用视图切换器切到「表格」查看同一份数据。