

Mood中位数检验
这个方法是做什么的
Mood 中位数检验问的是:几个独立组的总体中位数是否相同。做法很朴素——把所有观测合在一起求出总中位数,再数每个组里有多少观测高于它、多少不高于它,得到一张“组 × 高低”的列联表,最后用 Pearson 卡方检验(不做连续性校正)判断各组“高于总中位数的比例”是否相同。只有两组时,报告还会给出 Fisher 精确检验。
因为每个观测只被简化成“高或不高”,这个检验对极端值完全不敏感,也不要求正态或方差齐。报告第二张卡给出计数表和检验结果,第四张卡给出整体效应量 Cramér's V,并对每两组重做一次检验(使用这两组自己的合并中位数),按 Holm 法校正多重比较。等于总中位数的观测默认计入“不高于”一侧(与 SPSS 一致),也可以在控件里改为计入另一侧或剔除。
需要准备什么数据
- 放入[定量]检验变量:1 个,定量变量(数值)
- 放入[定类]分组变量:1 个,定类变量(分组/标签)
数据要求
- 数据表至少 6 行。
- 单列缺失率不超过 50%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「放入[定类]分组变量」的类别数需在 2~20 之间。
- 「放入[定类]分组变量」的每一组至少 2 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 住院天数、等待时间、医疗费用这类右偏、带极端值的指标,比较几个科室或地区的中位数
- 报告与解读本来就以中位数为准,希望检验结论直接对应中位数
- 数据中有截尾或封顶值(如“超过 30 天”统一记为 30),只关心位置高低
- 作为秩和检验的敏感性分析,确认结论不依赖分布形状的细节
前提只有两条:各组观测相互独立;变量至少是有序的。每组至少要有 2 个有效观测,分组变量至少两组。
什么时候不要用它
- 想用更高的检验效能比较分布位置:用「多独立样本Kruskal-Wallis检验」,它利用了全部秩次信息,通常比只看高低的 Mood 检验更灵敏;只有两组时用「独立样本 Mann-Whitney U 检验」。
- 数据近似正态、关心的是均值:用「单因素方差分析」,效能最高,还能给出均值差和效应量。
- 同一批对象在不同条件下重复测量:各组不独立,应改用「多配对样本Friedman检验」。
容易误读的地方
- 等于中位数的观测怎么归类会影响结果。 评分、天数这类取值重复多的数据里,正好等于总中位数的观测可能很多,把它们算到哪一侧,计数表会明显变化。报告卡①列出每组等于总中位数的个数;数量不少时,建议切换控件做一次敏感性分析,并在论文里写明处理方式。
- 效能低是代价,不是缺陷。 不显著时不要急着写“各组中位数相同”。Mood 检验丢掉了“高出多少”的信息,样本量不大时很容易检不出真实差别;可以同时报告「多独立样本Kruskal-Wallis检验」的结果作为参照。
- 期望频数偏小时卡方近似不准。 卡①给出最小期望频数和期望频数小于 5 的单元格比例。两组时以 Fisher 精确检验为准;多组且期望频数偏小时,应谨慎解读或合并小组。
- 两两比较使用各自的合并中位数。 每一对是重新做的独立检验,不是整体计数表的拆分,所以两两结果与整体结论不一定逐一对得上;以 Holm 校正后的 p 判断具体哪些组对不同。
- 中位数差只是描述。 卡④里的“中位数差”是两组样本中位数之差,没有配置信区间,不要把它当成精确的效应估计来报告。
- 各组样本量悬殊时要谨慎。 总中位数主要由大组决定,小组的观测可能大部分落在同一侧,这时计数表里会出现很小的单元格,卡方近似不准;可以先看卡①的期望频数,再结合各组自己的中位数和四分位数描述结果,不要只报告一个 p 值。
- 结论说的是中位数,不是均值。 对偏态数据而言,中位数相同而均值不同是常见现象;如果研究问题关心的是总费用、总天数这类可加的量,均值才是正确的目标,此时应改用以均值为对象的方法,并对偏态做适当处理。
- 多组时先看整体再看两两。 整体检验不显著时,两两比较的结果只能作为探索性参考;即使某一对在校正前显著,也不应写成确定的结论。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:Mood 中位数检验主结果表
- 输出结果三:各组高于/不高于总中位数的构成
- 输出结果四:效应量与两两比较
- 输出结果五:结论与学术表述
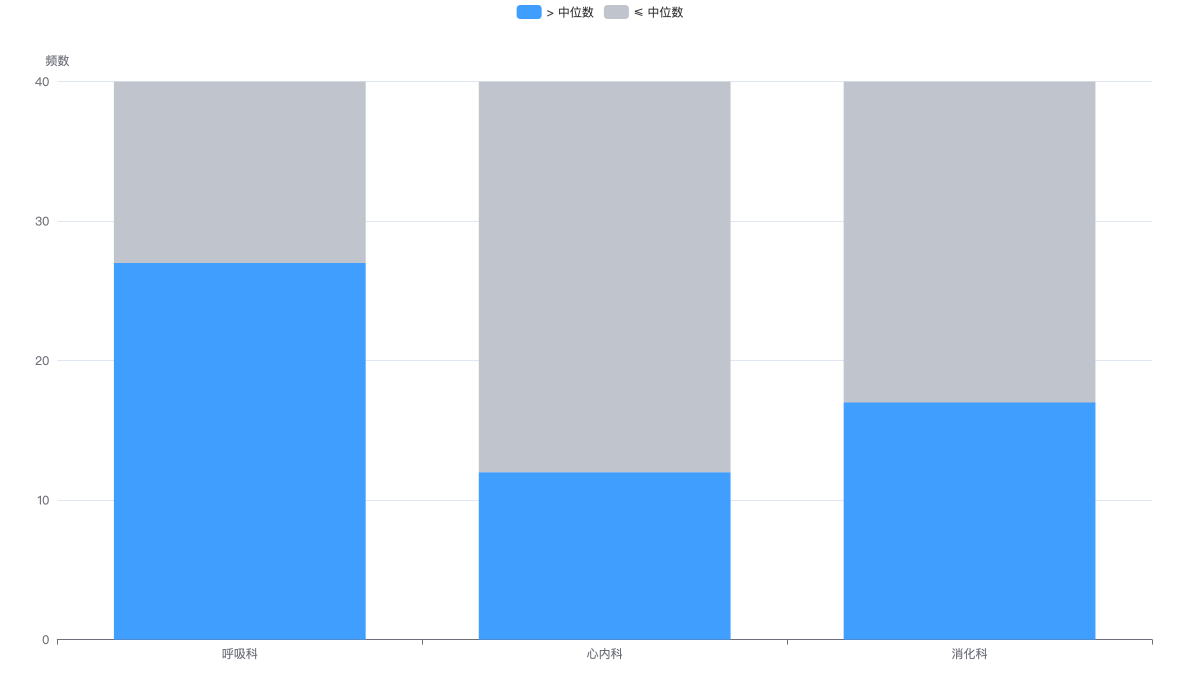
蓝色为高于总中位数的观测数,灰色为其余观测数。