

障碍度模型
这个方法是做什么的
障碍度模型回答的是“离最好还差在哪里”。每行是一个评价对象(常见的是一个年份或一个地区),各列是指标;正向指标与负向指标分别拖入对应区,先做同向化与极差标准化,得到 0 到 1 之间的 x′,越接近 1 越接近本批对象中的最优水平。随后用指标权重作为因子贡献度 Fⱼ,用 1 − x′ 作为指标偏离度 Iᵢⱼ,障碍度 Oᵢⱼ = FⱼIᵢⱼ / ΣFⱼIᵢⱼ,每个对象的各指标障碍度合计 100%。权重可选熵值法(默认)、CRITIC 权重法或等权,前两者的定义与对应的同名模块完全相同。
报告给出每个对象的障碍度矩阵和前 3 位障碍因素、障碍度热力图与各指标的平均障碍度;第四张卡同时列出三种赋权下的权重、综合得分 Σwⱼx′ᵢⱼ,以及换一种赋权后综合得分排名和平均障碍度排名的 Spearman 秩相关,用来判断“主要障碍”的诊断是否依赖赋权方法。
需要准备什么数据
- 正向指标 (越大越好)(可选):至少 0 个,定量变量(数值)
- 负向指标 (越小越好)(可选):至少 0 个,定量变量(数值)
- 评价对象标签列(如年份、地区,可选)(可选):0~1 个,定类变量(分组/标签)
数据要求
- 数据表至少 3 行。
- 单列缺失率不超过 30%。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 已经用综合评价得到了历年或各地区的得分,想进一步说明每年、每地拖后腿的是哪几个指标
- 研究发展水平、协调水平类课题,需要识别制约因素并观察它们随时间的迁移
- 指标量纲不同、有正有负,需要在同一口径下比较各指标的“短板程度”
- 想检验主要障碍的诊断对赋权方法是否敏感
- 想在指标层面定位短板;本模块不做准则层汇总,需要时可把同一维度各指标的障碍度相加,因为每个对象的障碍度合计为 100%
前提是两区合计至少 2 个定量指标、至少 3 个评价对象;含缺失的行整行剔除,零方差的常数指标会被剔除并在卡①列出。“评价对象标签列”可选,放入年份或地区名后报告按名称显示每个对象,不放则显示为“第 N 行”,重名的标签会自动加序号区分。演示数据是某地 2013—2024 年 8 项发展指标,熵值法下平均障碍度最高的是“研发投入强度”(19.24%)。
什么时候不要用它
- 只想得到综合得分和排名,不需要诊断短板:用「熵值法」或「优劣解距离法(TOPSIS)」。
- 想看两个系统之间的协调程度:用「耦合协调度」。
- 权重要由专家判断确定:先用「层次分析法(AHP)」定权重,本模块目前只提供熵值法、CRITIC 与等权三种客观赋权。
- 要按距离理想方案的远近排序并给出折中解:用「多准则妥协解排序法(VIKOR)」。
容易误读的地方
- 表现最好的对象,障碍度反而最集中。 演示数据里 2024 年几乎在所有指标上都是本批最优,只剩“单位GDP能耗”没有达到最优,于是它独占 100% 的障碍度;百分比只说明“剩下的差距在哪里”,不说明差距有多大,要结合综合得分一起读——这一年的综合得分为 0.9926,排名第 1。
- 障碍度是相对本批数据最优值的诊断,不是与政策目标的差距。 标准化以本批对象的最小值、最大值为基准,增删一个年份,所有障碍度都会改变;某对象在全部指标上都取最优值时障碍度无定义,表中标为“-”,热力图也只画障碍度有定义的单元格。
- 主要障碍是谁,可能取决于赋权方法。 演示数据用熵值法时平均障碍度最高的是“研发投入强度”,换成 CRITIC 法变成了“城镇登记失业率”,两种赋权下平均障碍度排名的 Spearman ρ 只有 0.643,等权时最高的又换成了“单位GDP能耗”;第四张卡会直接说明三种赋权的结论是否一致,不一致时论文要交代选择理由。
- 权重高、表现差,才会成为主要障碍。 一个指标进步很慢,但权重很低,它的障碍度也不会高;反过来,CRITIC 法给“城镇登记失业率”0.330 的权重(熵值法只有 0.111),它就被推成了首要障碍。
- 前 3 位障碍因素只列障碍度大于 0 的指标。 某对象只在一两个指标上没达到最优时,列表会少于 3 项,这是如实反映,不是遗漏。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:障碍度矩阵与主要障碍因素
- 输出结果三:障碍度热力图与指标平均障碍度
- 输出结果四:指标权重、综合得分与赋权稳健性
- 输出结果五:结论与学术表述
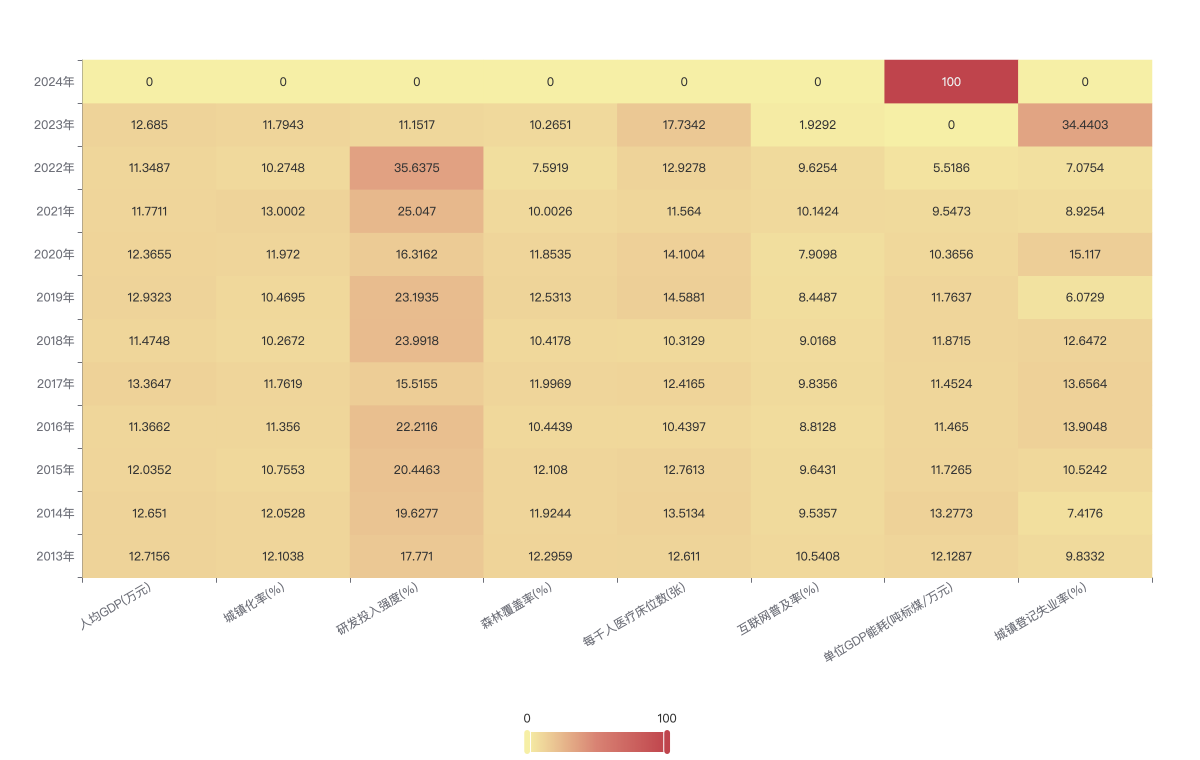
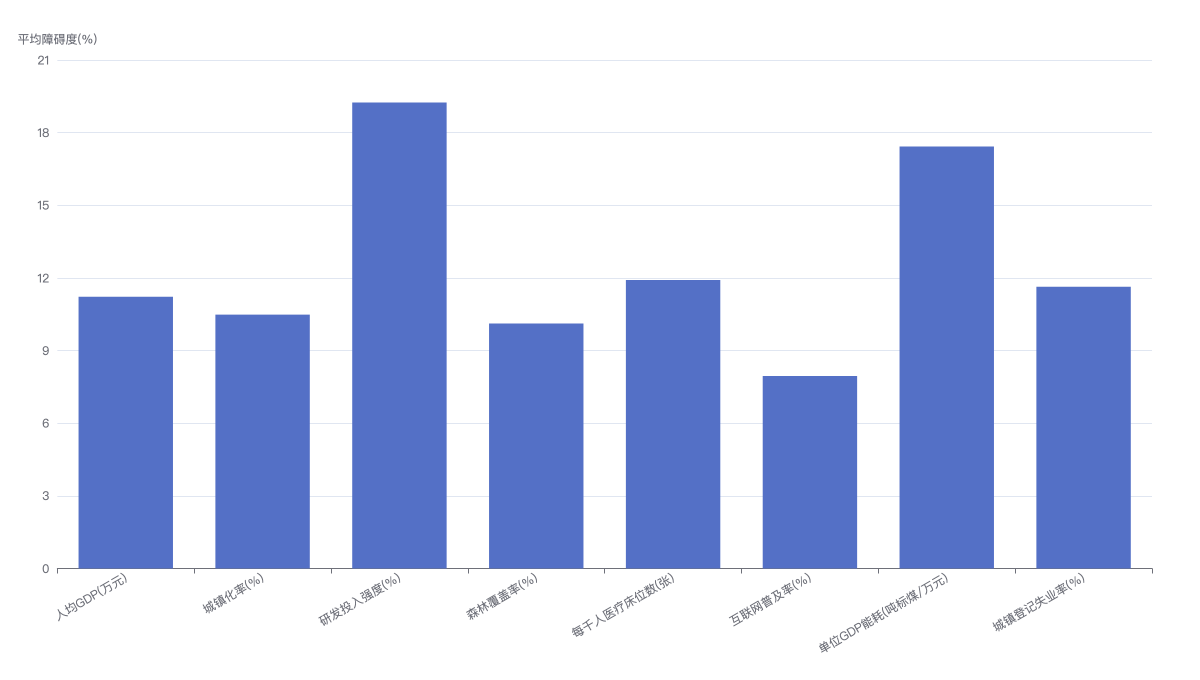
热力图颜色越深表示该对象在该指标上的障碍越大;条形图为各指标在所有对象上的平均障碍度。