

马尔可夫链预测
这个方法是做什么的
马尔可夫链预测把研究对象的状态(如市场需求的“滞销、平销、畅销、紧俏”,或某指标分段后的等级)看成在几个离散状态之间转移,用历史上的转移频数估计转移概率矩阵 P,再从最后观测到的状态出发预测未来各期处于各状态的概率。数据有两种放法:只放“状态序列”时,数据须按时间顺序排列,相邻两行构成一次转移;同时放“期初状态”和“期末状态”时,每行是一次转移,适合多个个体的面板数据。
除转移矩阵和多步预测外,报告做马氏性检验(Anderson 与 Goodman 1957 年提出的 G² 检验),判断下一期状态是否真的与当前状态有关;在链不可约且非周期时给出稳态分布,即长期运行下各状态所占比例,否则如实说明稳态分布不适用及原因。演示数据是 2015 年起 120 个月的市场需求状态,共 119 次转移:前三个状态下一期最可能停留在原状态,“4-紧俏”下一期更可能回落到“3-畅销”(0.500)。
需要准备什么数据
- 放入状态序列(按时间顺序排列,可选)(可选):0~1 个,定类变量(分组/标签)
- 放入期初状态(面板转移,可选)(可选):0~1 个,定类变量(分组/标签)
- 放入期末状态(面板转移,可选)(可选):0~1 个,定类变量(分组/标签)
数据要求
- 数据表至少 10 行。
- 本方法允许所选变量含缺失值——缺失本身就是分析对象的一部分,不会因为「完整记录不够」被拦下。
- 单列缺失率不超过 50%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 状态是少数几个类别,关心“下一期、下几期会落在哪个状态”的概率
- 需要描述状态之间的转移规律,例如客户等级升降、病情分级变化、景气状态更替
- 想知道长期均衡下各状态的比例
- 已有连续指标,愿意先分成几个等级再研究等级之间的转移
- 想用一阶马尔可夫相依检验说明状态有“惯性”,例如本期畅销、下期仍畅销的概率有多大
前提是状态数较少(本模块上限 30 个)、观测足够长(至少 10 行),并且可以接受“下一期只取决于当前状态”“转移概率不随时间变化”这两个假定;状态序列中不能有空值。状态按自然顺序排列(数字按大小、文字按字典序),给状态名加上“1-”“2-”这样的序号前缀,表格和图例就会按等级顺序显示。“预测步数”可设 1 到 50;面板方式下,预测的起点是期末状态的经验分布,而不是某一个状态。
什么时候不要用它
- 要预测的是连续数值而不是状态:用「时间序列分析(ARIMA)」或「指数平滑模型」。
- 样本很少、只有几期数据:用「灰色预测模型GM(1,1)」。
- 想解释状态由哪些因素决定:用「有序逻辑回归」或「逻辑回归」。
- 只想检验两个类别变量是否相关:用「卡方检验」。
容易误读的地方
- 马氏性检验不显著时,链模型并不比“按频率猜”更有信息。 检验的原假设是下一期状态与当前状态独立;演示数据 G²=64.05、df=9、p<0.001,说明存在一阶相依(演示数据本身就是由一个已知转移矩阵模拟生成的)。若不显著,转移矩阵每一行都差不多,预测结果基本就是各状态的总体频率。
- 单条序列的稳态分布和样本频率完全相同,并不是巧合。 演示数据首、末两期都是“2-平销”,每个状态的转入次数等于转出次数,此时极大似然转移矩阵的稳态分布恰好等于样本中的状态频率,卡④两列逐位相同;这说明的是估计方法的性质,不是“系统已经达到均衡”的证据。
- 预测给出的是概率分布,不是确定的状态。 演示数据第 3 步“2-平销”的概率只有 0.356,其余三个状态合计超过六成;只报告“最可能状态”会夸大预测的确定性;长期看,稳态分布中“2-平销”也只占 0.328。
- 转出次数少的状态,转移概率很不可靠。 卡①列出每个状态的转出次数,演示数据“4-紧俏”只有 18 次转出;某个状态完全没有转出观测时,转移矩阵不完整,模块会停止预测并说明原因。
- 序列模式按行序配对,中间缺一期会错配。 缺失的一期会把不相邻的两期当成一次转移,所以序列中有空值时模块直接报错;数据不连续时请改用期初、期末两列的面板方式输入,或先在“数据处理”中核对时间顺序与缺失期。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:转移矩阵与马氏性检验
- 输出结果三:多步预测
- 输出结果四:稳态分布与链的性质
- 输出结果五:结论与学术表述
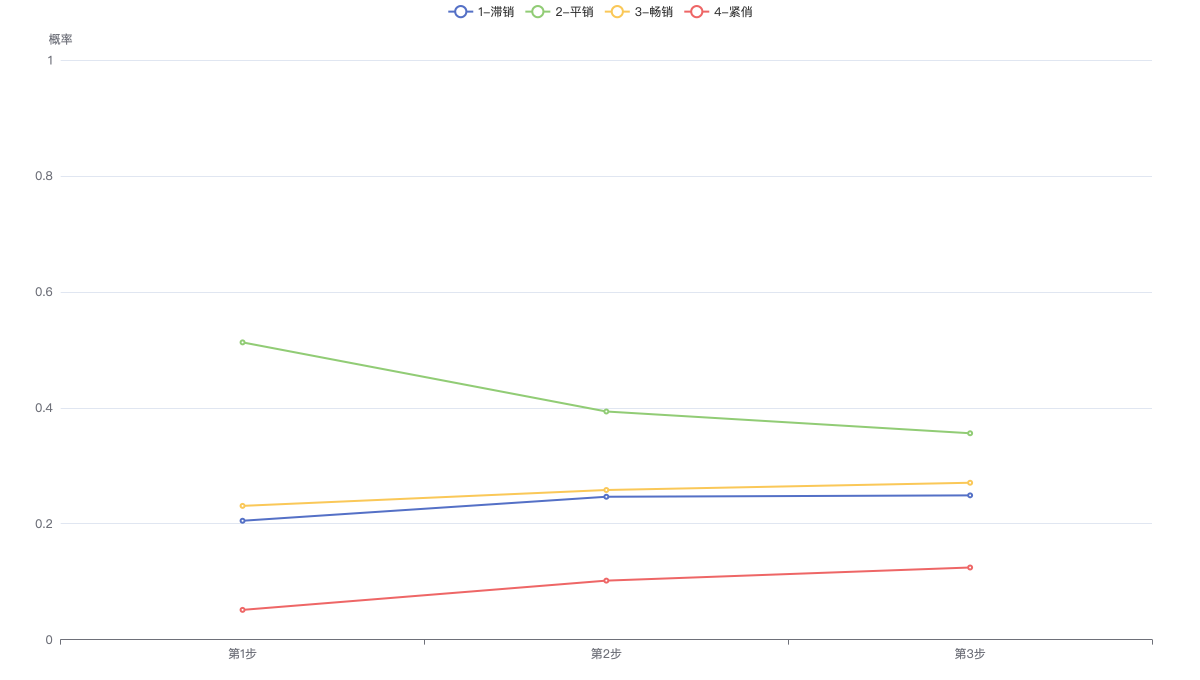
预测给出的是各状态的概率分布,而不是确定的状态;步数越多,分布越接近稳态(若存在)。