

DEMATEL决策实验室分析
这个方法是做什么的
DEMATEL 用来厘清一组因素之间“谁影响谁、影响多深”。专家对每一对因素打分,写成直接影响矩阵:单元格是行因素对列因素的直接影响程度,常用 0–4 分,对角线为 0。方法先把矩阵除以最大行和与最大列和中较大的那个,得到规范化矩阵 N,再算综合影响矩阵 T = N(I − N)⁻¹,它把直接影响和经过其他因素传导的间接影响加在一起。数据表第一列写因素名,其余各列是矩阵,列名即因素名;多位专家时把各自的矩阵上下堆叠并指定“专家编号列”,按算术平均集结。
报告的核心是四个量:影响度 D(T 的行和)、被影响度 R(列和)、中心度 D+R(因素在系统中的重要程度)、原因度 D−R(正为原因因素,负为结果因素)。第三张卡给出以中心度为横轴、原因度为纵轴的因果图,以及只保留超过阈值的强关系的影响网络;第四张卡给出基于中心度的权重和两种阈值下入网关系数的对照。卡②的 T 矩阵保留 4 位小数,因果图中 D−R=0 的横线把原因因素与结果因素分开。
需要准备什么数据
- 放入因素名称列(直接影响矩阵的行标签):1 个,定类变量(分组/标签)
- 放入直接影响矩阵各列(列名=因素名):至少 2 个,定量变量(数值)
- 放入专家编号列(多位专家,可选)(可选):0~1 个,定类变量(分组/标签)
数据要求
- 数据表至少 2 行。
- 本方法允许所选变量含缺失值——缺失本身就是分析对象的一部分,不会因为「完整记录不够」被拦下。
- 单列缺失率不超过 100%。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 想找出一组障碍、风险或影响因素中的“根源”与“表象”,确定干预的先后
- 因素之间存在相互作用,单看每个因素的重要性不够,需要考虑影响的传导
- 有多位专家打分,需要集结后再分析
- 准备进一步做递阶结构分析,需要一份有强度信息的影响关系矩阵
- 希望得到因素的“原因—结果”分组,用于确定政策或管理措施的着力点
前提是矩阵为方阵、非负、对角线为 0,无影响要填 0 而不是留空;规范化矩阵的谱半径必须小于 1,卡①会直接报出这个值,正常打分的矩阵都满足。演示数据由 5 位专家对 6 个障碍因素打分,平均后规范化系数 s=11.4,谱半径 ρ(N)=0.590。多位专家时每人必须评价同一组因素,因素的行序可以不同,按名称对齐后再平均。
什么时候不要用它
- 只需要知道因素的层级结构,不关心影响强度:用「解释结构模型(ISM)」,它基于 0/1 的直接影响关系划分层级。
- 要比较的是要素的相对重要性而不是相互影响:用「层次分析法(AHP)」。
- 想用观测数据检验变量之间的影响关系:DEMATEL 只整理专家认知,此时应建立回归模型,例如「逻辑回归」或线性回归类方法。
- 要给一批评价对象打分排序:用「优劣解距离法(TOPSIS)」或「灰色关联分析」。
容易误读的地方
- 中心度高不等于是原因因素。 演示数据中心度最高的“数据基础薄弱”(D+R=3.524)原因度为 −0.948,是被影响最多的结果因素;真正的驱动端是原因度为正的“外部政策支持不足”与“管理层认知不足”。两张表要连着读。
- 影响网络画出哪些箭头,完全取决于阈值。 演示数据按 T 均值(θ=0.2630)保留 17 条关系,按均值加标准差(θ=0.4074)只剩 7 条;阈值口径只改变网络图,D、R、中心度与原因度不随之改变,结论应落在这四个量上。两种阈值都按 T 的全部 n² 个元素(含对角线)计算,标准差取总体标准差,论文中要写明所用口径。
- 中心度权重可能差别很小,不宜当作区分度高的指标权重。 演示数据 6 个因素的中心度权重在 0.122 到 0.186 之间,前两名的中心度只差 0.0014(3.5242 对 3.5228),权重四舍五入后完全相同;若需要拉开差距的权重,DEMATEL 并不合适。
- 这是专家认知的结构,不是从数据里估计的因果效应。 专家人数少或打分随意时,D−R 的符号也可能改变;论文应报告打分标度、专家人数与集结方式,并把结论表述为“专家认为”。
- 专家打分概况表能看出谁明显偏高或偏低。 卡①列出每位专家的矩阵元素总和与平均影响强度,某位专家整体打分远高于他人时,算术平均会被他拉动,应回头核对其问卷;演示数据 5 位专家的矩阵元素总和在 42 到 47 之间,差别不大。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:综合影响矩阵与原因-中心度
- 输出结果三:因果图与影响网络
- 输出结果四:中心度权重与阈值敏感性
- 输出结果五:结论与学术表述
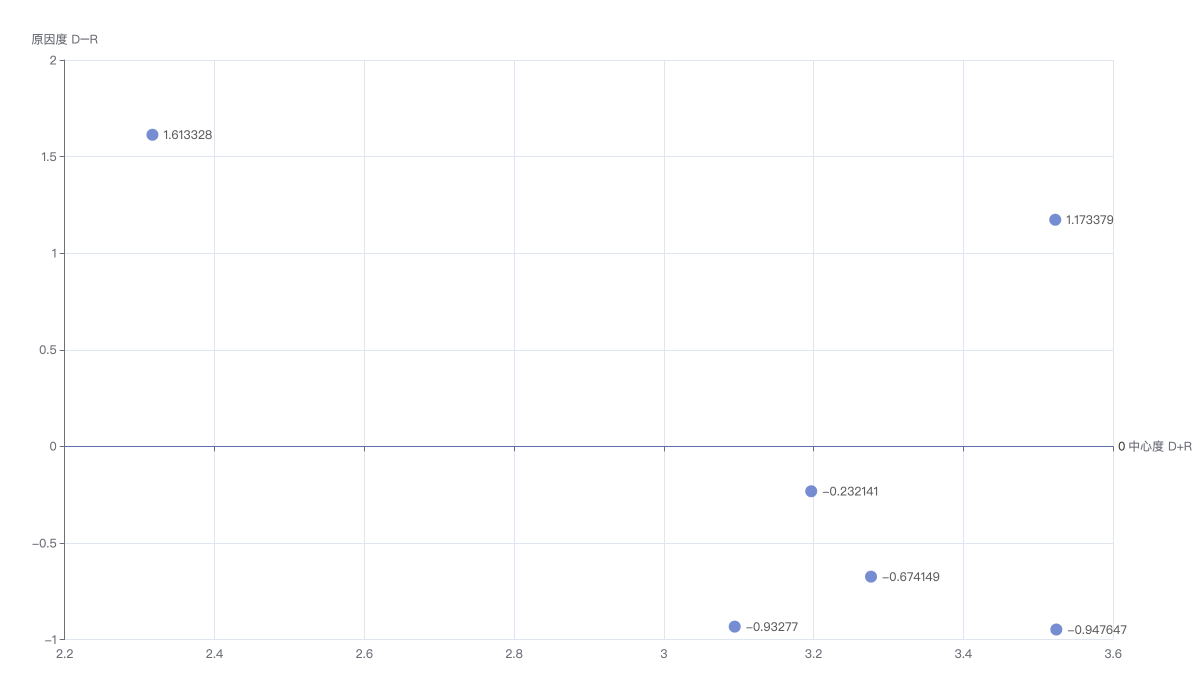
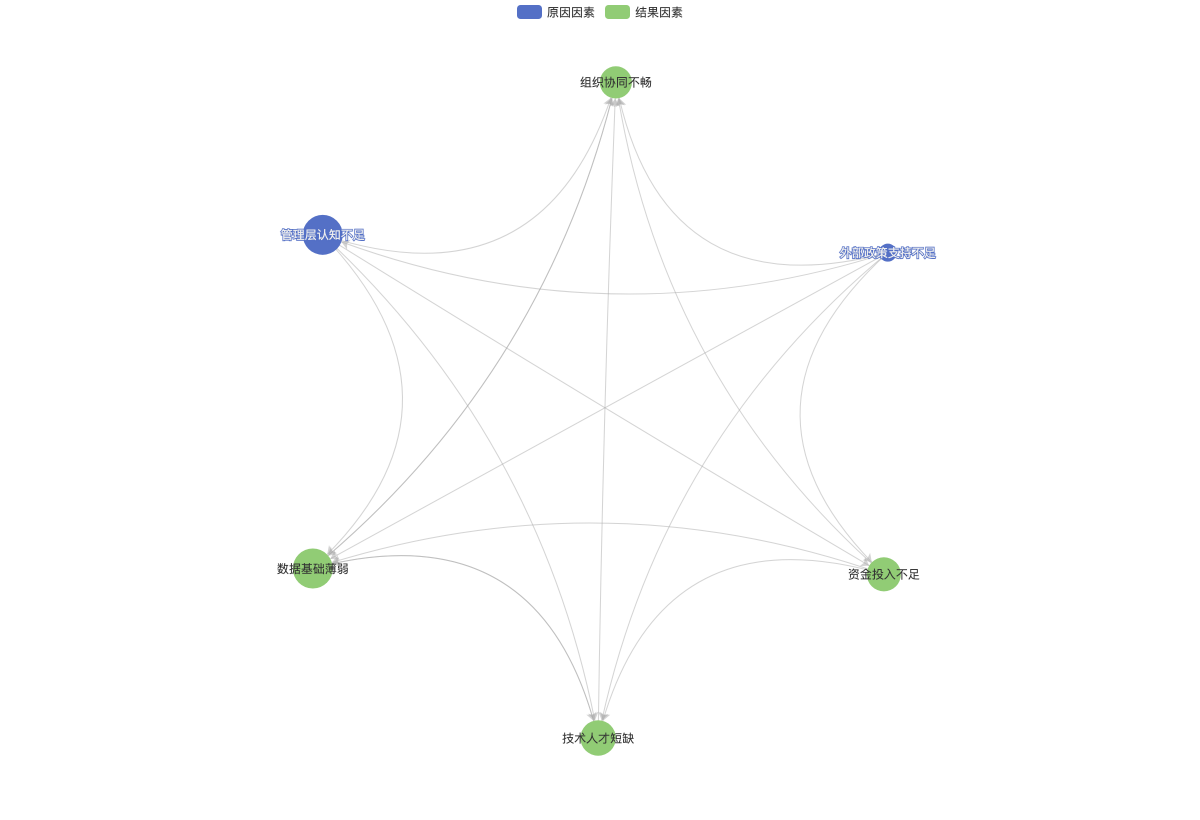
因果图横轴为中心度、纵轴为原因度,横线 D−R=0 以上为原因因素;影响网络只画 tᵢⱼ ≥ θ 的 17 条关系。