

最好最差法(BWM)
这个方法是做什么的
最好最差法(BWM)是一种用很少的比较就能得到准则权重的主观赋权方法。判断者先选出最重要的准则 B 和最不重要的准则 W,然后只做两组比较:最优准则相对每个准则重要几倍(BO 向量,最优准则自身为 1),以及每个准则相对最劣准则重要几倍(OW 向量,最劣准则自身为 1),取值 1–9。数据只需两行:一列写向量标签(如“最优对其他(BO)”“其他对最劣(OW)”),其余各列是准则。本模块采用 Rezaei (2016) 的线性模型,以线性规划求出使最大偏离 ξᴸ 最小的一组权重。
ξᴸ 是一致性指标,越接近 0 越一致,判断完全一致时为 0。卡①逐个准则检查一致性条件 a_Bj × a_jW = a_BW;卡④列出每条约束的实际偏离、哪些比较决定了 ξᴸ,并在 ξᴸ 固定时求出每个权重的取值范围,以实测确认解是唯一的。线性模型用 HiGHS 线性规划求解,同一份输入每次运行结果相同;本模块只处理一位判断者的一组 BO、OW 向量。
需要准备什么数据
- 放入向量标签列(区分 BO 行与 OW 行):1 个,定类变量(分组/标签)
- 放入各准则列:至少 3 个,定量变量(数值)
数据要求
- 数据表至少 2 行。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 准则较多、做完整两两比较负担太重,希望用 2n − 3 次比较得到权重
- 判断者能明确说出最重要和最不重要的准则
- 需要一个有明确一致性指标、解唯一的主观赋权方法
- 想把专家判断得到的权重用于后续的综合评价
- 需要在报告中给出明确的一致性指标 ξᴸ 以及每条比较的实际偏离
前提是 BO 与 OW 两行都填满,取值 1–9,最优与最劣准则各自唯一,且两行中“最优对最劣”的判断相同(BO 中最劣准则的值等于 OW 中最优准则的值),不一致时模块会报错并指出两个值。两行的标签含“最优、最好、Best、BO”与“最劣、最差、Worst、OW”时按标签识别,否则按第 1 行为 BO、第 2 行为 OW 读取,卡①会写明采用的是哪种识别方式。演示数据是物流服务商选择的 6 个准则,最优准则“准时交付率”得到 40.04% 的权重。
什么时候不要用它
- 准则不多、愿意做完整的两两比较,或需要层次结构与群决策:用「层次分析法(AHP)」。
- 判断本身很模糊,想保留不确定性:用「模糊层次分析法(FAHP)」。
- 有各对象的实测数据,想让数据决定权重:用「熵值法」或「CRITIC权重法」。
- 要分析准则之间的相互影响:用「DEMATEL决策实验室分析」。
容易误读的地方
- ξᴸ 小不代表每条比较都一致。 演示数据 ξᴸ=0.0308,但 6 个准则中有 4 个不满足 a_Bj × a_jW = a_BW,例如“网络覆盖”的乘积是 12,而“最优对最劣”只有 8;一致性要连同卡①的逐项偏差一起看。卡④中 6 个准则的约束偏离都达到了 ξᴸ,说明这些比较共同决定了一致性指标。
- 线性模型的 ξᴸ 不再除以一致性指数。 非线性 BWM 的一致性比率要用 ξ* 除以随 a_BW 变化的一致性指数;线性模型直接报告 ξᴸ,两种模型的数字不能互相套用界值;ξᴸ 也没有通用的接受界值,只能说越接近 0 越好。非线性模型的解可能不唯一,线性模型的解唯一。
- 最优、最劣准则选错了,后面的比较都会受影响。 所有比较都以这两个准则为参照,它们本身的选择没有任何检验;BO 中出现两个 1 而无法区分时,模块会要求重新确认。演示数据的最优准则“准时交付率”在 BO 中为 1、在 OW 中为 8,最劣准则“应急响应”在 OW 中为 1、在 BO 中为 8。
- 文献算例可能有排版错误,复算时以约束为准。 用 Rezaei 教程的买车例复算,五个权重数值与幻灯片一致,但幻灯片上舒适性与安全性的位置互换了——按幻灯片的排列,0.431 − 4×0.154 = −0.185,超出了 ξᴸ=0.061 的约束;本模块逐个准则验证了解的唯一性。
- “最优对最劣”这一个判断牵动全局。 a_BW 同时出现在两个向量里,演示数据把它从 8 改成 5(其余不变),“应急响应”的权重从 4.62% 升到 5.93%,ξᴸ 却从 0.0308 升到 0.0741,因为它与其余比较更不协调了;填写时要想清楚最优比最劣究竟重要几倍,可以先定下 a_BW,再让其余每个准则的两条判断尽量满足 a_Bj × a_jW ≈ a_BW。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:准则权重与一致性指标
- 输出结果三:权重可视化
- 输出结果四:约束偏离与权重稳定区间
- 输出结果五:结论与学术表述
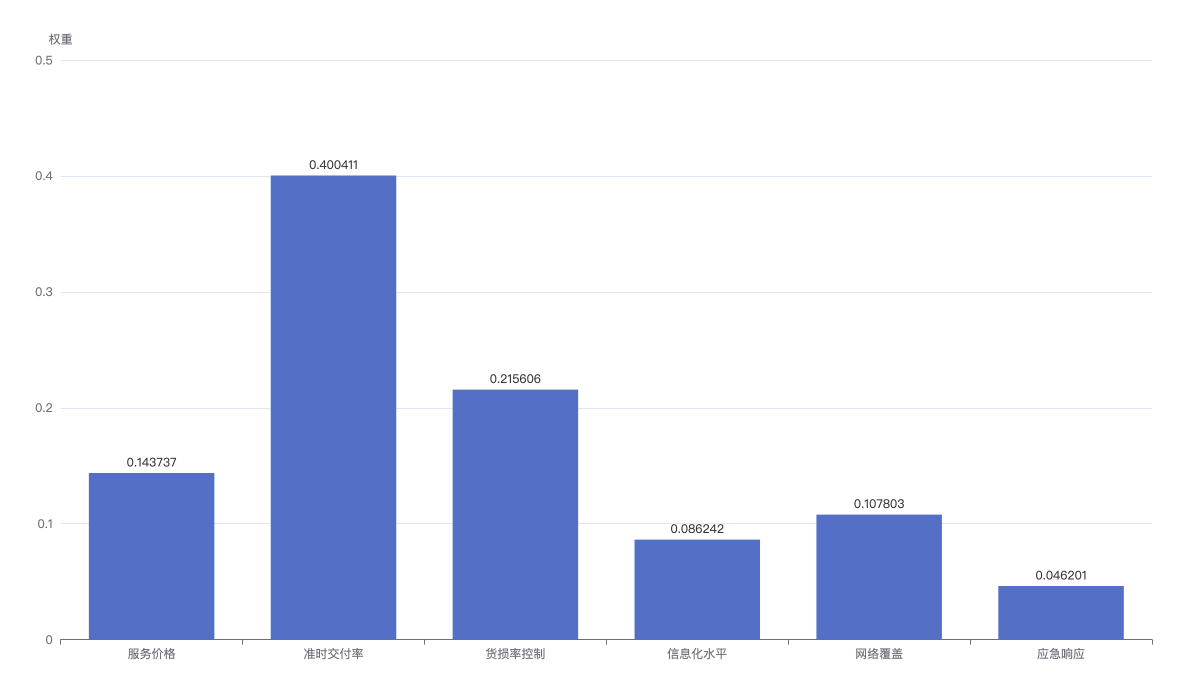
条形高度为各准则的权重,可切换为表格查看数值。