

组内一致性(rwg/ICC)
这个方法是做什么的
多层研究里常把个体的评分“聚合”成团队、班级或门店层面的变量,例如用团队成员对团队氛围打分的平均值代表这个团队的氛围。聚合之前要回答两个问题:同一团队的成员评价得够不够一致?不同团队之间是否真的存在差异、团队均值是否可靠?本模块用两类指标分别回答。
rwg(J) 衡量组内一致性:把团队内部观测到的评分方差,与“成员毫无一致性、随机作答”时的期望方差(零分布方差)比较,越接近 1 越一致;放入多个题项时按 James、Demaree 与 Wolf 提出的多题项公式合并。观测方差不小于零分布方差时记为 0,并统计这类团队的个数。ICC(1) 与 ICC(2) 来自以团队为因子的单因素方差分析:ICC(1) 是个体评分中由团队归属解释的方差比例,ICC(2) 是团队均值的信度。报告同时给出 F 检验与置信区间、各团队的 rwg(J) 明细和分布图。
需要准备什么数据
- 放入测量题项 [定量]:至少 1 个,定量变量(数值)
- 放入分组变量 [定类]:1 个,定类变量(分组/标签)
数据要求
- 数据表至少 6 行。
- 单列缺失率不超过 50%。
- 「放入分组变量 [定类]」的类别数需在 2~2000 之间。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 打算把个体问卷得分平均成团队层变量,需要报告聚合依据
- 想知道哪些团队内部意见分歧明显
- 设计多层研究时评估每个团队需要调查多少人
数据为长格式:每行一个人,分组变量标识所属团队,题项为同一构念的李克特评分。每个团队至少 2 人,只有 1 人的团队会被剔除并在第一张卡列出。“量表点数 A”要填题项的选项个数(5 点量表填 5),它决定零分布方差;题项取值跨度超过量表点数时,模块会提示检查设置。第五张卡把三条惯例标准逐条判定,并给出能否聚合的综合判断与可直接引用的表述。
什么时候不要用它
- 评分者对同一批对象打分、想看评分者之间是否一致(例如几位专家给同一组作品打分):那是评分者信度问题,数据是“对象 × 评分者”的宽格式,用「组内相关系数(ICC)」;分类评定用「Kappa一致性检验」,排序评定用「Kendall一致性检验」。
- 只想看同一量表各题之间是否一致:那是内部一致性信度,用「信度分析」。
- 你关心的是团队之间均值差异是否显著本身,而不打算聚合:直接用「单因素方差分析」;要同时控制个体层协变量、保留个体层数据,用「混合模型」。
- 团队数很少(只有三五个):ICC 的估计极不稳定,置信区间会非常宽。此时更适合把团队当作固定分组,用「单因素方差分析」比较各团队。
容易误读的地方
- 零分布的选择会明显改变 rwg。 均匀分布假定“无一致性时每个选项被选中的机会相同”,但现实作答常带有宽大倾向(普遍偏向高分),此时用均匀分布会高估一致性。可以把零分布换成轻度或中度偏态做敏感性分析,两个结果都报告。偏态零分布的方差常数只对 5 点量表有公开取值,其他点数的量表只能用均匀分布。
- 0.70 是惯例,不是检验。 rwg(J) ≥ 0.70、ICC(1) 大于 0.05、ICC(2) ≥ 0.70 都来自文献约定,报告中均如实标为惯例界值。尤其 ICC(2) 受团队规模影响很大:每个团队人数少时,即便团队间差异真实存在,ICC(2) 也会偏低。
- rwg 与 ICC 回答的问题不同,不能互相替代。 rwg 只看团队内部是否一致:各团队内部评分高度一致、而团队之间几乎没有差别时,rwg 很高而 ICC(1) 接近 0,此时聚合出来的团队变量没有区分度。两类指标都要报。
- 题项越多,rwg(J) 越容易偏高。 多题项公式会随题项数放大一致性,题项很多的量表即使单题一致性一般,rwg(J) 也可能超过 0.70。报告时写明题项数。
- 缺失作答会悄悄改变团队规模。 任一题项缺失的成员整行被剔除,原本 3 人的团队可能只剩 2 人,组内方差由两个人决定,rwg 很不稳定。第一张卡给出了剔除的记录数和团队规模范围,规模过小的团队应在解读时单独说明。
- 团队规模不等时 ICC 用的是平均规模。 报告以 N/G 作为每组人数代入,同时给出不等规模校正的 k₀ 口径作对照;两者差别大说明各团队人数很不均衡,解读 ICC(2) 时要格外谨慎。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:组内一致性与组内相关汇总
- 输出结果三:rwg(J) 分布图
- 输出结果四:效应量与置信区间
- 输出结果五:结论与学术表述
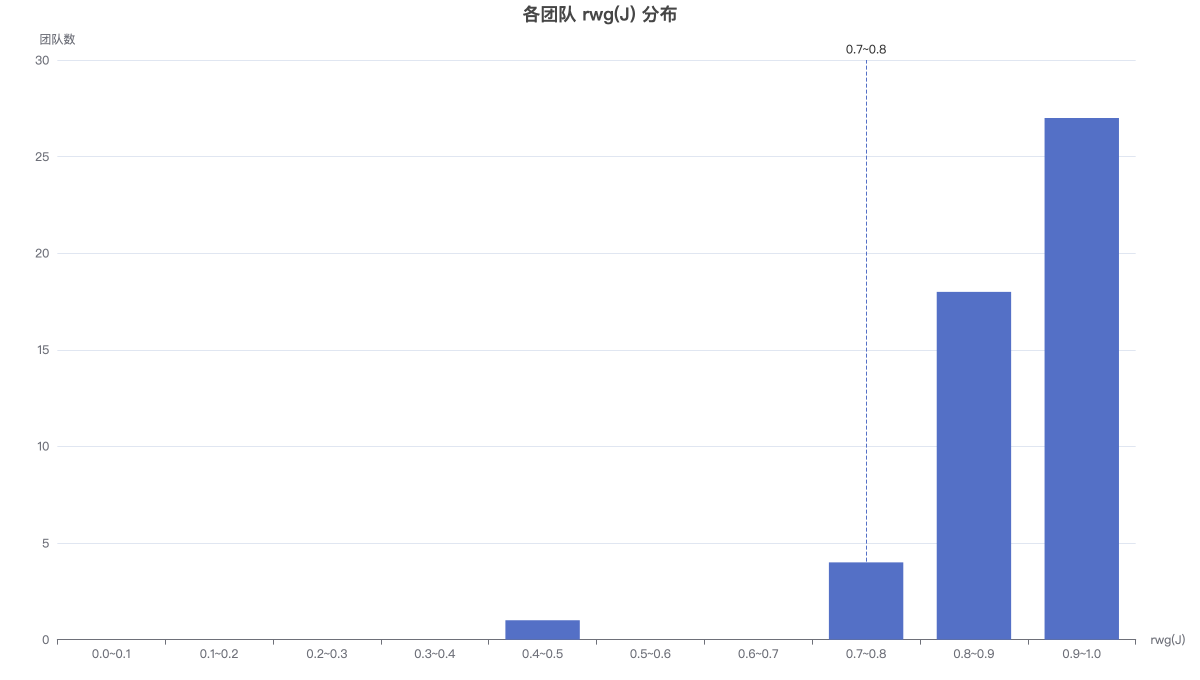
直方图展示各团队 rwg(J) 的分布,虚线标在 0.70 所在区间的左边界。