

共同方法偏差检验(Harman单因素)
这个方法是做什么的
共同方法偏差指的是:自变量和因变量由同一批人、在同一份问卷里、用同一种作答方式填写时,变量之间的相关有一部分来自“测量方式本身”而不是构念之间的真实关系,例如社会赞许、一致性动机或情绪状态让所有题目一起偏高或偏低。Harman 单因素检验是最常用的事后诊断:把问卷里全部量表题项放进一次未旋转的因子提取,看第一个因子解释了多少总方差。如果一个因子独占了大部分方差,说明“大家答得都差不多”的成分很重,偏差风险高。
报告默认用主成分法(与多数论文在 SPSS 里的做法一致),也可以改为主轴因子法;判定阈值默认 40%,也可选 50%。除了第一因子占比,还会给出特征值大于 1 的因子个数、第一与第二特征值之比、KMO 与 Bartlett 球形检验,以及第一因子占比的 Bootstrap 95% 置信区间(固定随机种子,结果可复现),用来判断结论在阈值附近是否稳定。
需要准备什么数据
- 放入全部测量题项 [定量]:至少 3 个,定量变量(数值)
数据要求
- 数据表至少 10 行。
- 单列缺失率不超过 50%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 自变量、中介变量、因变量都来自同一份自评问卷,审稿人要求说明共同方法偏差
- 论文方法部分需要一句标准的“共同方法偏差检验”报告
- 想在正式建模前先排查“所有题目被同一种作答倾向拉在一起”的风险
使用时把问卷中所有构念的全部题项一起放进拖拽区,而不是只放一个维度。样本量须大于题项数,建议至少为题项数的 5 倍;缺失按整行删除。阅读报告时先看第二张卡的判定表:第一因子方差占比是否低于阈值、特征值大于 1 的因子是否不止一个;再看第四张卡的置信区间和各题项在第一因子上的载荷,如果几乎所有题项的载荷都很高,即使占比略低于阈值,也值得在论文中讨论。
什么时候不要用它
- 只想知道某一个维度内部是否一致:那是信度问题,不是共同方法偏差问题,用「信度分析」。
- 想确认题项是否按预设维度聚合、维度划分是否合理:那是结构效度问题,用「效度分析」或「因子分析(探索性)」,看旋转后的载荷结构。
- 数据来自不同来源(例如上级评绩效、员工自评态度,或客观记录与问卷合并):共同方法偏差本身就不是主要问题,检验的意义有限;更值得报告的是各量表的「信度分析」结果。
- 题项是单选、多选这类分类题:因子提取要求可以计算相关系数的评分数据。分类题之间的关联用「对应分析」或「多重对应分析」去看。
容易误读的地方
- 通过检验不等于没有偏差。 这是公认偏弱的诊断:即使共同方法偏差确实存在,第一因子也常常达不到 40%。规范写法是“未发现单一因子解释大部分方差,共同方法偏差不严重”,而不是“证明不存在共同方法偏差”。报告的结论段已经按这个口径措辞。
- 只放部分题项会让结论失真。 放得越少,第一因子占比越高;只放一个维度时几乎必然“超标”。反过来,混入大量与研究无关的题项,又会把占比稀释得很低。拖进来的应当恰好是本研究模型涉及的全部量表题项。
- 阈值是惯例,不是统计临界值。 40% 和 50% 都来自文献习惯,没有抽样分布支撑。第一因子占比落在阈值附近时,要看第四张卡的置信区间:区间跨越阈值,说明换一批样本结论可能翻转,应如实说明而不是只报点估计。
- 主成分法和主轴因子法的数字不能混着比。 主成分法的占比是“最大特征值 ÷ 题项数”,主轴因子法用的是提取后的平方和载荷,后者通常更小。论文里写清楚用的是哪一种,并与对照文献保持一致。
- 事后检验替代不了事前控制。 更有力的做法在设计阶段:匿名作答、打乱题项顺序、预测变量与结果变量分时段收集、使用不同来源的数据。论文里宜把这些程序控制与本检验结果一起报告。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:未旋转总方差解释与判定
- 输出结果三:碎石图与第一因子占比
- 输出结果四:效应量与稳健性
- 输出结果五:结论与学术表述
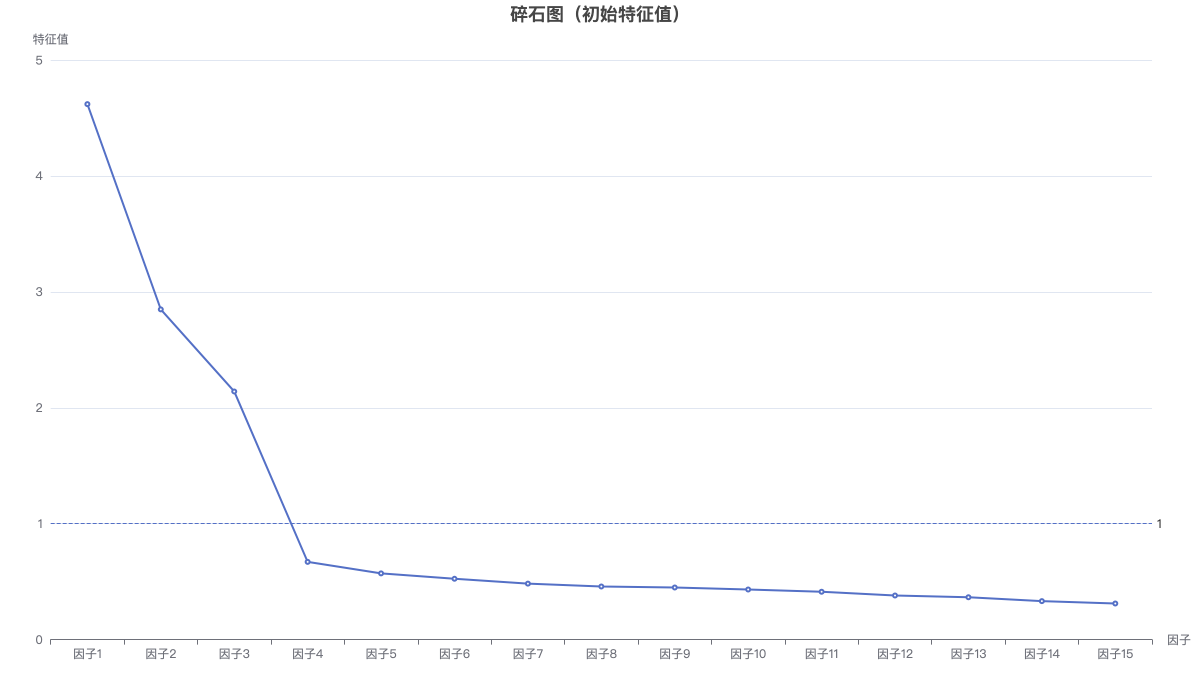
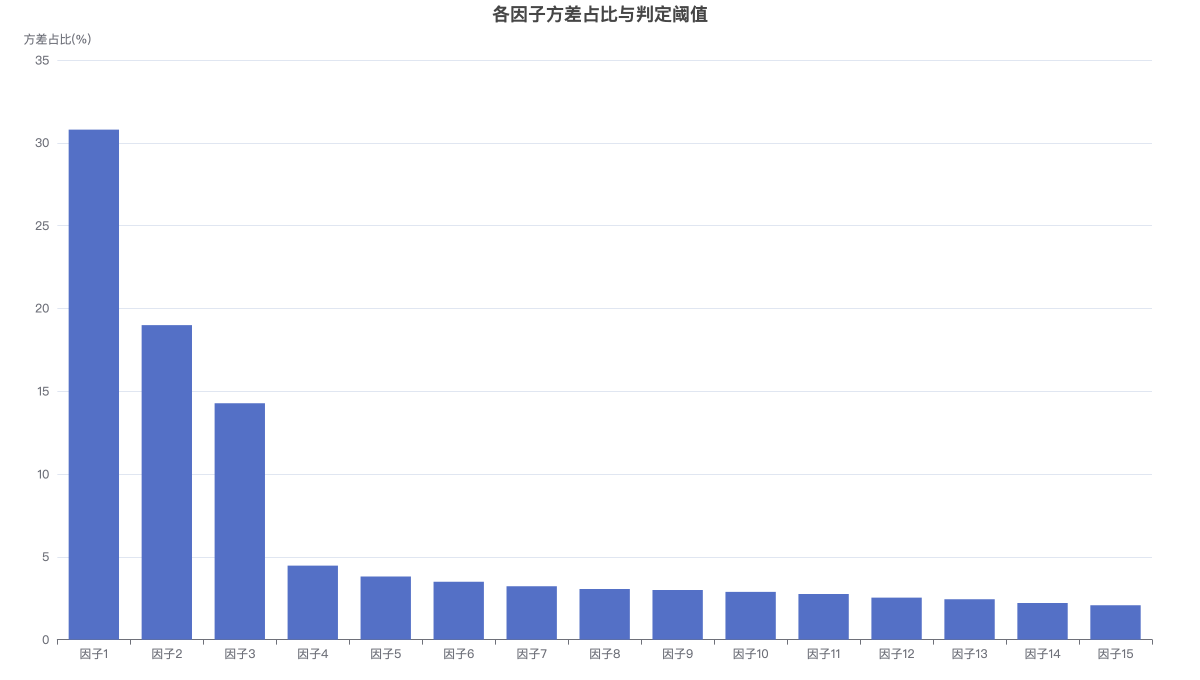
碎石图虚线为特征值 = 1;占比图虚线为 40% 判定阈值。