

基线资料表(Table 1)
这个方法是做什么的
论文里通常作为“表 1”出现的基线资料表:按分组变量把研究对象的人口学与临床特征并排列出,并逐个变量选择合适的描述方式与组间检验。它的价值在于每一行用的方法都可以追溯——第一张卡把每个连续变量各组的 Shapiro-Wilk 结果、分类变量的最小期望频数和最终选用的检验逐行列出,审稿人问“为什么这一行用了秩和检验”时可以直接回答。
连续变量判为正态时报告均数±标准差,两组用 Welch t 检验、多组用单因素方差分析(Levene 检验 p<0.05 时改用 Welch 方差分析);判为非正态时报告中位数(P25, P75),两组用 Mann-Whitney U 检验、多组用 Kruskal-Wallis 检验。分类变量报告例数(列百分比),用 Pearson χ² 检验;2×2 表有期望频数小于 5 时改用 Fisher 精确检验,更大的稀疏表用带固定种子的 Monte-Carlo Fisher 检验。两组比较时另给标准化均数差 SMD 与 Love 图,第四张卡给每个变量的效应量。
需要准备什么数据
- 放入[定类]分组变量(可选)(可选):定类变量(分组/标签)
- 放入待描述的变量:至少 1 个
数据要求
- 数据表至少 10 行。
- 本方法允许所选变量含缺失值——缺失本身就是分析对象的一部分,不会因为「完整记录不够」被拦下。
- 单列缺失率不超过 50%。
- 「放入[定类]分组变量(可选)」的类别数需在 2~20 之间。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 写临床研究、队列研究或随机对照试验的“研究对象基线特征”
- 观察性研究中寻找组间不均衡、可能需要在后续模型中校正的混杂因素
- 想一次性完成几十个变量的描述与组间比较,并保留每行检验方法的依据
不放分组变量时只做总体描述。正态性判定可以在控件中改为“全部按正态”或“全部按非正态”,用于与期刊要求统一口径。缺失值逐变量剔除,第一张卡给出每个变量的缺失例数。
什么时候不要用它
- 你关心的是某一个变量在两组间的差异及其效应大小:表 1 只给每行一个 p 值,深入分析请用「独立样本T检验」或「独立样本 Mann-Whitney U 检验」,它们给出完整的前提检验与效应量。
- 要在组间比较时同时校正其他因素:表 1 是逐变量的单因素比较,需要校正时改用「单因素与多因素回归」。
- 分组是同一批人前后两次测量:两组不独立,配对资料请用「配对样本T检验」或「配对卡方检验」。
- 只想看单个分类变量的列联表与多种卡方变体:用「卡方检验自动求解器」更完整。
容易误读的地方
- 随机对照试验的基线 p 值不是“随机化是否成功”的检验。 随机化之下任何基线差异都源于机会,CONSORT 声明不建议对基线做显著性检验;更合适的是只报告描述统计与 SMD(SMD<0.1 通常视为均衡)。本模块在结论卡写明了这一点,必要时可只取表中的描述列。
- 正态性判定随样本量变化。 每组几百例时,轻微偏离也会让 Shapiro-Wilk 给出 p<0.05,整行于是改报中位数;同一份数据样本小时却可能被判为正态。期刊要求统一描述口径时,用控件强制统一,并在方法学里写明。
- SMD 的口径要写清楚。 本模块的连续变量 SMD 用两组方差的平均作为分母(Austin 2009,与常用的 tableone 软件一致),与第四张卡用合并标准差的 Cohen's d 不同;示例中住院天数 SMD=0.437、吸烟 SMD=0.319,提示这两项在组间明显不均衡。
- 期望频数小于 5 时不要硬用卡方。 示例中“既往心肌梗死”只有 13 例阳性,2×2 表的最小期望频数低于 5,该行自动改用 Fisher 精确检验,统计量列显示为“-”,检验列标出对应的字母。
- 多个变量的 p 值没有做多重比较校正。 表 1 是描述性的,几十行里出现一两个 p<0.05 很正常,不应据此下“两组不可比”的结论,判断均衡性主要看 SMD。
- 百分比的分母是“该组该变量的有效例数”。 某变量有缺失时,各组百分比之和仍为 100%,但分母小于该组总例数;缺失较多的变量(示例中体质指数缺 7 例、吸烟缺 3 例)应在表注中写明缺失例数,第一张卡已逐变量列出,必要时先用缺失值处理方法补全再制表。
- 多分类变量只给一个总体 p 值。 例如肿瘤分期三个水平只有一行检验结果,它回答“各组的分期构成是否不同”,不回答具体哪一期不同;需要逐期比较时应另做两两比较并校正多重性,而不是在表 1 里逐格解读百分比差异。
- 数值编码的分类变量会被自动识别。 取值不超过 5 种的数值列(如 0/1 编码的性别、1~3 编码的分期)按分类变量报告 n(%);若它其实是连续量(如只有 4 个取值的评分),请在前端把变量类型标为定量。
报告里有什么
- 输出结果一:样本构成、缺失与检验选择
- 输出结果二:基线资料表(Table 1)
- 输出结果三:组间均衡性可视化(Love 图)
- 输出结果四:效应量
- 输出结果五:结论与学术表述
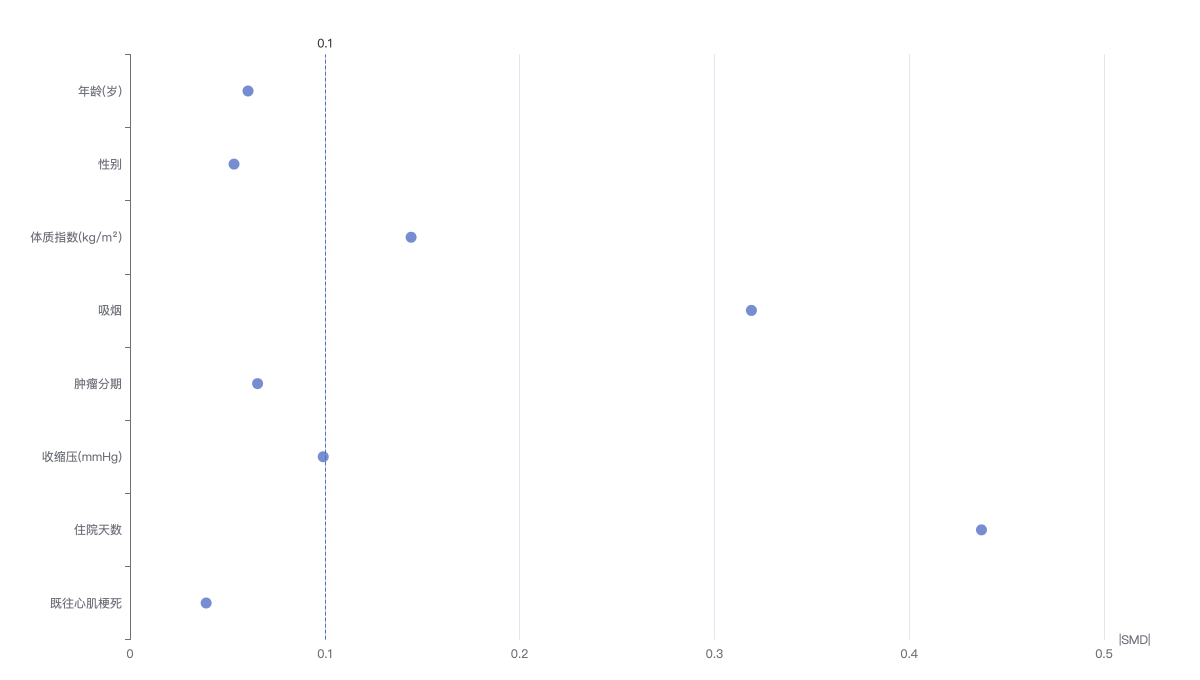
Love 图:每个点是一个变量的标准化均数差绝对值,虚线为 0.1 的常用均衡阈值。