

曲线估计
这个方法是做什么的
曲线估计用于描述一个自变量与一个因变量之间“不是直线”的关系,并在常见的曲线形式中挑出拟合最好的一种。本模块一次拟合 SPSS 曲线估计中的 11 种模型:线性、对数、倒数、二次、三次、幂、复合、S、增长、指数和 Logistic,也可以只选其中一种。每种模型都通过取对数或倒数转化为直线回归来估计,报告给出各模型的 R²、F 检验、参数估计,以及全部拟合曲线与观测散点的对比图。
需要特别注意的是:幂、复合、S、增长、指数和 Logistic 模型是在 ln(Y) 等变换尺度上拟合的,它们的 R² 与其他模型不在同一尺度,不能直接比较。为此报告另外计算了“原尺度 R²”——把拟合值换回原始 Y 后的解释比例——并以原尺度调整 R² 选出推荐模型,同时给出原尺度 AIC 排序、推荐模型的残差正态性、异方差和沿 X 排序的 Durbin-Watson 诊断。
需要准备什么数据
- 因变量 (Y) [定量]:1 个,定量变量(数值)
- 自变量 (X) [定量]:1 个,定量变量(数值)
数据要求
- 数据表至少 8 行。
- 单列缺失率不超过 30%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 散点图显示明显的弯曲趋势,想找一个简单的经验公式描述它
- 需要比较“边际递减”“指数增长”“饱和”等几种增长形态哪一种更贴合数据
- 论文需要报告“经曲线估计,以某模型拟合最优”这类结果
只需拖入一个因变量和一个自变量。对数、幂模型要求 X 全部大于 0,倒数、S 模型要求 X 不为 0,幂、复合、S、增长、指数与 Logistic 模型要求 Y 全部大于 0;不满足条件的模型会被跳过并注明原因。Logistic 模型的上限 u 留空表示无上限(与 SPSS 默认一致),填写时须大于全部 Y 值。
阅读顺序建议:先看第一张卡哪些模型因取值条件被跳过;再看第二张卡的模型汇总,注意区分线性化 R² 与原尺度 R² 两列;然后看第三张卡的拟合曲线是否穿过散点的主体,尤其是两端;最后看第四张卡的残差诊断和按原尺度 AIC 排序的模型比较。几种模型的原尺度 R² 相差不到 0.01 时,应优先选择形式更简单、参数有明确含义的那一种。
什么时候不要用它
- 有多个自变量:曲线估计只处理一个自变量。多个预测变量用「线性回归 (最小二乘法)」,必要时加入平方项或交互项。
- 需要更高次的多项式、两个自变量的曲面,或想逐次检验最高次项是否必要:用「拟合工具箱」,它支持 1~10 次多项式、两个自变量的多元多项式、按指标自动寻优和候选次数之间的嵌套检验,并给出参数的置信区间。
- 数据是按时间排列的序列、目标是预测未来:曲线估计不考虑序列相关。改用「指数平滑模型」,样本极少时可用「灰色预测模型GM(1,1)」。
- 因变量是二分类或计数:用「逻辑回归」或「计数数据回归」,不要用曲线估计硬拟合。
容易误读的地方
- 变换尺度上的 R² 不能跨模型比较。 SPSS 输出里幂模型的 R² 往往最高,但它是 ln(Y) 的解释比例;换回原始尺度后未必最好。挑模型请看原尺度 R² 或原尺度 AIC。
- R² 高不代表找到了真实机制。 几条曲线在样本范围内可能几乎重合,数据不足以区分它们,此时应根据专业知识选择有意义的函数形式,而不是只看第三位小数。
- 三次、二次模型不宜外推。 多项式在样本范围之外会迅速转向或发散,用它预测范围外的数值很危险;有明确上限或饱和机制时,优先考虑幂、对数或 Logistic 这类形态合理的模型。
- 乘法误差与加法误差的假定不同。 幂、指数等模型取对数拟合,隐含“误差随 Y 增大而按比例放大”;若误差其实是加性的,残差诊断会提示异方差或偏离正态,报告第四张卡可以帮助判断。
- Durbin-Watson 明显小于 2 时要警惕。 按 X 排序后残差成片同号,说明曲线形状没有抓住数据的走势,应换一种模型形式。
- 参数要在原始单位下解释。 幂模型的 b1 是弹性:X 增加 1%,Y 大约变化 b1%;指数与增长模型的 b1 是相对增长率。论文里报告这些参数时,应同时写明模型方程与变量单位,避免读者把它们当成线性回归的斜率。
报告里有什么
- 输出结果一:数据概览与模型适用条件
- 输出结果二:模型汇总与参数估计
- 输出结果三:观测值与拟合曲线
- 输出结果四:所选模型的诊断与模型比较
- 输出结果五:结论与学术表述
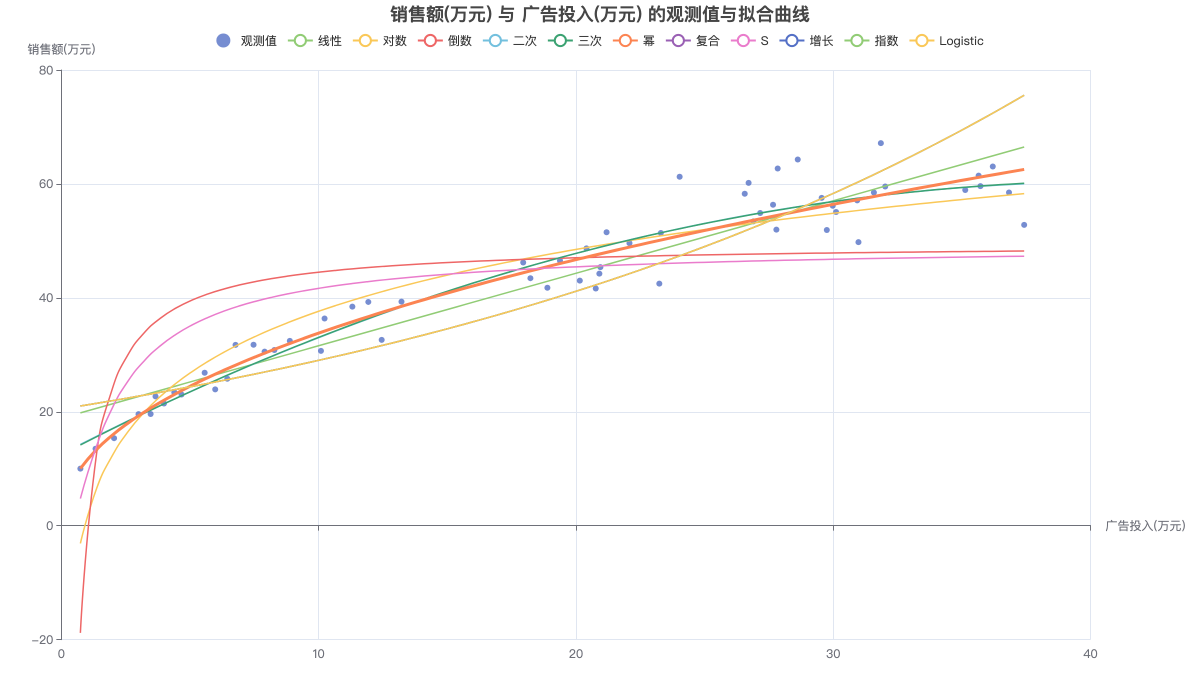
散点为观测值,各曲线为已拟合模型在 X 样本范围内的预测;加粗线为幂模型。