SPSS 决策树 CHAID 分析:树图与分类规则怎么读
SPSS 决策树里的 CHAID 用卡方检验挑出对目标区分作用最大的变量做多叉分裂,读树图就是从根节点沿分支走到叶节点,读分类规则就是把这条路径写成「若……且……则预测……」。本页用 240 行演示数据(模拟生成,不代表真实研究结论)走一遍,目标是「是否达成销售目标」,最终树深 3 层、7 个叶节点。
数据要怎么排
演示数据共 240 行、4 列,全部使用;.xlsx、.xls、.csv、.sav、.zsav、.por、.dta、.xpt 都能上传,每行一条记录。目标列只有 0 和 1 两类,其中 1 类 125 行,所以只猜多数类也能对 0.5208,后面的准确率要和它比。
| 列 | 类型 | 放进哪个区 |
|---|---|---|
| 是否达成销售目标(0 / 1) | 定类 | 放入目标变量Y |
| 广告投入(万元) | 定量 | 放入自变量X |
| 门店面积(平米) | 定量 | 放入自变量X |
| 促销类百分比列(单位 %) | 定量 | 放入自变量X |
SPSS 决策树 CHAID 怎么做
- 在左侧选 CHAID决策树,点「用演示数据试一试」载入数据。
- 把目标列拖进「放入目标变量Y」,三个自变量列拖进「放入自变量X」。
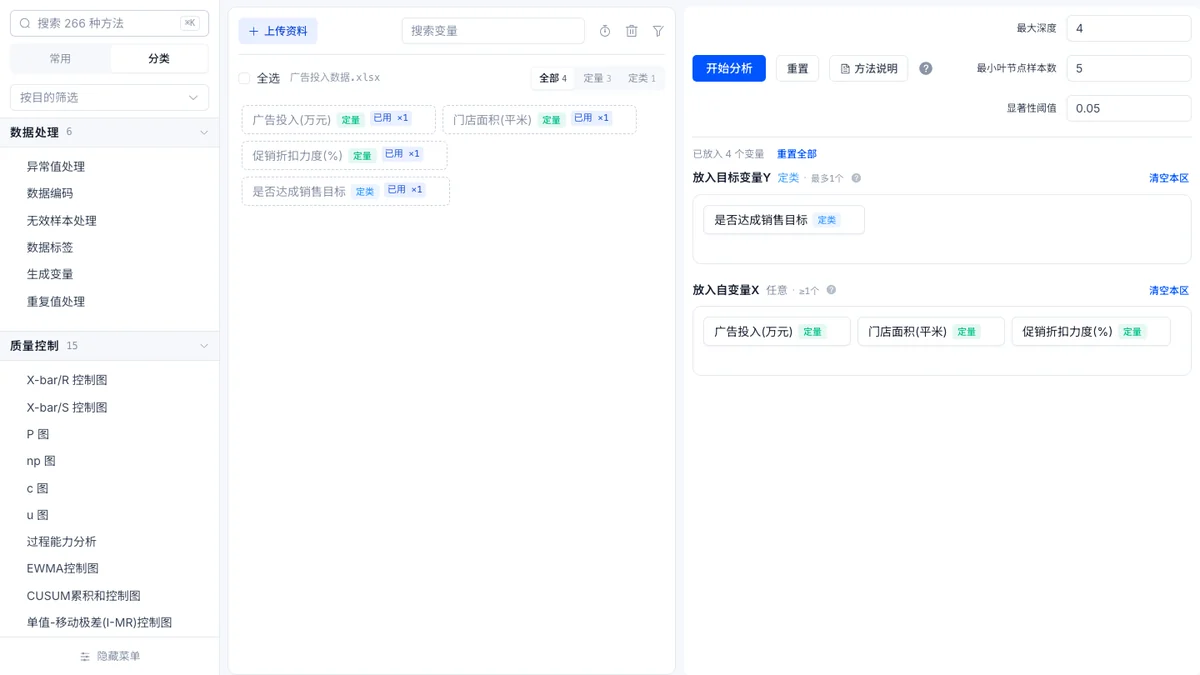
- 右侧三个选项依次是「最大深度」4、「最小叶节点样本数」5、「显著性阈值」0.05,载入演示数据时已是这组值。
- 点「开始分析」,从第三张卡开始读树图。
放好之后,工作台的状态如下:目标区放了一列,自变量区放了三列,三个选项都已设好。
树图怎么读
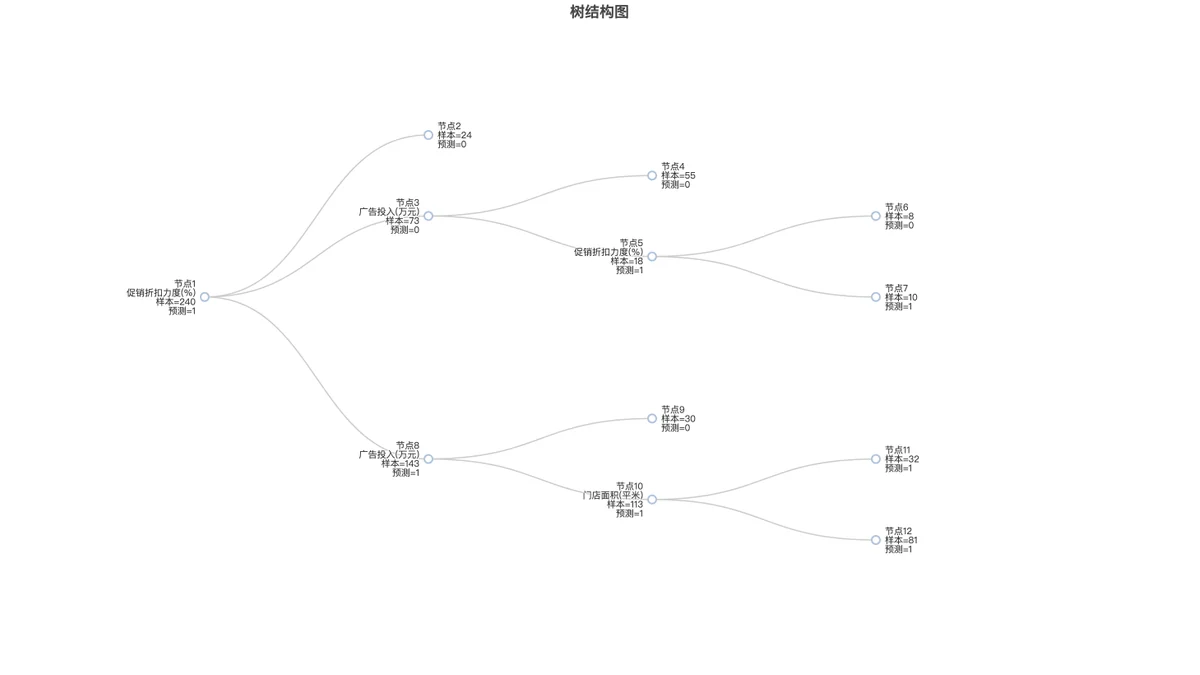
树图自左向右展开,每个节点标着编号、本节点的分裂变量、样本数和预测类别,叶节点没有分裂变量。
根节点(节点 1)用促销类百分比列一次分出三支,样本数依次是 24、73、143,分裂统计量 χ²=51.121,p<0.001。CHAID 对有序自变量只合并相邻的档,所以每一支的条件都是连续区间,比如节点 2 是不超过 13.09。节点 3 和节点 8 再用广告投入分叉,节点 10 用门店面积分叉。根节点选了谁,对数据扰动很敏感,不能据此断言它最重要。
分类规则怎么读
把一条根到叶的路径翻成文字,就是一条分类规则。节点 12 的路径是:促销类百分比列大于 18.7、广告投入大于 5.587 万元、门店面积大于 202.9 平米,预测达成目标(类别 1)。它覆盖 81 行,占全样本的三分之一强,其中 71 行确实是 1。7 个叶节点的样本数相加正好是 240,每个样本只落进一个叶节点,规则覆盖了全部数据。
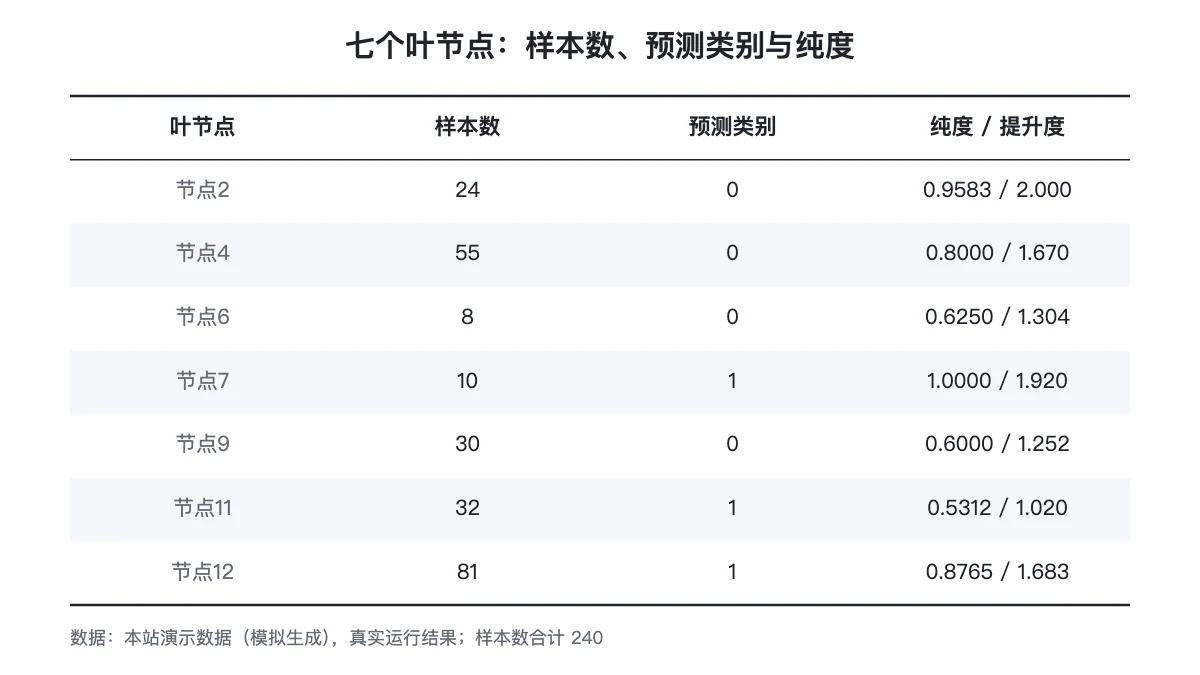
读规则要同时看样本数、纯度和提升度。纯度是叶节点里预测类别所占的比例,提升度是纯度除以该类在全样本中的占比,大于 1 才说明规则把目标类别富集了。节点 2 的提升度最高,24 行里 23 行是 0;节点 7 纯度达到满分,但只有 10 行,纯度由少数几行决定,换一批数据往往不成立;节点 11 的提升度接近 1,几乎等于随机分组。节点 4 与节点 9 都落在广告投入偏低的一侧,预测类别都是 0,但节点 9 的纯度只有 0.6000,把握比节点 2 低得多,写进业务规则前应先用新数据复核。
交叉验证与变量重要性怎么看
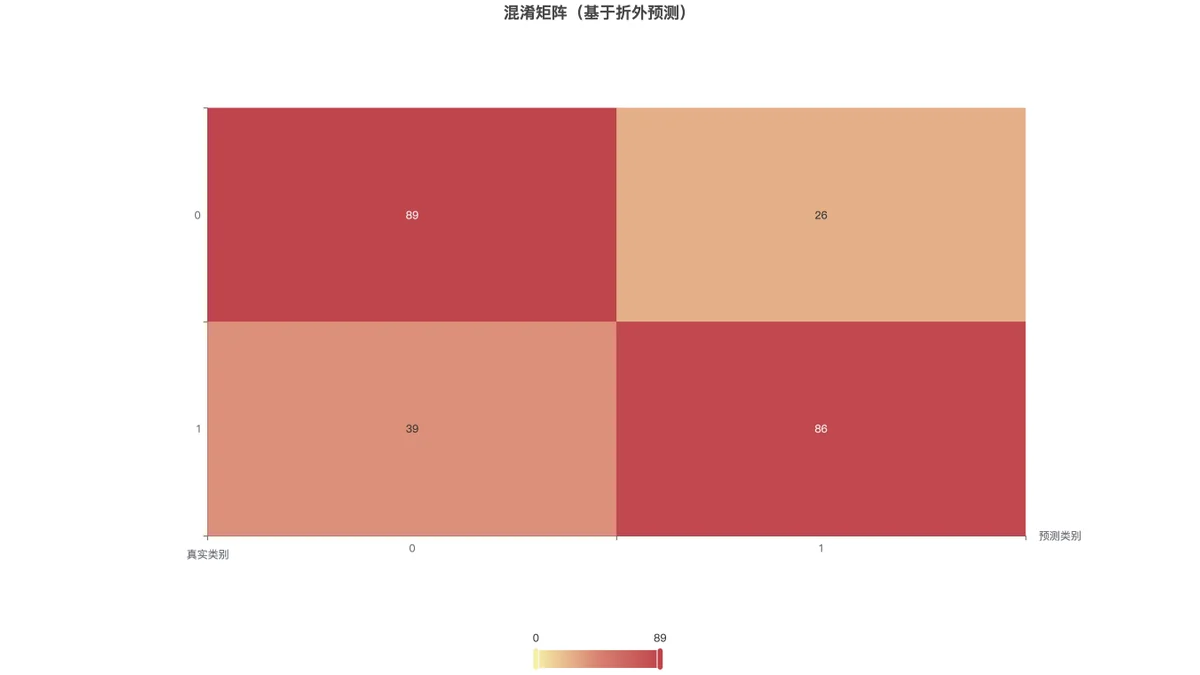
性能以 5 折交叉验证的折外结果为准:准确率 0.7292 ± 0.0642(95%CI [0.6494, 0.8089]),高于无信息率;训练集回代是 0.7833,只用来看过拟合幅度。矩阵里真实为 0 的 115 行预测对 89 行,真实为 1 的 125 行预测对 86 行,所以类别 1 的召回率 0.6880 低于类别 0 的 0.7739。置换重要性里,促销类列 0.16481、广告投入 0.15360 靠前,门店面积是 0.00000:它在节点 10 参与了分裂,但两个子节点预测的都是类别 1,打乱这一列预测标签不变。
论文里怎么写
把 SPSS 决策树的结果写进论文,给出折外指标、树的规模和根节点变量即可,下面的句子可照抄。演示数据不用登录就能跑;用自己的数据分析、导出 Word / PDF 报告、使用 AI 解读需要开通会员。
以「是否达成销售目标」为目标变量、3 个自变量构建 CHAID 决策树(最大深度 4,最小叶节点样本数 5,α=0.05)。5 折分层交叉验证的折外准确率为 0.7292(95%CI [0.6494, 0.8089]),高于无信息率 0.5208,逐折平均的 ROC-AUC 为 0.7769。树深 3 层、7 个叶节点,根节点的分裂变量为促销类百分比变量。
CHAID 常见错误
- 把节点 p 值当成变量显著性。每个节点都在全部自变量上择优,p 只拿来比较同一节点上候选分裂的强弱。
- 只报训练集准确率。训练集读数偏高,以折外指标为准,并与无信息率对照。
- 照字面落地小叶节点的规则。先看样本数,几行样本撑起的纯度不稳。
- 想要精确切点。定量自变量会先切成至多 10 个区间,树里给不出精确到小数的切点;要精确阈值用「C&RT决策树」。
- 只关心预测准不准。单棵树对数据很敏感,可以对照 SPSS 神经网络。
延伸阅读
常见问题
CHAID 的分裂 p 值能当成变量显著性吗?
不能。分裂 p 只校正了类别合并这一层的多重比较,每个节点择优、逐层检验这两层都没有校正,只适合比较同一节点上候选分裂的强弱。
分类规则怎么从树图里读出来?
从根节点沿一条分支走到叶节点,把途中每个分裂条件用「且」连起来,叶节点的预测类别就是结论;再看样本数、纯度和提升度,判断规则可不可信。
SPSS 决策树的准确率看训练集还是交叉验证?
以交叉验证的折外指标为准。训练集回代的读数只用来观察过拟合幅度,拿它评价模型会系统性偏高。