SPSS 期望频数小于5怎么办:卡方检验改用 Fisher 的判断
更新于
期望频数小于5怎么办?先看表有多大:2×2 表任一格期望频数小于 5,改用 Fisher精确检验;更大的表,先把语义相近的低频类别归并。以下结果来自本站演示数据(模拟生成,不代表真实研究结论):300 行里随机抽取 255 行(85%),看吸烟状况与疾病严重程度的列联表,本例没有出现这个问题,用来示范怎么在报告里核对。
期望频数小于5怎么办:先在报告里看期望频数
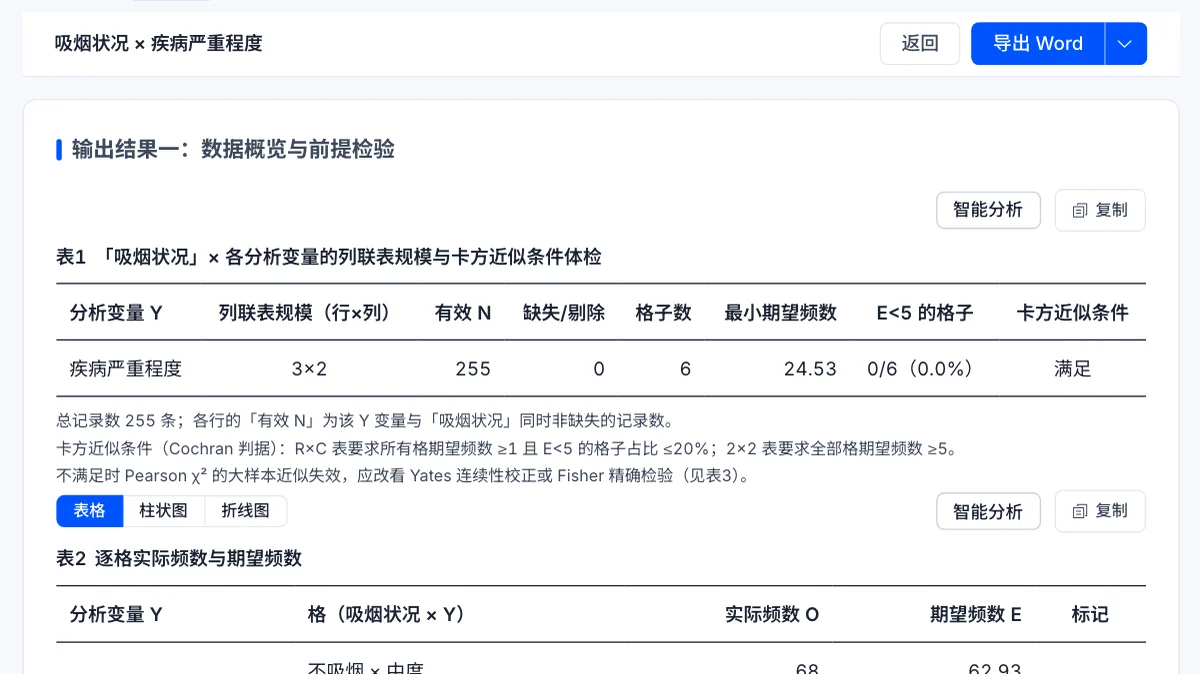
做卡方检验时,报告第一张卡的第一张表给出列联表规模和近似条件:本例是 3×2 表,共 6 个格,最小期望频数 24.53,期望频数小于 5 的格子 0/6,卡方近似条件一栏是「满足」。出问题时,这一栏显示不满足,第二张逐格表的最后一列「标记」会在对应格子写上 E<5。
原因:期望频数小会有什么问题
Pearson 卡方统计量靠大样本近似才服从卡方分布,每一格的期望频数都要足够大,这个近似才站得住。期望频数是两个变量毫无关系时本该有的人数,某格期望太小,这个近似就不可靠,算出的 p 值会失真。所以报告要先体检这一项。
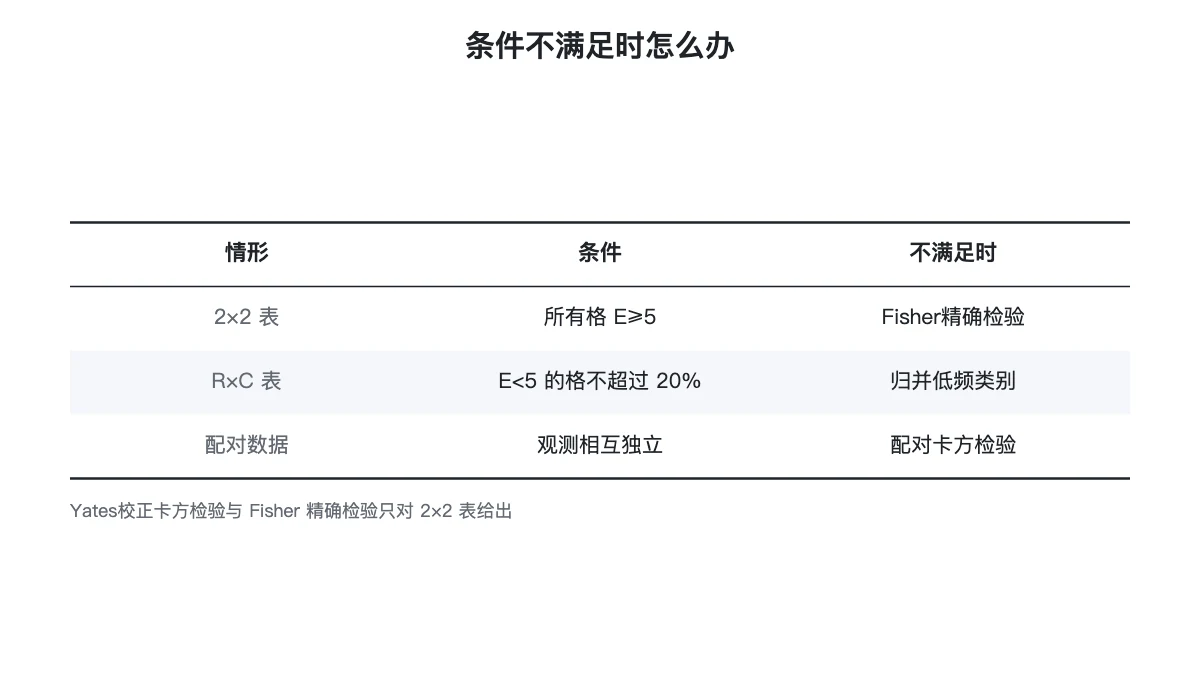
2×2 表要求所有格的期望频数不低于 5;更大的 R×C 表要求所有格不低于 1,且小于 5 的格子占比不超过 20%。同一批人测了两次的配对数据,则是独立性不满足。三种情形的做法见下表。
解决步骤
- 在报告第一张卡看「卡方近似条件」一栏和逐格期望频数,确认哪些格子小于 5。
- 2×2 表改用「Fisher精确检验」,「Yates校正卡方检验」只是更保守的近似;更大的表,在数据处理的「数据标签」里把语义相近的低频类别归并成一类,再重跑卡方检验。
- 重跑后再看第一张卡的最小期望频数,直到近似条件显示满足。
2×2 表时不用另跑:第二张卡的统计量汇总表里有一列「2×2 表的校正/精确检验」,Yates 校正和 Fisher 精确检验的结果都在这一列,直接读它。本例是 3×2 表,这一列显示「—」。
归并类别时要注意什么
归并时只合并语义相近、人数少的类别,例如把相邻的两个低频等级并成一类,并在论文里写明合并规则。合并后类别数变少,表的大小可能由 3×2 变成 2×2,这时判据也跟着换成 2×2 的要求:所有格的期望频数不低于 5。
合并后要回到第一步:重新数格子、重新看最小期望频数,因为表的大小变了,原来的判据可能已经不适用。
合并不是为了凑出显著,同一个合并方案要在看结果之前定下来;先看结果再换方案,等于把多次检验藏了起来。
怎么确认已经解决
三个判据:最小期望频数满足上面对照表里对应表的要求;Pearson χ² 与似然比 G² 的结论一致;归并类别后每个类别仍有足够的人数。三条都过关,这一步就算处理完。
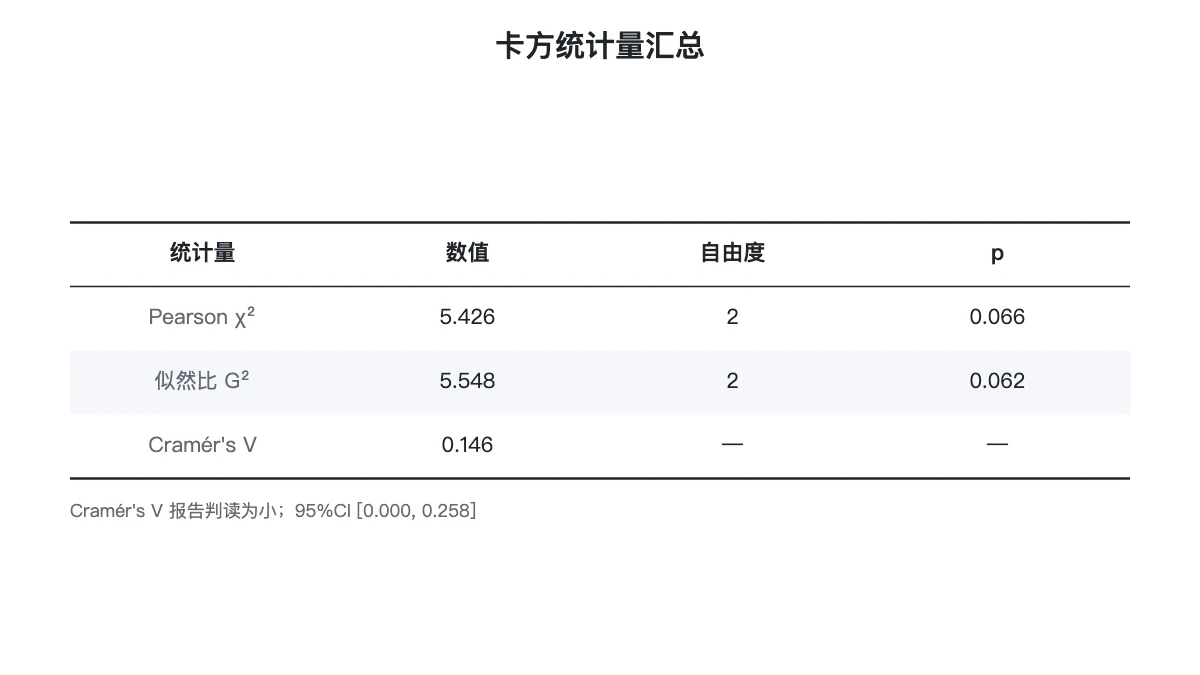
本例都满足,统计量汇总如下图,不需要换方法。p 大于 0.05 只说明没有发现关联,不能写成两个变量无关。
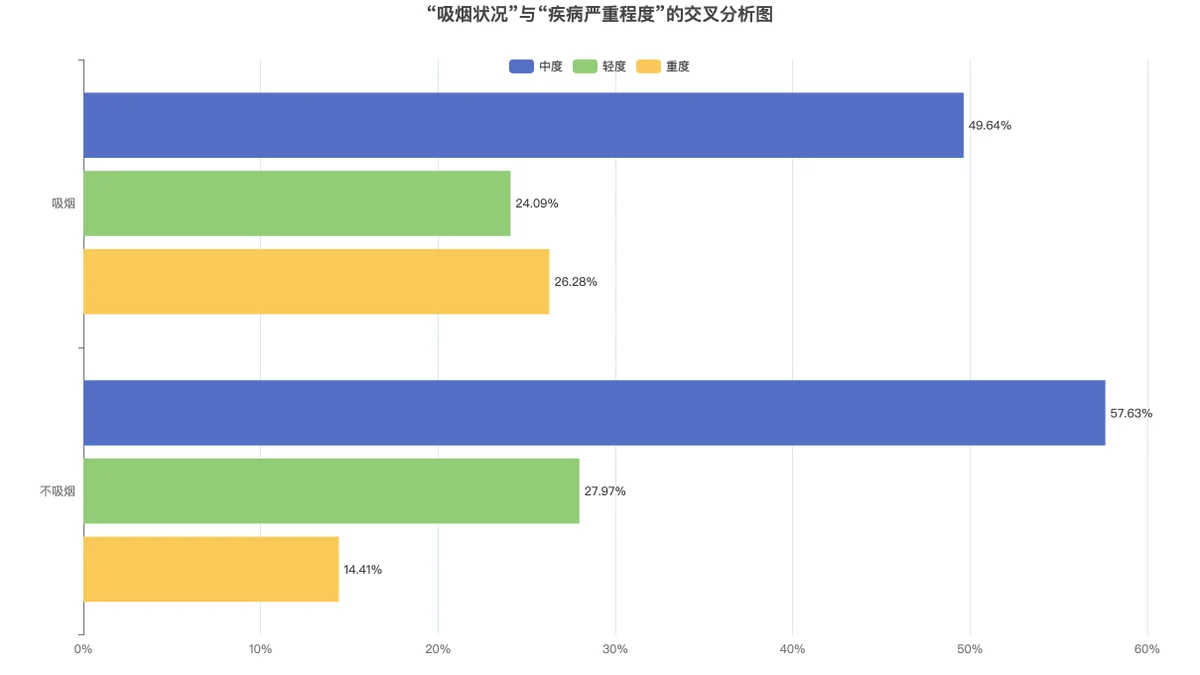
各格的列百分比如下,纵轴是吸烟状况的两个类别,横轴是列百分比,颜色是疾病严重程度,每个类别内三种严重程度的占比合计为整。重度的比例在吸烟组更高,但整体差异没有达到显著。
期望频数常见错误
- R×C 表硬套 Fisher 或 Yates:这两项只对 2×2 表给出,本例 3×2 表对应列显示「—」,不是计算失败。
- 归并时只看人数不看含义:把重度和轻度并成一类就改变了研究问题,只合并语义相近的低频类别。
- 归并后忘了回头重看第一张卡:类别变少后表的大小可能变了,判据也跟着换,要按新的表重新核对。
- 以为 Yates 校正能救小期望频数:它只是让 p 值更保守;2×2 表要稳妥,改用 Fisher精确检验。
把结果带进论文:导出与会员
交叉表、统计量汇总表和效应量表导出后可以放进论文,近似条件的核对结果写进方法部分。分析和查看结果不用登录;开通会员后可导出 Word / PDF 报告、使用 AI 解读。
延伸阅读
- 卡方检验结果解读
- 卡方检验帮助文章:五张卡与全部判定规则
常见问题
- 期望频数小于5怎么办?
- 先看表的大小。2×2 表任一格的期望频数小于 5,改用 Fisher精确检验;Yates校正卡方检验只是让近似更保守,并没有解决期望频数小的根本问题。更大的表,若有格子期望频数小于 1,或小于 5 的格子超过 20%,先把语义相近的低频类别归并,再重做卡方检验。
- 卡方检验的近似条件在哪里看?
- 在报告第一张卡,那里有「最小期望频数」「E<5 的格子」和「卡方近似条件」三列,另有一张逐格期望频数表。本例最小期望频数为 24.53,0/6 个格子小于 5,条件满足。
- 本站的 Fisher精确检验能用在 R×C 表上吗?
- 本站的 Fisher 精确检验和 Yates 连续性校正只对 2×2 表给出,R×C 表的对应列固定显示「—」,这是报告没有给出,不是计算失败了。