SPSS 频数分析表怎么看:百分比和累计百分比
频数分析表只回答一个问题:这一列的取值是怎么分布的。每个选项出现多少次、占有效样本的百分之几、累计到多少,再配一个 95% 置信区间。下面用 150 份演示问卷,说明频数分析表怎么读,尤其是百分比和累计百分比容易读错的地方。
数据要怎么排
一行一个被访者,一列一个分类变量,放进「放入需要分析的变量」;多个变量一次放进来,各自独立计数。方法说明见频数分析。
| 列名 | 类型 | 放进哪个区 |
|---|---|---|
| 学历层次 | 定序,需核对教育层级 | 放入需要分析的变量 |
| 所在区域 | 定类,无自然高低 | 放入需要分析的变量 |
| 满意度等级 | 定序 | 放入需要分析的变量 |
以下结果来自本站演示数据(模拟生成,不代表真实研究结论):150 条记录,3 个变量,缺失都是 0;学历层次与所在区域各 4 类,满意度等级 5 类。
频数分析表怎么看:三步
- 在方法列表里选「频数分析」,把分类变量拖进「放入需要分析的变量」区;「数值类型」可选频数或百分比,「图表类型」可选柱形图、折线图、条形图、饼图。
- 先看第一张卡:有效样本数、缺失数、类别数,以及有没有占比不足 1% 的类别。
- 再读频数-百分比三线表,最后看集中度指标描述分布。演示数据不用登录就能跑;用自己的数据分析、导出 Word / PDF 报告、使用 AI 解读需要开通会员。
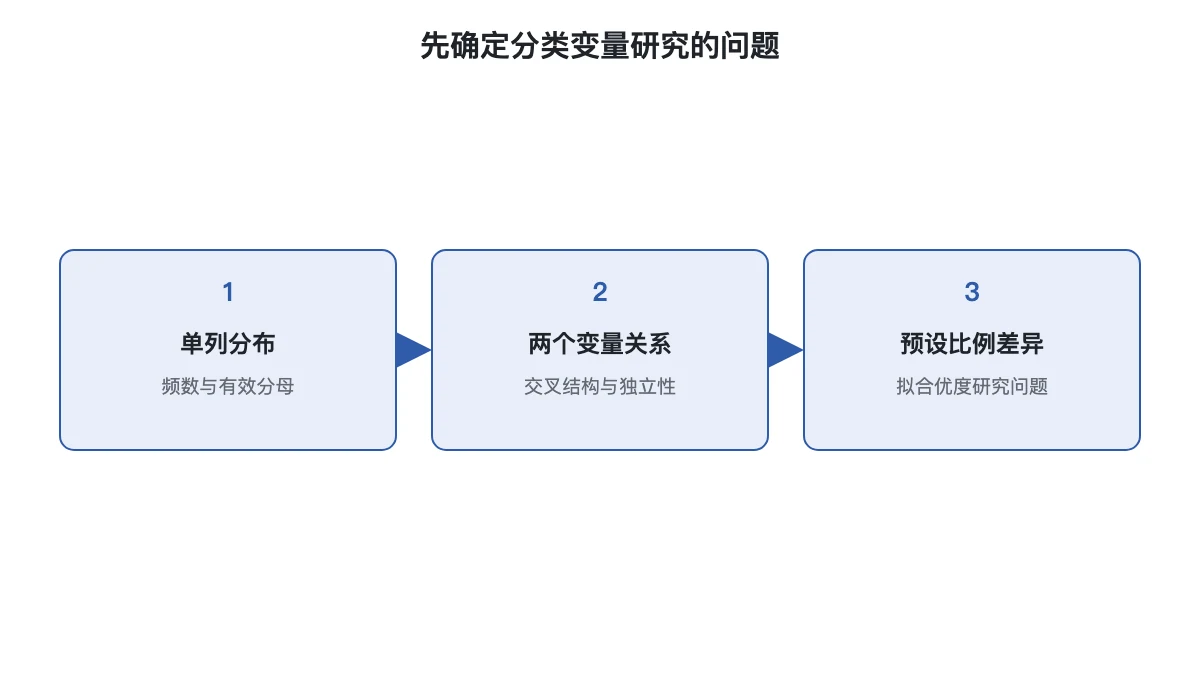
在本次资料中,学历层次、区域和满意度分别独立统计。把它们放在同一份报告里,并不意味着报告已经交叉比较不同学历或地区的满意度;若研究问题涉及两个变量的关系,应另行选择匹配的方法,并保持同一分析对象与编码口径。
频数、百分比与占比置信区间
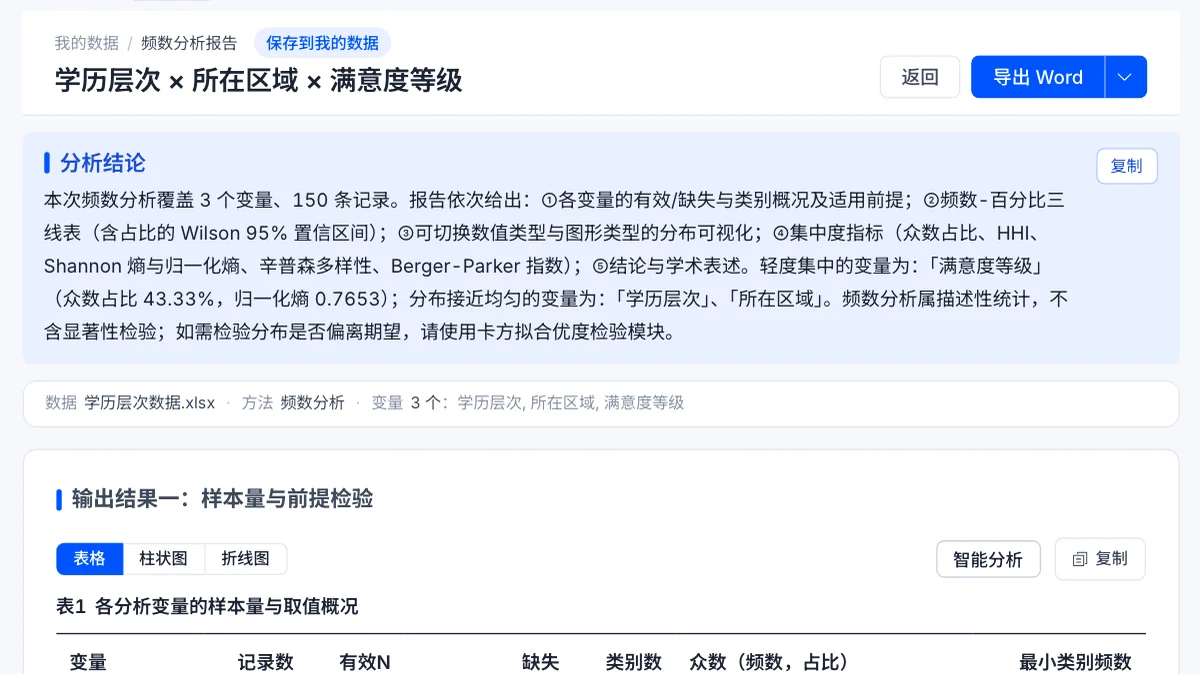
频数表每个选项占一行,列出频数、百分比、占比 95% 置信区间和累计百分比。学历层次的四类几乎相等:博士与大专各 37 人(24.67%),本科与硕士各 38 人(25.33%)。所在区域同样接近均匀,华东与华南各 38 人,华北与西部各 37 人。
满意度等级差异明显:满意 65 人,占 43.33%,区间 [35.67%, 51.33%];非常满意 44 人(29.33%),一般 33 人(22.00%),不满意 7 人(4.67%),非常不满意只有 1 人(0.67%),区间宽达 [0.12%, 3.68%]。对这项稀少回答,区间应与频数一同报告。区间采用 Wilson 得分区间,小样本和极端比例下比常见的 Wald 区间更可靠。
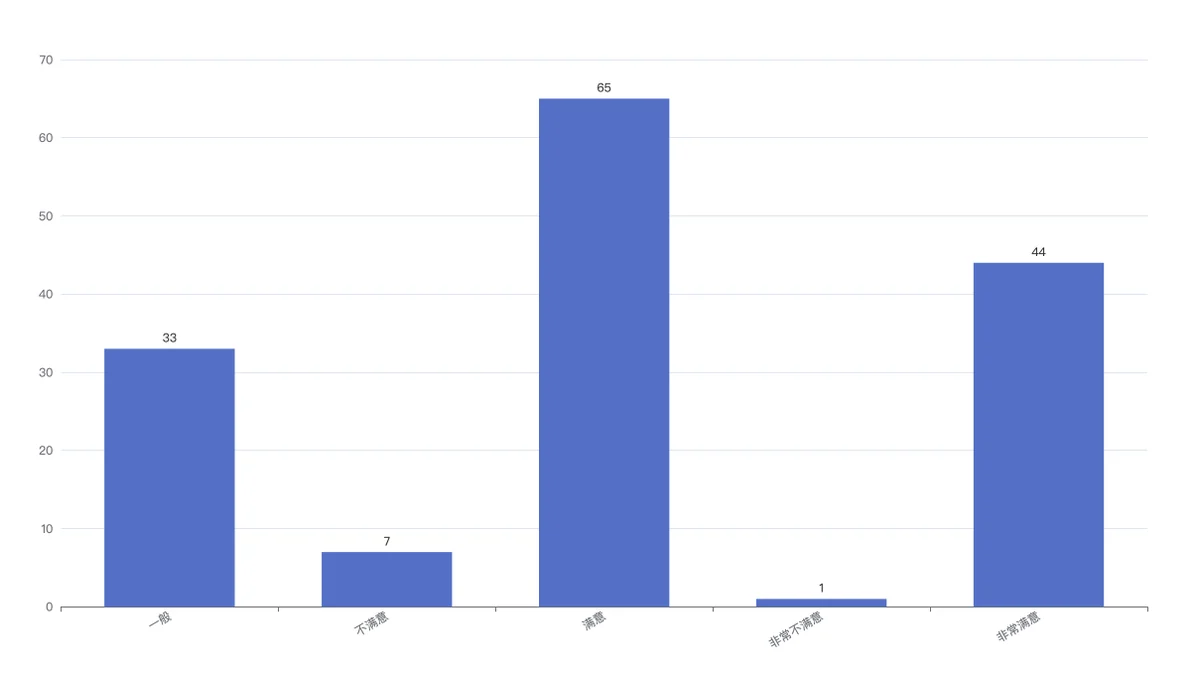
学历的柱状图呈现另一种分布形态:四类柱高接近,适合先描述各类别构成。图中类别是本次数据的显示顺序,不能从横轴位置推断学历高低。
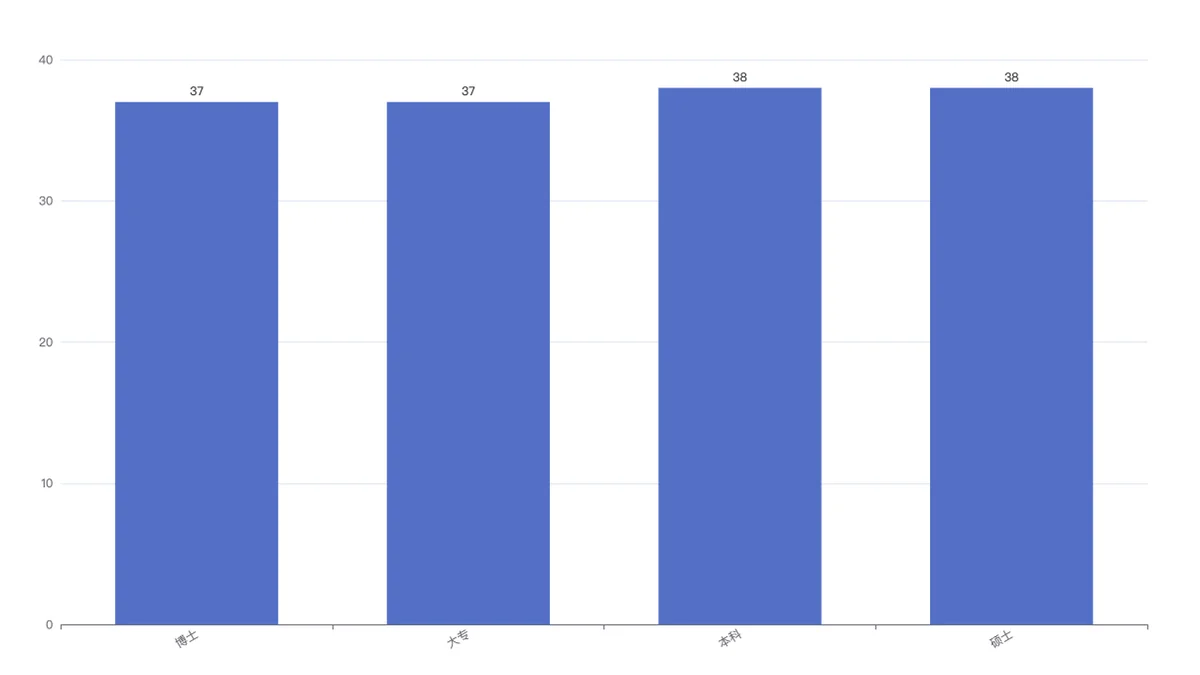
第一张卡还会提示极低频类别:满意度等级里非常不满意只占 0.67%,不足 1%,解读时不宜强调它,是否合并需要根据类别含义事先说明,稀少本身并非合并依据。分母是各变量自己的有效样本数,本例缺失都是 0,所以三个变量的分母都是 150;缺失率高时,百分比只代表回答了这道题的人。
累计百分比:先看排序再读
累计百分比先取决于展示顺序,再取决于频数。区域没有自然高低顺序;学历则有大专、本科、硕士、博士的层级,满意度也有从负向到正向的等级。变量本身有序,与产品当前显示是否按语义排好,是两件需要分别核对的事。
本次学历表的实际顺序和数值如下,它保留报告原貌,尚未按教育层级重排:
| 当前显示行 | 频数 | 本行百分比 | 报告累计百分比 |
|---|---|---|---|
| 博士 | 37 | 24.67% | 24.67% |
| 大专 | 37 | 24.67% | 49.33% |
| 本科 | 38 | 25.33% | 74.67% |
| 硕士 | 38 | 25.33% | 100.00% |
例如累计至本科时,前面的博士也已被计入,所以该格不能解释成“本科及以下”。这是显示顺序与研究问题不匹配的具体例子,而不是累计公式算错;只读末行的合计也发现不了这种语义错误。
代码对类别字符串排序,操作上可先保存一份带顺序前缀的标签副本,例如学历写成「1-大专、2-本科、3-硕士、4-博士」,满意度写成「1-非常不满意」到「5-非常满意」,再重新运行并核对报告逐行顺序。本文没有对重编码副本另跑结果,上表与配图均保留原始运行;写论文时应说明实际采用的标签与顺序。
下图区分按一列计数与按两个变量交叉研究的入口。频数表里的占比仍以本篇结果为准。
集中度:分布有多均匀
报告用归一化熵衡量分布的均匀程度:学历层次与所在区域都是 0.9999,判定为分布接近均匀;满意度等级是 0.7653,众数比例见前表,判定为轻度集中。判定档位是经验参考,归一化熵不低于 0.90 为接近均匀,0.70 到 0.90 为轻度集中。
本次学历和区域的归一化熵相同,仍不是同一个研究变量:前者有层级、后者没有,二者边际计数恰好相同也没有表达它们之间的关系。集中度只描述单列分布,不修复标签排序。
论文里怎么写
对 150 名被试的 3 个分类变量做频数分析。满意度等级中,满意者最多(65 人,43.33%,95%CI 35.67% 至 51.33%),其次为非常满意(44 人,29.33%);学历层次与所在区域分布接近均匀。百分比以各变量有效样本数为分母,缺失值已按列剔除。
写频数表时同时给出频数与百分比,并说明分母口径;只给百分比不给 N 是常见缺陷。
频数分析常见错误
- 把连续变量拖进来:几乎每个取值只出现一次,输出变成原始数据清单,应先分箱。
- 对学历累计值直接写本科及以下:先对照前缀和实际显示顺序,确认累计包含哪些层级。
- 把「A 类多于 B 类」写成「显著多于」:本报告未检验两类占比之差,应将数量高低写作描述性比较。
延伸阅读
常见问题
累计百分比对所有变量都有用吗?
不是。它按表中选项的排列顺序逐项累加,只有选项按等级排好才有意义。本例满意度等级被排成一般、不满意、满意等,累计到满意的 70.00% 并不是满意及以下的占比。
百分比的分母是总人数吗?
是各变量自己的有效样本数。缺失按列剔除,不同变量的分母可以不同。本例三个变量缺失都是 0,分母都是 150。
占比的置信区间能比较两个类别吗?
不能直接比。区间回答的是这一类在总体里占多少,不是两类是否不同。本例非常不满意只有 1 人,区间 [0.12%, 3.68%] 提示的是样本太少。