SPSS 神经网络多层感知器:隐藏层与预测准确率
更新于
SPSS 神经网络相关任务可用多层感知器建立预测映射,隐藏层是模型设置,预测准确率则应看未参与训练的观测。本例用独立平台 SPSSAI 演示固定结构的分类网络,区分交叉验证表现与训练回代,避免把“拟合得好”写成“外部预测已验证”。
多层感知器的样本与变量类型
以下结果来自本站演示数据(模拟生成,不代表真实研究结论),使用全部 240 行客户分层记录。目标是客户分层编码,另外三列按演示文件顺序作为候选特征;本次保留原表数据与字段,没有更改列名、重编码类别或另行挑选子集。
| 数据部分 | 本例角色 | 检查重点 |
|---|---|---|
| 客户分层编码 | 分类目标 | 编码表示类别而非等距分数 |
| 原表其余三列 | 输入特征 | 对照报告的测量尺度 |
| 一行客户记录 | 观测单位 | 训练与验证间保持对象独立 |
报告把月均登录次数识别为定量,把客服工单数识别为定类,后者按水平编码,而非直接保留数值顺序。正式应用时应核对测量尺度与研究含义是否相符;数字列也可能表示类别,单凭单元格里能否作加法不宜决定网络任务与变量角色。
在工作台复现隐藏层设置
- 选择「多层感知器(MLP)」,载入演示数据,保持目标为客户分层编码,其他列为输入特征。
- 保持分类任务;隐藏层结构填写 64,32,非线性函数设为 relu,L2 强度为 0.000100,最大迭代为 500。
- 开始分析后核对变量角色、交叉验证设置与样本数,再读性能表和混淆矩阵,而非直接引用训练集列。
本模块没有自动搜索超参数,本次也没有比较其他隐藏层。结构中的两个数分别表示两层的宽度,不是训练样本分组;交叉验证每折重新拟合网络,使用相同结构也会得到不同权重,折间性能因此存在波动。
SPSS 神经网络的预测准确率看哪一列
本次采用 5 折分层交叉验证,种子为 42。准确率均值为 0.7667,折间 SD 为 0.0632;训练集回代准确率为 0.8667。前者来自每折未参与训练的数据,后者来自模型已见数据,两者的差距用于提醒乐观拟合,不宜把后者替换为主要性能结论。
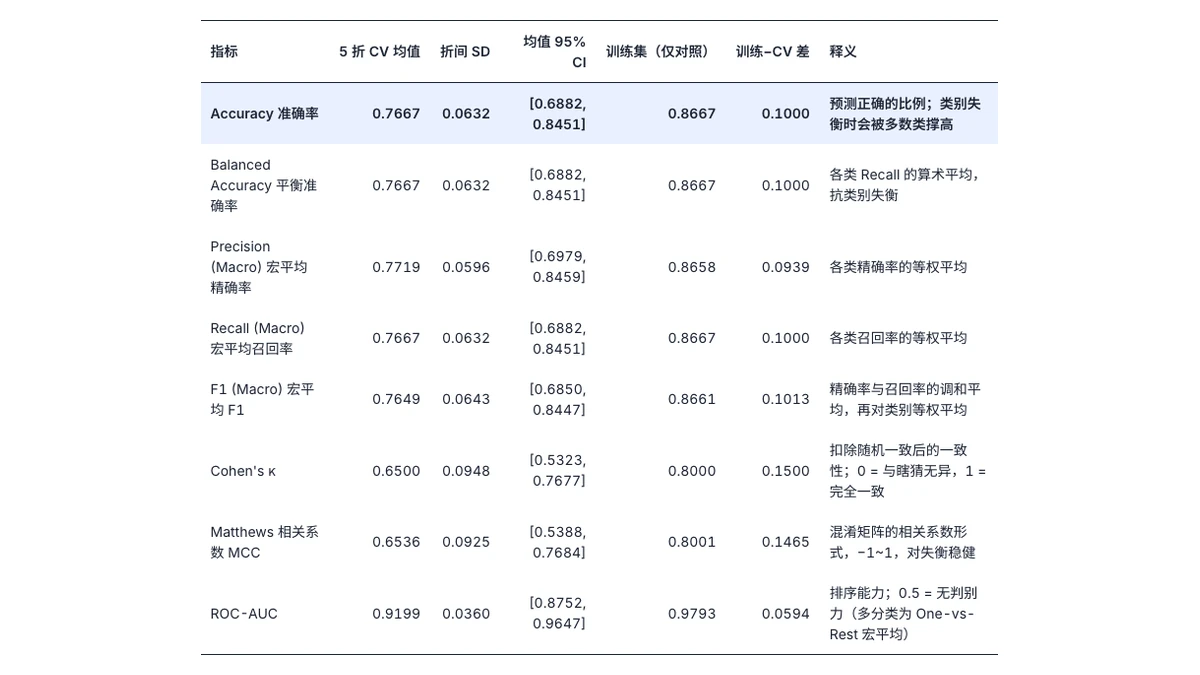
报告的预处理管道在训练折内拟合,再用于相应验证折;这一点控制的是跨折预处理信息流。它没有检查研究采样中所有可能的泄漏,例如同一客户的多期记录混入不同折,仍需在分组或时间验证方案中处理,而非只依赖自动筛查。
宏平均 F1 为 0.7649,折间 SD 为 0.0643。该指标先分别评价每个类别再等权平均,与总体准确率承担不同任务;本例三类均衡,也应检查哪些类别误判更多,避免总体指标掩盖特定类别的识别不足。
折外混淆矩阵怎样定位误判
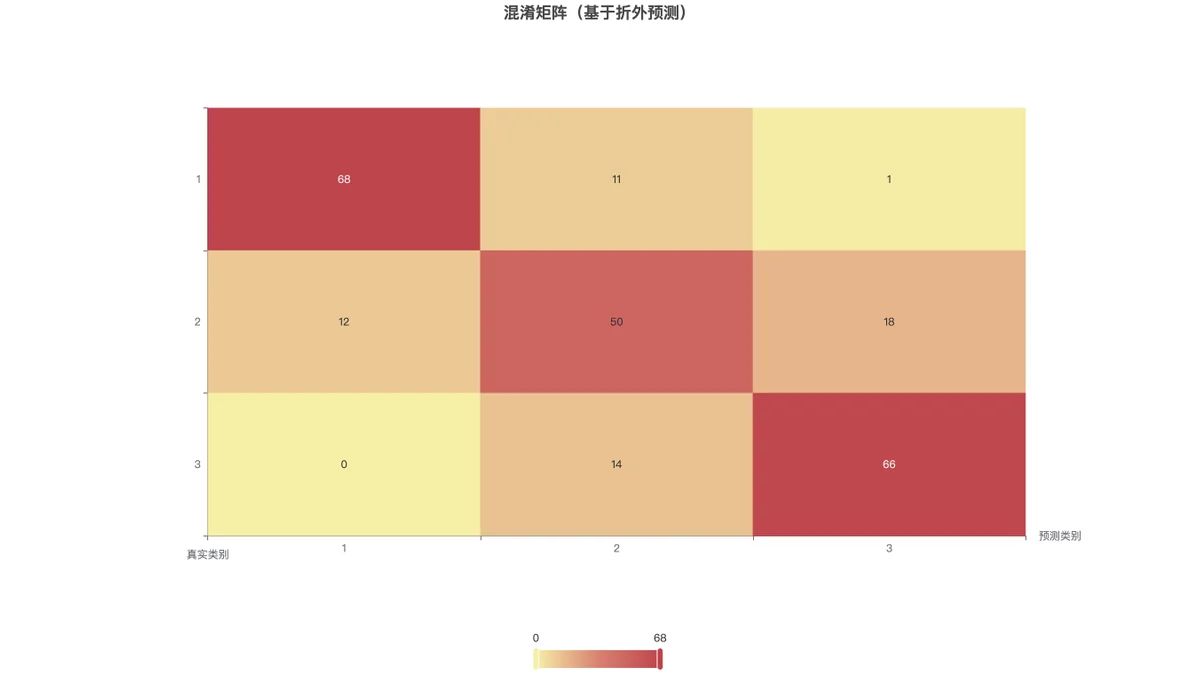
混淆矩阵行是真实类别,列是预测类别,对角线为正确分类,非对角线为误判。它汇总每个对象在未参与训练的那一折的预测,属于折外结果;它不是独立留出测试集,也不是全样本网络的回代矩阵,文章与表注需保留这一来源。
类别二的召回率为 0.6250,相较其他类别更低,适合回查其与相邻类别的特征重叠。类别编码只是标记,不宜据“二处于中间”就推导误判有固定距离;是否某类错误代价更高,应根据应用目标提前确定,而非由混淆矩阵自动给出。
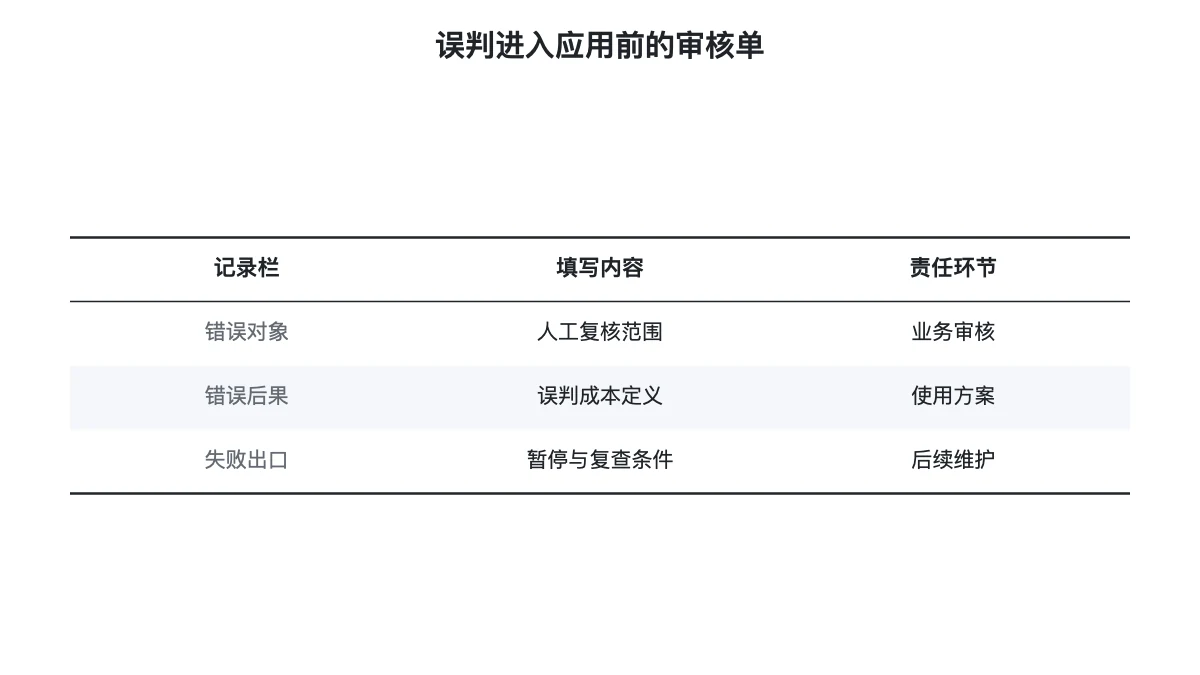
记录表增加的是验证数字之外的应用信息,要求先留下误判对象与后续动作。它不把训练得分换算成业务收益,也没有替模型自动选阈值;正式使用前还需定义人工复核与失效处理,避免仅因平均指标可读就直接进入实际决策。
隐藏层与迭代上限怎样写进论文
可写:「使用预设的双隐藏层结构进行分类,按分层交叉验证报告准确率及折间波动,训练回代仅作对照;本次未进行自动调参或独立外部验证。」写清固定设置比把结构描述为搜索得到的方案更可复核,也保留了性能估计的适用范围。
最大迭代是优化上限,不是模型已经收敛的证明。当前报告的摘要提示是常驻文案,不宜视为逐次收敛诊断;正式研究需核查优化告警并按预定验证方案评价调整,反复看同一份交叉验证得分挑结构会引入选择偏倚。
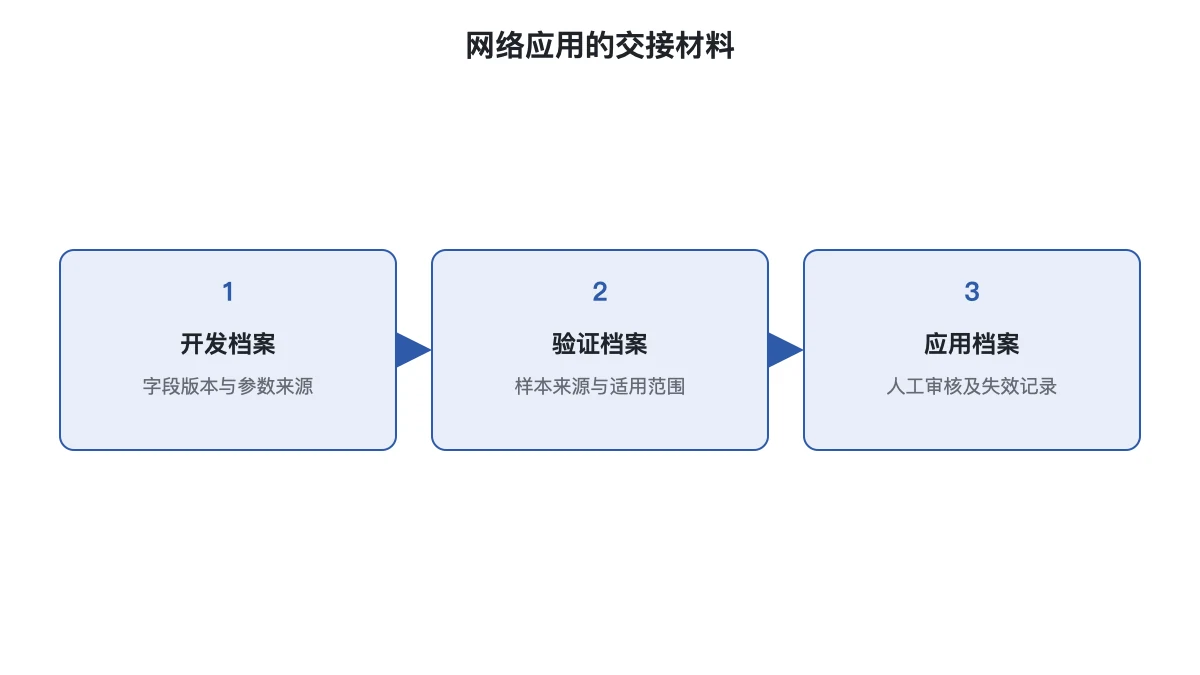
该流程把开发、验证和实际应用的材料分开,避免一份交叉验证被重复称为多次独立验证。置换重要性来自全样本最终模型,另有乐观性,不宜用它推出变量因果作用;演示数据不用登录就能跑;用自己的数据分析、导出 Word / PDF 报告、使用 AI 解读需要开通会员。
神经网络预测常见错误
- 用训练准确率宣布泛化能力:保留交叉验证均值及波动,外部用途仍需另行验证。
- 把类别编码当连续评分:先明确任务和测量尺度,避免让数字标签引入未定义的等距假设。
- 将未计算指标当成没有问题:有有效估计时按相应证据解释,无法估计则说明原因并停止作性能结论。
延伸阅读
常见问题
- SPSS 神经网络中的隐藏层越大越好吗?
- 网络结构只是预设模型的一部分,层数和宽度增加会改变拟合能力及优化难度,应按独立验证方案比较,而非仅追求训练集表现。
- 多层感知器预测准确率看哪一列?
- 优先读取交叉验证的均值及折间波动,训练集回代只作对照。类别失衡时还应同时检查宏平均指标和逐类召回。
- 类别编码可以直接当连续结局回归吗?
- 编码的数字大小未必有等距意义,先按研究问题确认任务类型。本例目标是客户类别,应保持分类设定。