SPSS 逻辑回归和线性回归的区别:因变量类型决定用哪个
更新于
逻辑回归和线性回归的区别,首先取决于因变量的类型:因变量是数值,用线性回归;因变量只有两类结局,比如复发与未复发,用逻辑回归。两者的模型形式、结果解读与拟合指标都不相同。先说明本页的演示:只运行了「逻辑回归」,没有线性回归的运行结果,下面用 255 例的数据展示逻辑回归怎么读,线性回归一侧只对照读法。
数据要怎么排
自变量两者要求相同,可以是连续变量,也可以是分类变量;区别在因变量。方法说明见逻辑回归。
| 列名 | 类型 | 放进哪个区 |
|---|---|---|
| 是否复发 | 二分类因变量 | 放入因变量Y |
| 年龄(岁)、肿瘤直径(cm)、术前CEA(ng/mL) | 连续自变量 | 放入或自变量X |
本例事件 122 例、非事件 133 例,事件率 47.84%。报告把「复发」自动编码为 0(参照),「未复发」编码为 1(事件);要改变方向,在「事件类别」里填要作为事件的那一类。
逻辑回归怎么做:四步
- 在方法列表里选「逻辑回归」,把「是否复发」拖入因变量区,三个自变量拖入自变量区。
- 在「事件类别」里确认哪一类作为事件,本例用报告的默认编码,事件是「未复发」。
- 点开始分析。
- 先读事件数与前提,再读 OR 与区间,最后读拟合与区分能力。
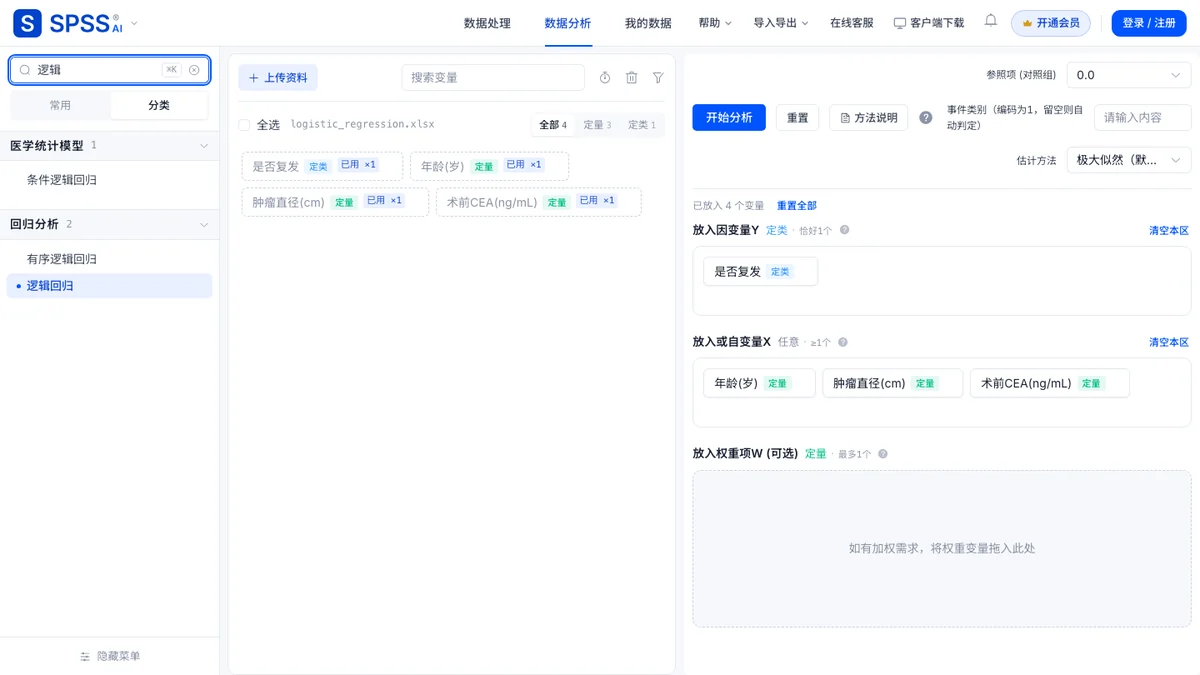
选定模型并出结果后:分析和查看结果不用登录;开通会员后可导出 Word / PDF 报告、使用 AI 解读。保存历史、我的数据与 LaTeX 源码导出需要登录。
逻辑回归和线性回归的区别:怎么选
| 因变量 | 用哪个 |
|---|---|
| 数值型(金额、评分) | 线性回归 (最小二乘法) |
| 恰好两类(是否发生) | 逻辑回归 |
| 有序等级(轻、中、重) | 有序逻辑回归 |
| 计数(每天的投诉件数) | 计数数据回归 |
两种模型的差别可以概括成下面几行:
| 项目 | 线性回归 | 逻辑回归 |
|---|---|---|
| 因变量 | 数值 | 二分类 |
| 模型估计什么 | 均值的变化 | 事件的对数几率 |
| 系数怎么读 | 每增加一个单位,均值变化多少 | 换算成优势比 OR |
| 预测值范围 | 不受限,可能超出 0 到 1 | 限制在 0 到 1 之间 |
| 拟合指标 | R²、调整 R² | 伪 R²、似然比检验、Hosmer-Lemeshow、AUC |
无序的多类结局,可以用「多分类Logistic回归」,也可以按研究问题合并成两类再用「逻辑回归」,或改用「CHAID决策树」「随机森林分类」。判断依据是因变量的类型,不是数据看起来像不像。
逻辑回归的结果怎么读
以下结果来自本站演示数据(模拟生成,不代表真实研究结论)。本例的 255 行是从 300 行演示表里随机抽出的,整表的数字稍有出入,读法不变。
系数是对数几率,报告换算成优势比 OR。因为事件是「未复发」,OR 描述的是未复发的优势:年龄每增加 1 岁,未复发的优势比低约 9%,肿瘤直径的 OR 也小于 1,术前 CEA 的 OR 大于 1,CEA 越高,未复发的优势越高。三个变量的 OR 与 95% 区间见下面的读数表。
OR 是优势比不是风险比,事件率高时会夸大相对风险。整体的似然比检验 χ²(3)=63.488,模型优于只含截距的零模型。
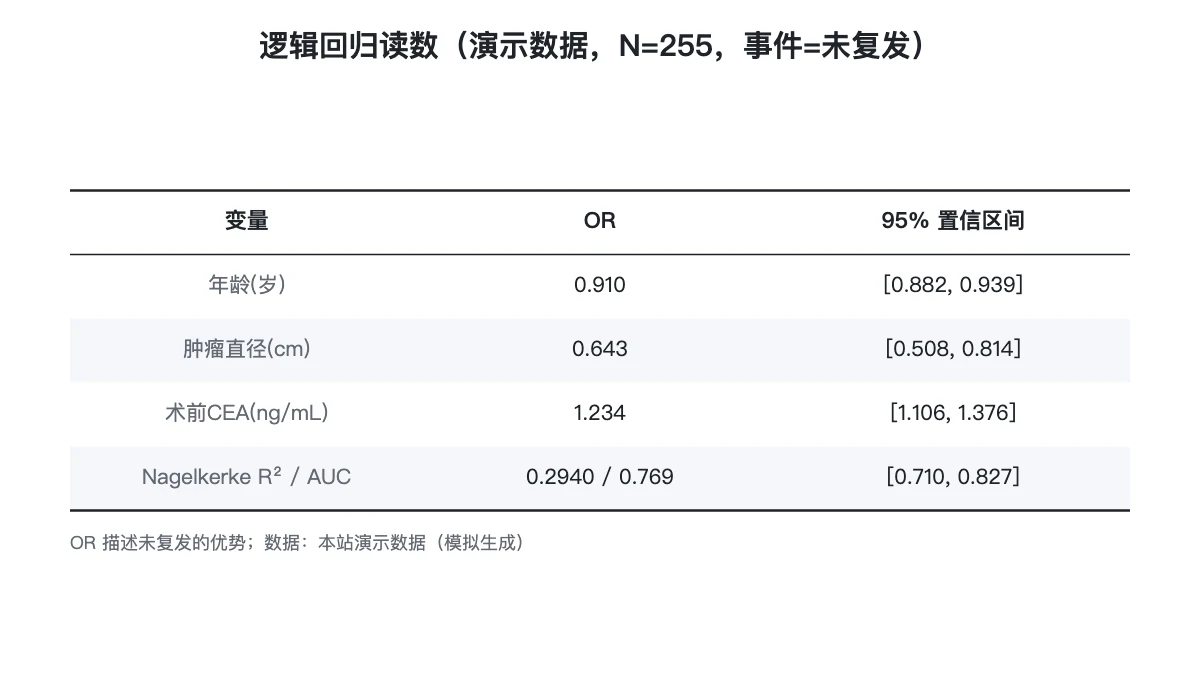
上表给出各自变量的 OR 与区间,下图把它们画成柱,柱端落在虚线 1 的两侧:
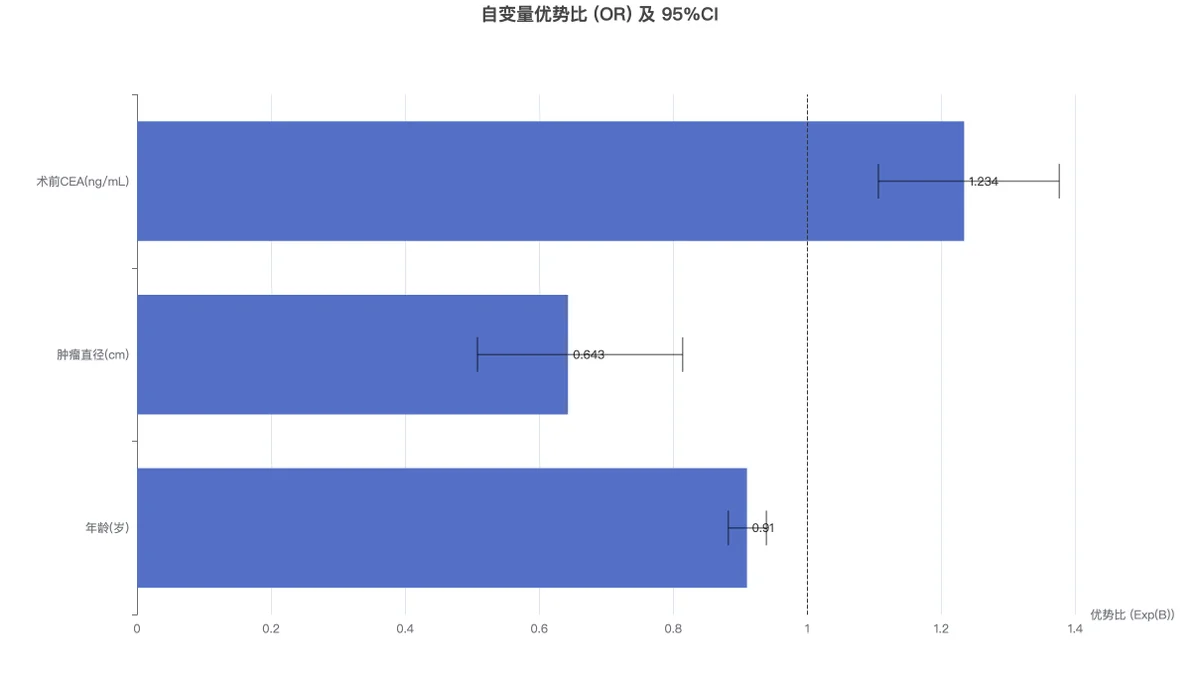
术前 CEA 的 OR 大于 1,肿瘤直径与年龄的 OR 小于 1,三条区间都不碰到虚线 1,方向与上表一致。读 OR 时先确认事件是哪一类。
拟合与区分能力:不能套用线性回归的 R²
逻辑回归的 McFadden R² 为 0.1798,Cox & Snell R² 为 0.2204,Nagelkerke R² 为 0.2940;报告写明 McFadden 在 0.2 到 0.4 已属很好,本例低于这个范围,但伪 R² 不能按线性 R² 的直觉判断。Hosmer-Lemeshow 检验 p=0.370,未见校准有系统偏差。
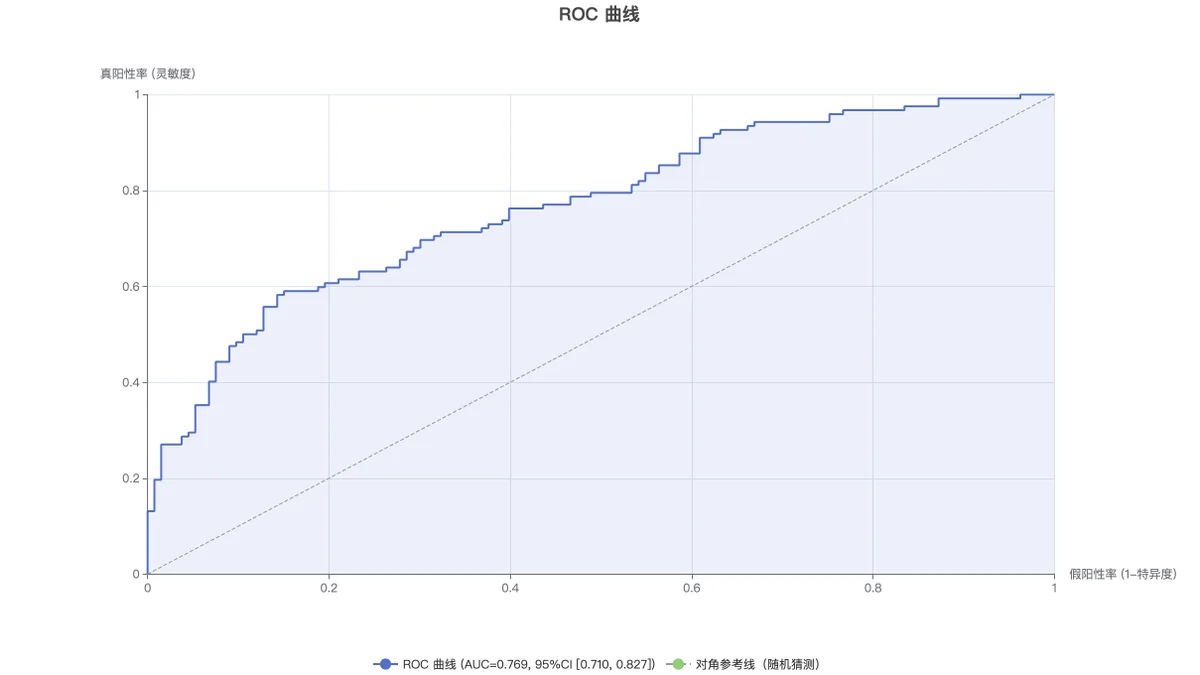
区分能力看 ROC 曲线:AUC 为 0.769,95% 置信区间 [0.710, 0.827],区间下限高于 0.5,区分能力一般(0.7 到 0.8)。意思是随机取一个事件样本与一个非事件样本,模型给事件样本更高预测概率的概率为 76.9%。这是训练集上回代的 ROC,必然偏乐观,样本外的表现本模块没有验证。
二分类结局为什么不宜用线性回归
线性回归估计均值,预测值可能超出 0 到 1,无法解释为概率;残差也不满足同方差与正态的假设,标准误与 p 值会失真。逻辑回归通过 logit 把预测限制在 0 到 1 之间,估计对数几率。样本量方面,经验准则是每个自变量至少 10 个少数类事件,本例 EPV 为 40.67,满足。
论文里怎么写
以复发与否为因变量,因其为二分类,采用二元 Logistic 回归(N=255,事件为未复发,122 例)。模型优于零模型,χ²(3)=63.488,p<0.001,Nagelkerke R²=0.2940,Hosmer-Lemeshow 检验 p=0.370,AUC=0.769(95%CI [0.710, 0.827],训练集回代)。年龄(OR=0.910,95%CI [0.882, 0.939])、肿瘤直径(OR=0.643)与术前 CEA(OR=1.234)与未复发均显著相关。
表注要写明因变量编码与参照组,例如 0 为复发、1 为未复发。这样 OR 的方向才有意义。
选错模型的常见错误
- 二分类结局用线性回归:预测值可能超出范围,标准误失真。
- 用线性回归的 R² 评价逻辑回归:指标含义不同。
- 把 OR 当风险比解释:事件率高时会夸大。
- 不写编码方向:OR 大于 1 或小于 1 取决于哪一类是事件。
- 只报 p:区间反映估计精度,要与 OR 一起写。
延伸阅读
常见问题
- 逻辑回归和线性回归的区别,一句话怎么说?
- 线性回归的因变量是数值型,直接估计均值的变化;逻辑回归的因变量是二分类,估计的是事件发生的对数几率,结果用 OR 解读。
- 二分类结局能不能直接用线性回归?
- 不宜。线性回归的预测值可能超出 0 到 1 的范围,残差也不满足同方差与正态的假设。二分类结局应当用逻辑回归。
- 逻辑回归的模型拟合怎么看?
- 要用逻辑回归自己的指标,不套线性回归的 R 方标准。本例 McFadden R 方 0.1798(0.2 到 0.4 已属很好),Nagelkerke R 方更高,再结合似然比检验、Hosmer-Lemeshow 与 AUC 判断。