

广义线性模型功效(Logistic/Poisson)
这个方法是做什么的
线性回归的功效分析看 R² 的增量,逻辑回归和 Poisson 回归却不能这样套用。本模块针对广义线性模型中某一个关注的自变量做功效分析:逻辑回归用 Hsieh、Bloch 与 Larsen(1998)的公式,Poisson 回归用 Signorini(1991)的公式。自变量可以是连续变量(按近似正态处理,效应以“每增加 1 个标准差”的 OR 或 IRR 表示),也可以是二分类变量(效应以两组比较的 OR 或 IRR 表示)。
与其他功效模块一样,效应量从上传的数据里估计:模块先拟合只含截距和该自变量的模型,得到效应和基线水平,再计算当前样本量下的检验功效,以及达到 80%、90% 功效所需的总样本量。若同时拖入其他协变量,模块计算该自变量对协变量回归的 R²,按 1/(1−R²) 放大所需样本量。卡③给出功效曲线,卡④给出效应缩放情景和显著性水平的敏感性。
需要准备什么数据
- 放入[定类]二分类结局(Logistic)(可选):0~1 个,定类变量(分组/标签)
- 放入[定量]计数结局(Poisson)(可选):0~1 个,定量变量(数值)
- 放入关注的自变量 X:1 个
- 放入其他协变量(可选)(可选):至少 0 个,定量变量(数值)
- 放入暴露量(可选,Poisson)(可选):0~1 个,定量变量(数值)
数据要求
- 数据表至少 20 行。
- 单列缺失率不超过 30%。
- 「放入[定类]二分类结局(Logistic)」必须正好是 2 个类别。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 设计病例对照、队列研究时,估算检出某个暴露因素所需的样本量
- 逻辑回归中关注一个连续风险因素(如剂量、血压)的效应
- Poisson 回归中比较事件发生率,例如每人年的急诊次数、不良事件次数
- 利用预试验或已有数据,评估继续扩大样本能否达到足够的检验功效
使用前要确认:连续自变量大致对称、近似正态;Poisson 模型没有明显的过度离散;观测效应只是一个情景,正式论证应以文献或预试验的效应为准。
什么时候不要用它
- 结局是连续变量:用「线性回归功效」,它按 R² 的增量计算。
- 只比较两组的率,没有其他自变量:用「两比例(率差)功效」,公式更直接。
- 已经有数据,想看效应是否显著:功效分析不回答这个问题,逻辑回归用「逻辑回归」,计数结局用「计数数据回归」。
容易误读的地方
- 事后功效不能用来解释“不显著”。 用同一份数据估计的效应去算功效,结果只是 p 值的另一种写法;结果不显著时说“功效不足”是循环论证。这个模块的正确用法是为下一项研究估算样本量。
- 观测效应倾向被高估。 小样本时显著的效应往往偏大,直接拿来算样本量会低估需要的人数。卡④给出效应缩小到 50% 和 75% 的情景,正式的样本量论证通常取这类保守值。
- Poisson 公式假定没有过度离散。 卡①给出离散度估计 φ̂;明显大于 1 时,所需样本量大约要再乘以 φ̂,报告会给出提示。
- 协变量越相关,样本量越大。 关注的自变量与其他协变量高度相关时,方差膨胀因子会很大;这说明在调整这些协变量后,该自变量能提供的独立信息有限,扩大样本量只是其中一种办法。
- 二分类自变量的比例很关键。 二分类自变量取 1 的比例越接近 0 或 1,所需样本量越大;设计时可以通过调整暴露组与对照组的比例来提高效率。
- 所需样本量是总人数,不是每组人数。 与两组比较的功效模块不同,这里的 N 指进入模型的全部观测;二分类自变量时,两组人数按数据中的比例分配。若计划改变暴露组与对照组的比例,所需总人数会随之变化,最好按新的比例重新估算。
- 只针对一个自变量。 模型中有多个关注的自变量时,需要对每一个分别计算,取所需样本量最大的那一个作为研究的样本量;同时检验多个自变量还要考虑多重比较,相当于收紧显著性水平,卡④的显著性水平敏感性表可以直接给出参考。
- 连续自变量明显偏态时公式会失准。 Hsieh 与 Signorini 的连续变量公式都建立在近似正态的假定上;剂量、收入这类右偏变量,可以先取对数再做功效分析,并在方法部分说明效应对应的是变换后的尺度。
- 把估算结果写进方案时要交代输入。 应写明效应量的来源、事件率或基线率、显著性水平、目标功效以及是否考虑了协变量和失访,读者才能复核样本量的合理性。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:功效与所需样本量
- 输出结果三:功效曲线
- 输出结果四:敏感性分析(效应情景与 α)
- 输出结果五:结论与样本量报告表述
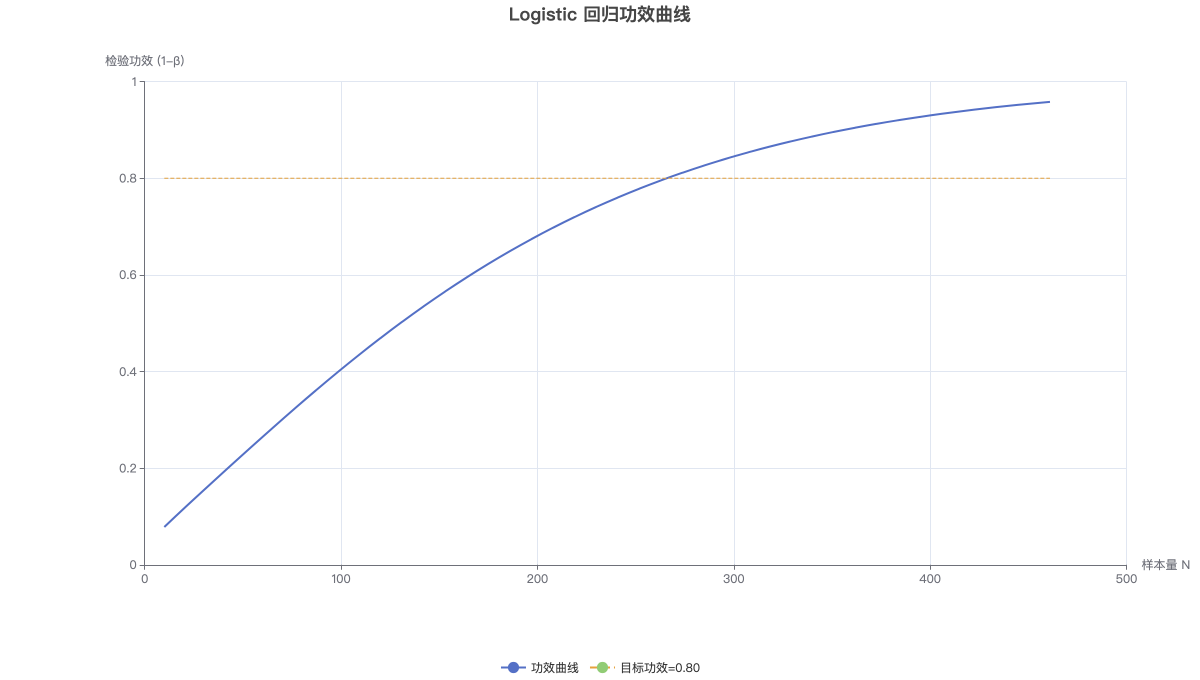
横轴为总样本量,纵轴为在观测效应下的检验功效,虚线为 0.80 目标功效。