SPSS 文本分析词频统计怎么做:中文分词与高频词表
文本分析词频统计应先核对分词与过滤,再区分词次占比和文本覆盖范围,最后回到原句解释高频词。SPSS 相关的文本统计任务可以在本站用一列评论练习;词云便于概览,具体比较仍以高频词表为依据。
文本分析词频统计的数据要怎么排
一行放一条评论,一列保存完整原文,保留句内的否定词和标点供核查。方法入口与边界可先看词频统计,这篇只讨论本站实际生成的榜单,不介绍其他软件的操作菜单。
以下结果来自本站演示数据(模拟生成,不代表真实研究结论),使用全部 120 条顾客评论。它是一份混合服务与商品体验的练习语料,适合练习读表,不能据此推断某个真实行业的消费者需求。
| 数据列 | 内容 | 检查要点 |
|---|---|---|
| 顾客评论 | 自然语言文本 | 每行是一条完整评论 |
| 空白记录 | 没有可分析文本 | 先核对跳过行数 |
| 编码或标签 | 编号、类别简称 | 与真正的评论分开整理 |
开始前建议抽读原文,确认这一列确实包含表达,而非答题选项的标签。相同模板的评论也会重复贡献词次,因此词频的代表性还取决于采集范围和文本去重方式。
中文分词与高频词数怎么设置
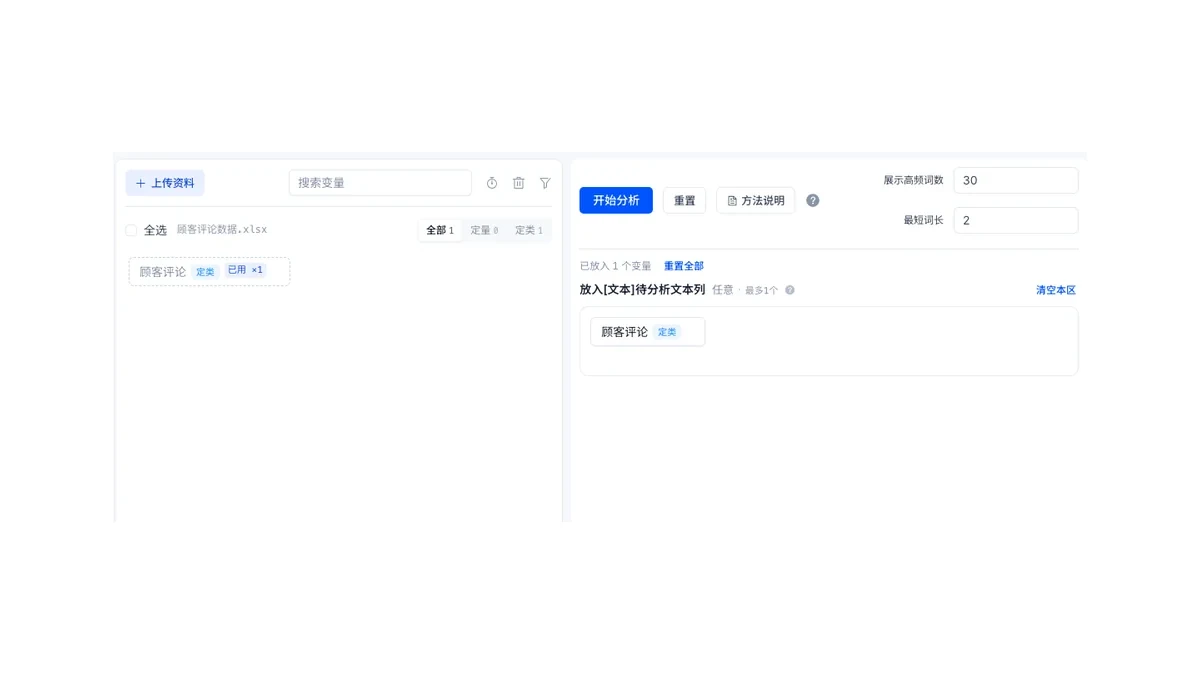
- 在数据分析中找到「词频统计」,上传 .xlsx 或 .csv 文本表。
- 将顾客评论放入文本分析位置,检查展示高频词数和最短词长;本例保留默认设置。
- 开始分析后先读语料预处理明细,再读高频词统计表,核对过滤后保留的内容是否仍符合研究目的。
报告使用 jieba 精确模式,本例过滤掉纯符号、纯数字、短词和内置停用词后,保留 1875 个有效词次、96 个不同词。词次是全部出现次数,类符是去重后的词汇种类,两者对应不同的统计问题。
预处理明细还显示短词过滤产生的剔除量。短评若大量依赖单字评价,可以另行规划参数对照;这篇没有运行另一套参数,因此下文的数值和图片均只对应当前设置。演示数据不用登录就能跑;用自己的数据分析、导出 Word / PDF 报告、使用 AI 解读需要开通会员。
高频词统计表与条形图怎么看
高频词表中,「效果」出现 53 次,但出现在 48 条文本中。两个计数的差别说明部分文本重复使用了这个词,写报告时应明确自己在描述用词次数,还是提到该词的评论覆盖面。
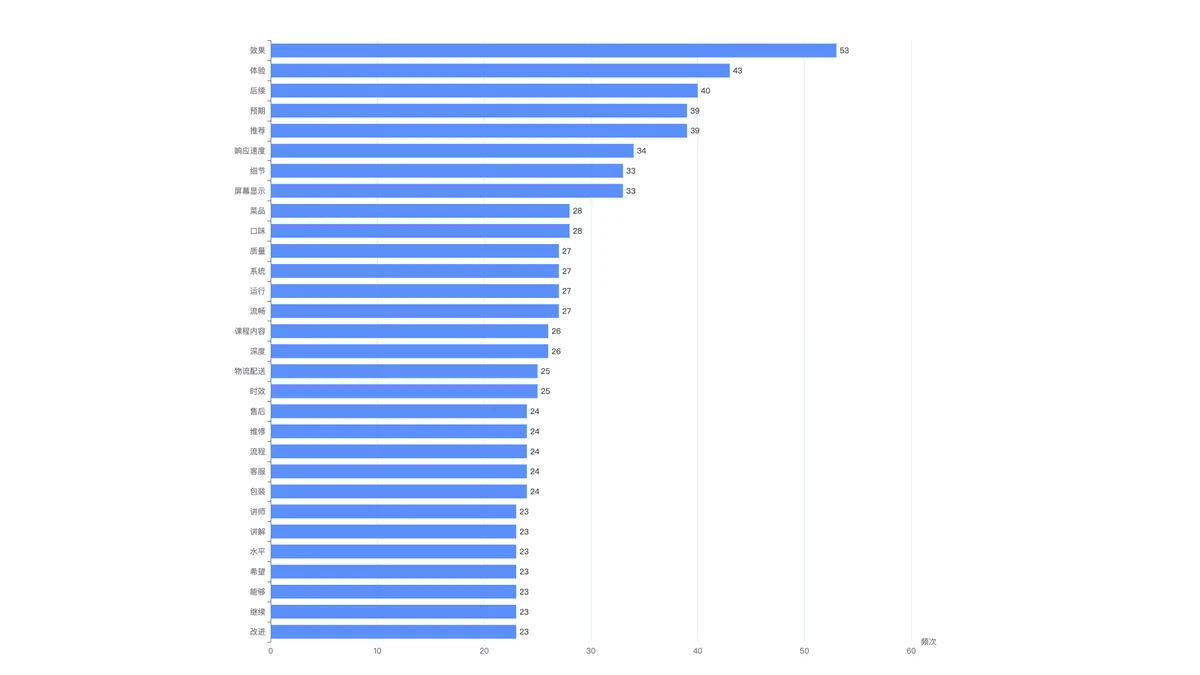
条形图适合比较相邻词语的频次,横向排序能帮助定位需要回读的原文。榜单前列同时出现体验、后续与预期一类词,说明还需要阅读完整句子,才能判断它们是在肯定当前体验,还是表达尚未满足的期待。
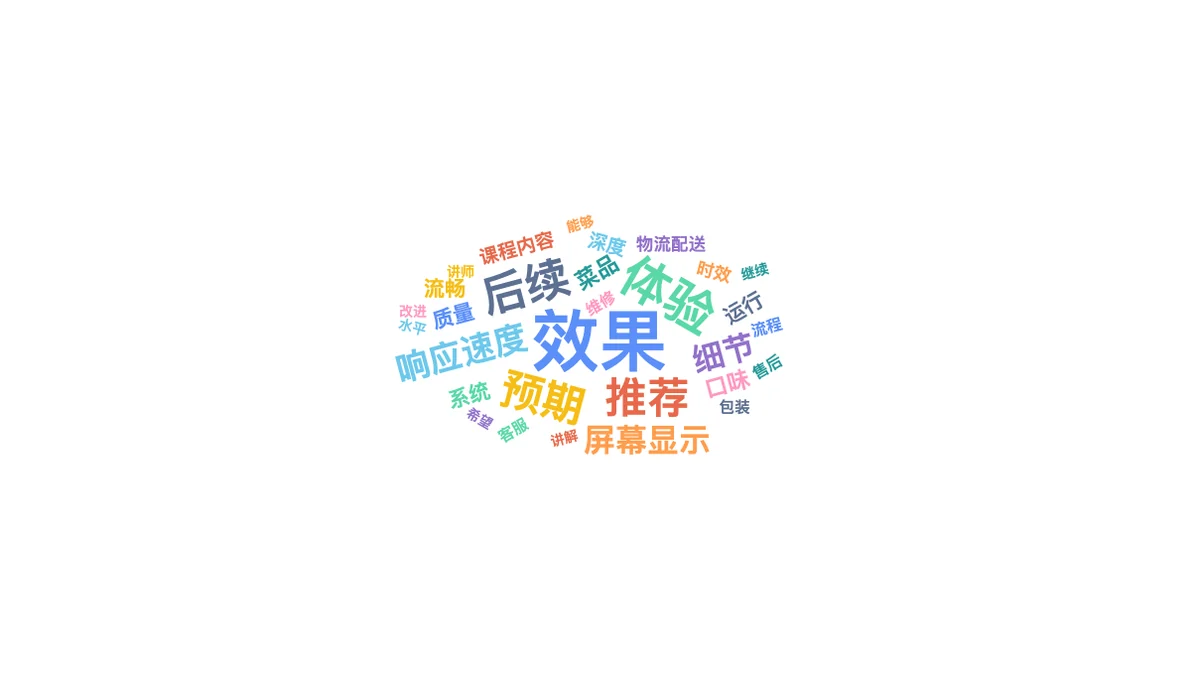
词云则把词汇规模压缩到同一画面中,适合在汇报时提示阅读方向。词语之间的空间距离没有语义相似度含义,也没有把一条评论中的因果关系编码进去,观看时宜把字号理解为频次的视觉映射。
从高频词到人工编码的核查路径
高频词可以成为人工编码的候选入口,编码类别仍需另行定义。下图用核查顺序连接词表和原文,目的在于留下可复核的解释过程,并未把词语自动归并成主题。
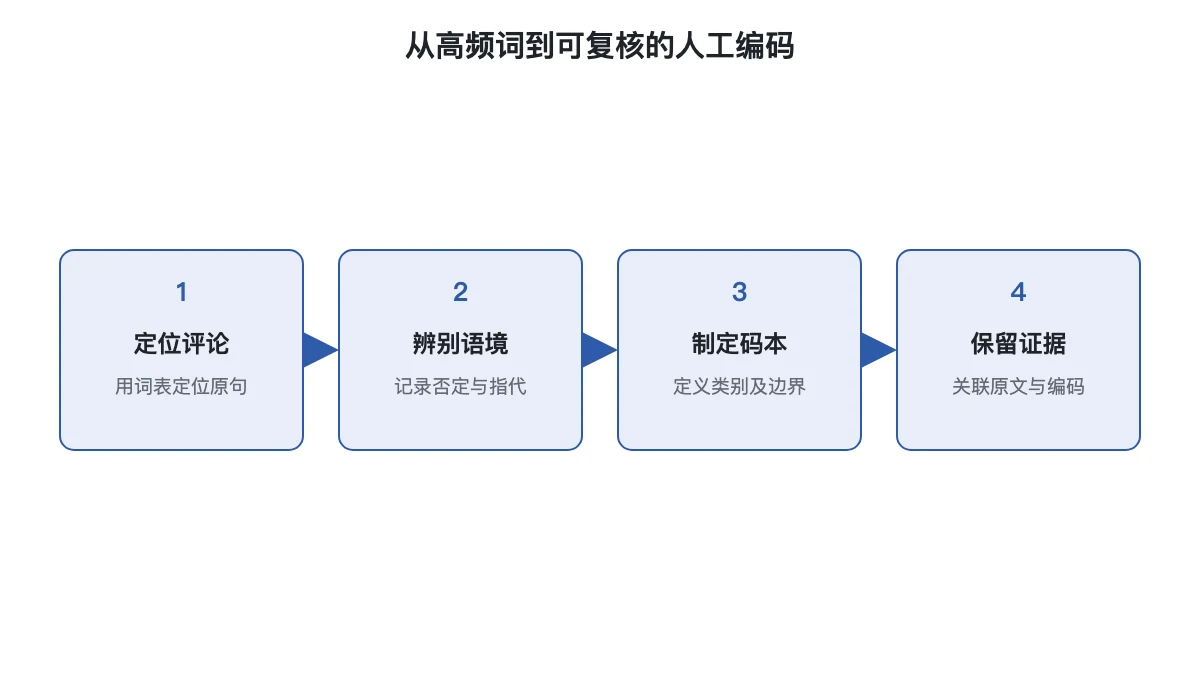
遇到产品名被切成多个片段时,先记录原词与分词后的对应关系,再判断排名是否受切词影响。把碎片词直接解释为新的消费者关注点,会使结论依赖分词器而非文本表达,这种情况适合先修订文本整理方案。
文本统计在论文里怎么写
方法段写清语料来源、文本单位、分词工具和过滤规则,结果段再说明有效词汇规模及关注词。可以写成:对顾客评论演示语料进行中文分词和过滤,获得 1875 个有效词次与 96 个不同词;其中「效果」出现 53 次,涉及 48 条评论,随后回到原句核查其使用语境。
这段文字限定了描述对象,也给后续编码留出了位置。若要讨论满意度、推荐意愿或主题结构,应另外设置相应分析,单靠词频排序尚不足以给出这些结论。
词频统计常见错误
- 把词次占比写成用户比例:核对分母,涉及多少评论应读文档频率。
- 把词云中的位置当成主题关系:位置用于排版,主题划分需要明确编码规则。
- 把带有否定语境的词全部判作正面意见:回读原句并保留核查记录。
- 将不同长度语料的词汇种类直接比较:先检查文本量与预处理口径,再解释词汇丰富度。
延伸阅读
常见问题
文本分析词频统计需要检验显著性吗?
这里是对语料中词语出现情况的描述,没有预设原假设。频次和覆盖度用于归纳文本,显著性判断需要另有研究设计与检验。
中文分词能直接判断评论好坏吗?
分词只把文本切成词语,词频没有情感方向。解释词语前应回到原句核对否定、反讽和使用语境,再决定是否人工编码。
频次与文档频率有什么区别?
频次累计一个词出现的所有次数,文档频率统计有多少条文本出现过它。反复使用同一词的长评论可能把频次推高,却未覆盖更多用户。