SPSS 问卷调查数据分析报告怎么写:章节与表格清单
更新于
本次调查(本站演示数据,模拟生成)共回收有效问卷 128 份,各变量均无缺失。学历层次分布均衡,满意度等级以满意为主,占 47.66%。这是问卷调查数据分析报告开头常见的一句写法,整份报告的章节、表格清单,以及样本构成表怎么排,下面逐项说明。
问卷调查数据分析报告的章节顺序
问卷数据分析报告的章节按“先交代样本,再逐章展开”的思路排,样本构成放在最前面。每一章回答一个具体问题并给出对应的表格,各章用哪张表见后面的清单。方法说明见频数分析。
以下结果来自本站演示数据(模拟生成,不代表真实研究结论;是演示数据 85% 的随机子样本)。演示表共 150 行,这里随机取了 128 行,载入整张表数字会略不同,读法一致。样本构成表里,学历按学历高低列,满意度等级按从低到高列,所在区域没有顺序,按报告里的顺序列:
| 变量 | 选项 | 频数 | 百分比 | 95% 置信区间 |
|---|---|---|---|---|
| 学历层次 | 大专 | 32 | 25.00% | [18.30%, 33.16%] |
| 学历层次 | 本科 | 31 | 24.22% | [17.62%, 32.32%] |
| 学历层次 | 硕士 | 33 | 25.78% | [18.99%, 33.99%] |
| 学历层次 | 博士 | 32 | 25.00% | [18.30%, 33.16%] |
| 所在区域 | 华东 | 34 | 26.56% | [19.68%, 34.82%] |
| 所在区域 | 华北 | 32 | 25.00% | [18.30%, 33.16%] |
| 所在区域 | 华南 | 29 | 22.66% | [16.26%, 30.64%] |
| 所在区域 | 西部 | 33 | 25.78% | [18.99%, 33.99%] |
| 满意度等级 | 非常不满意 | 1 | 0.78% | [0.14%, 4.29%] |
| 满意度等级 | 不满意 | 4 | 3.12% | [1.22%, 7.76%] |
| 满意度等级 | 一般 | 28 | 21.88% | [15.59%, 29.80%] |
| 满意度等级 | 满意 | 61 | 47.66% | [39.20%, 56.25%] |
| 满意度等级 | 非常满意 | 34 | 26.56% | [19.68%, 34.82%] |
总样本量 128,缺失按列剔除,百分比分母是各变量自己的有效 N,区间为 Wilson 95% 置信区间。
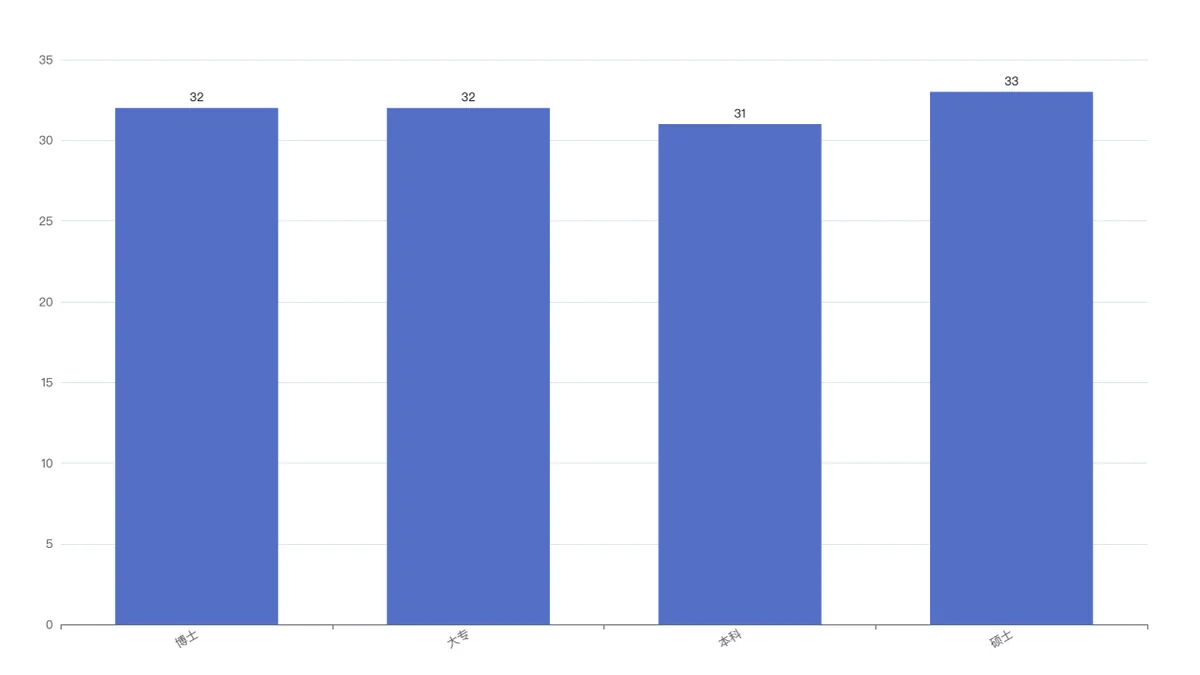
图中学历的排列顺序与上表不同,只是报告里的字符顺序;四个学历层次的人数相差很小,分布接近均匀,与归一化熵接近 1 相符。各层人数差不多,样本构成一章可以直接用这张图。
每个数字从哪来,累计百分比的陷阱
频数、百分比和区间出自频数分析的第二张卡,类别数、众数与缺失出自第一张卡,集中度出自第四张卡。
累计百分比按报告里选项排列的先后累加,而这个先后取决于标签的字符顺序,不取决于等级高低。本例满意度等级在报告里排成一般、不满意、满意、非常不满意、非常满意,累计到满意是 72.66%,漏掉了排在后面的非常不满意;按等级由低到高,满意及以下应是 73.44%。两种排法的累计值对照如下:
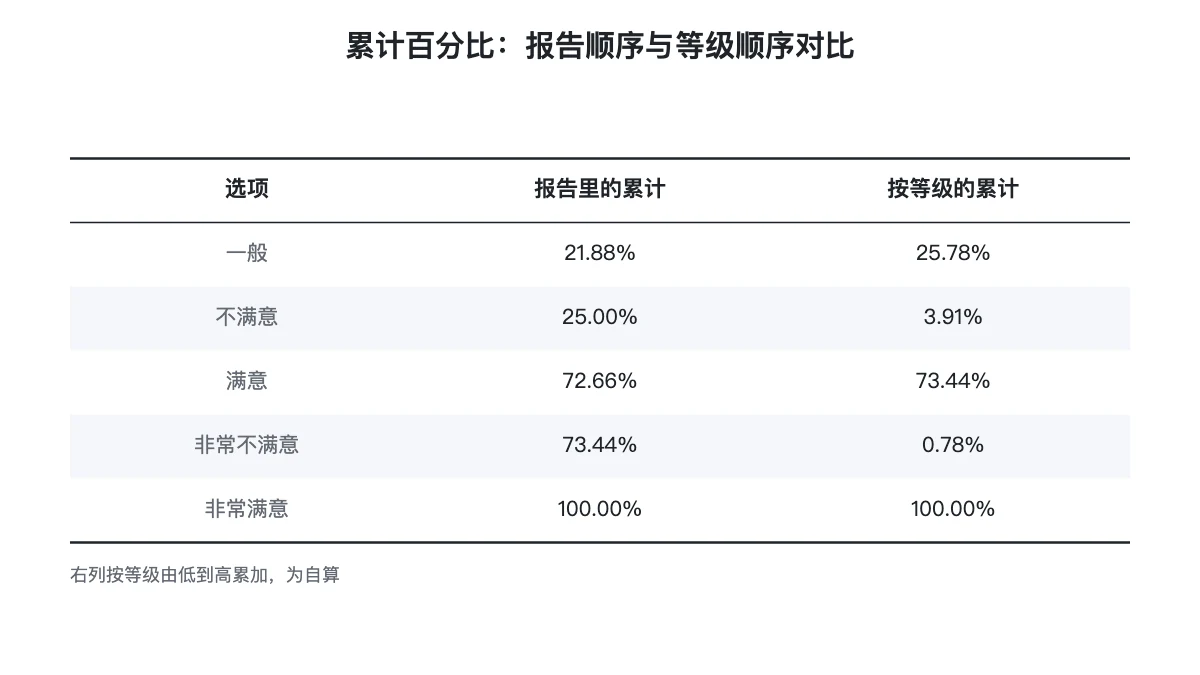
无序变量(学历、区域)可以忽略这一列。定序变量要在「数据标签」里把选项改成能按字符顺序排的写法,例如“1-非常不满意”到“5-非常满意”,重跑后再读累计。
集中度用归一化熵:学历层次 0.9998,分布接近均匀;满意度等级 0.7357,判定为轻度集中。这是经验分档,不是统计检验,也不等于多数人选了满意:过半的人并没有选它。
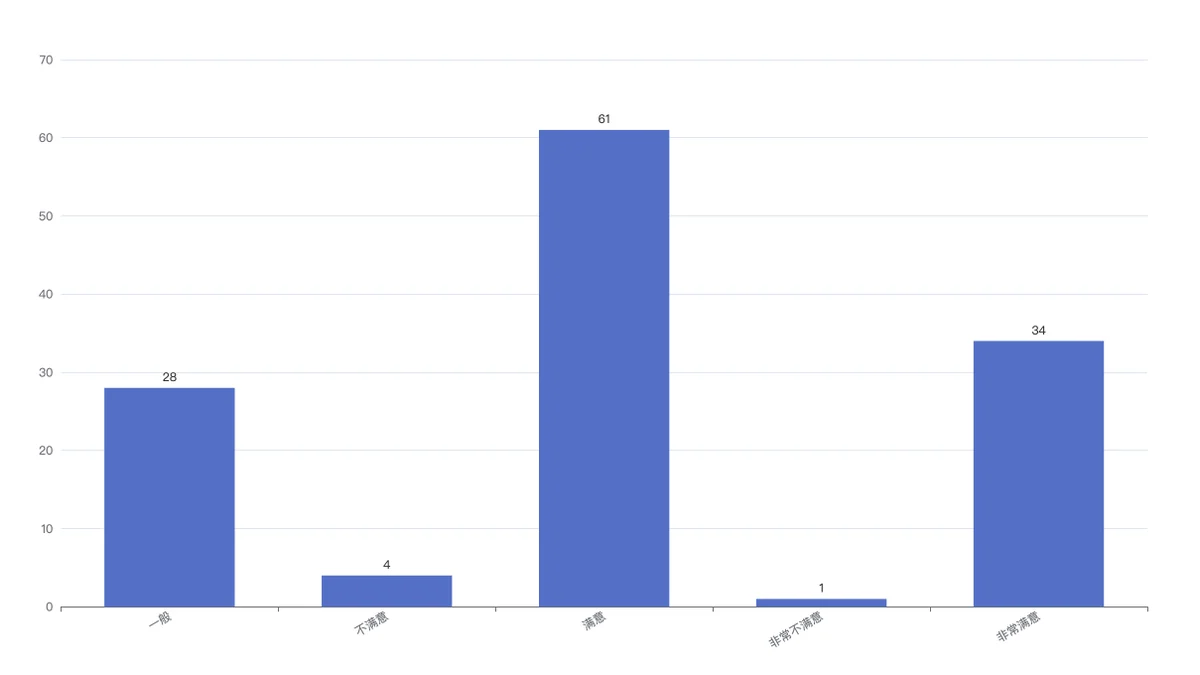
满意的人数最多,非常不满意与不满意合计很少。图里横轴是报告里选项出现的顺序,并非等级由低到高的顺序。
表格清单:每章放哪几张表
调查问卷分析报告里每章放什么表、数字来自本站哪个方法,列在下面:
- 样本构成:样本构成表(频数、百分比、95% 区间),数字来自「频数分析」。
- 各题项的描述统计:每个题项的均值、标准差或频数表,数字来自「描述性统计」或「频数分析」。
- 信度与效度:α 系数表、因子载荷表,数字来自「信度分析」「因子分析(探索性)」。
- 差异比较:组间比较表与效应量,数字来自「独立样本T检验」「单因素方差分析」。
- 相关与回归:相关矩阵与回归系数表,数字来自「Pearson相关性分析」「线性回归 (最小二乘法)」。
- 结论与局限:不放新表,回扣前几章的关键数字,并写明样本来源、回收率与选择偏差。
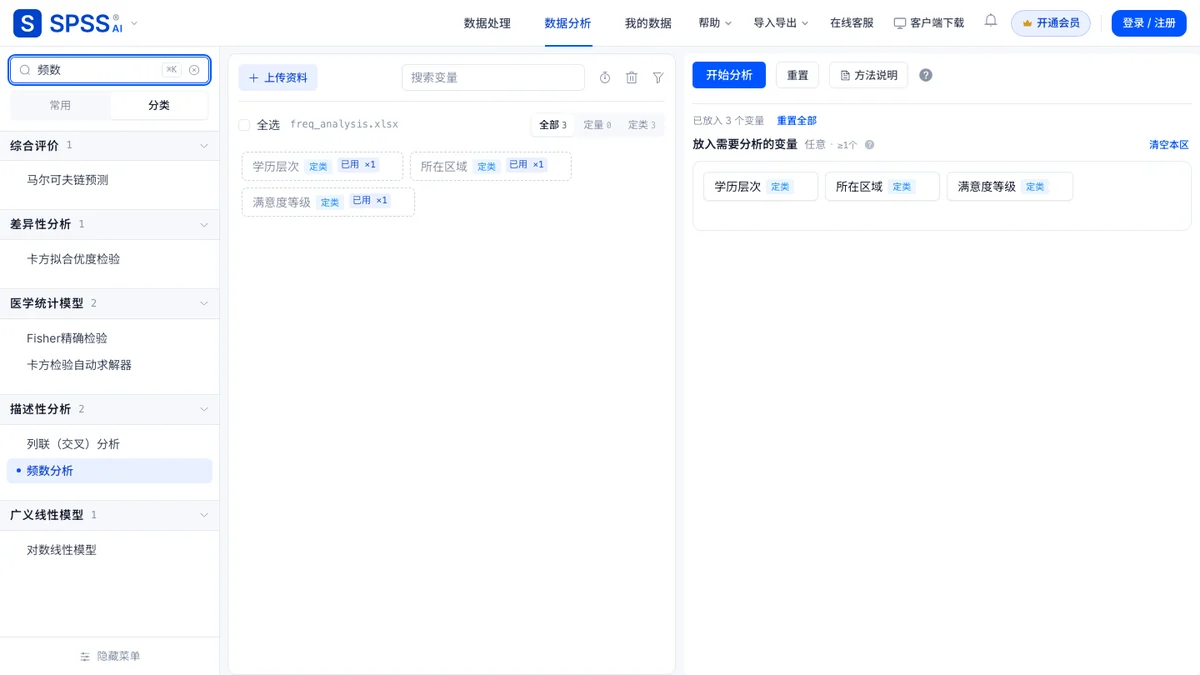
下图是工作台里的频数分析页面,报告里的频数表就来自这里:
样本构成一章要说明样本怎么抽取、回收率与有效率,否则百分比再精确,读者也不知道能推广到谁。结论与局限一章要写样本来源、回收率与选择偏差,各章之间样本量要前后一致,不一致就在表注里解释。
写报告时常见的错误
- 只写百分比,不写 N:读者无法判断比例的稳定性。
- 不说明缺失处理:缺失按列剔除,各变量有效 N 可能不同。
- 强调占比极低的选项:非常不满意只有 1 人(0.78%),区间 [0.14%, 4.29%],不宜据此下判断。
- 把描述写成推断:频数分析只描述样本,要推断总体,要结合区间并说明抽样方式;也不要写成「A 类显著多于 B 类」。
正文段落示例
本次调查共回收有效问卷 128 份,各变量均无缺失。满意度等级中,满意占 47.66%(95%CI [39.20%, 56.25%]),非常满意占 26.56%,一般占 21.88%,不满意与非常不满意合计 5 人,占 3.91%。满意度分布轻度集中(归一化熵 0.7357)。
报告生成后:分析和查看结果不用登录;开通会员后可导出 Word / PDF 报告、使用 AI 解读。保存历史、我的数据与 LaTeX 源码导出需要登录。
延伸阅读
常见问题
- 问卷调查数据分析报告应该包含哪些章节?
- 可以包括样本构成、各题项的描述统计、信度与效度、差异比较、相关与回归,以及结论与局限。样本构成放在最前面,说明分析的基础。
- 样本构成表要写频数和百分比吗?
- 要写,并建议同时给出占比的 95% 置信区间。定序变量的累计百分比按表里的顺序累加,要先核对选项顺序。
- 某个选项的占比极低,报告里怎么处理?
- 占比极低的选项,比例的置信区间会很宽,不宜强调。本例满意度等级中非常不满意只有 1 人,占 0.78%,应如实列出并说明解读要谨慎。