SPSS 临床基线资料表怎么做:Table 1 的统计方法与写法
更新于
基线资料表应同时交代分组、描述方式与检验;以下结果来自模拟生成的演示数据,不代表真实研究结论,例如吸烟行两组分别为 44(29.7%)与 67(45.0%)。Table 1 负责描述起点特征,组间检验和标准化差异提供补充信息,后续校正分析承担不同任务。
基线资料表的标准格式
以下结果来自本站演示数据,临床资料模拟生成,不代表真实研究结论。每行是一名研究对象,分组列确定比较对象,其他列记录人口学和临床特征;整理 SPSS 主题论文前,应把分类编码、定量单位与缺失符号统一,避免同一个数值在不同变量里代表不同含义。
| 变量及描述方式 | 对照组 | 试验组 | P |
|---|---|---|---|
| 年龄,均数±标准差 | 58.59 ± 10.01 | 57.99 ± 9.70 | 0.600 |
| 体质指数,中位数及四分位数 | 23.60(22.10, 24.88) | 23.90(22.15, 25.35) | 0.218 |
| 吸烟,是,例数(%) | 44(29.7) | 67(45.0) | 0.007 |
演示表还含住院天数,但是否属于基线取决于测量时点:若为干预后累计时长,应另作结局呈现;当前数据未记录时点,本文不将这一列自动认定为干预前特征。
Table 1 的结构应让读者先看分布,再看差异。把所有变量的 p 值放在显眼位置、却省略单位和有效人数,会让一张描述表失去最基本的解释条件;多分类变量的总体检验也只对应整个构成,表格布局应避免把它误配给某个单独水平。
每一行的描述与检验从哪来
本模块在前提卡中列出连续变量的分组分布检查、分类变量的期望频数与实际采用的检验。制表时可按行追溯:均数与标准差对应一种分布摘要,中位数与四分位数对应另一种摘要,分类比例则需要和有效分母一起核对。
缺失按变量处理,所以不同特征的有效人数可以不同。把各行都写成同一个分组总人数,会让分类比例和读者手算结果不一致;若研究另有统一分析样本规则,应在制表前落实并说明,而非在表格中隐去差异。描述口径若为满足期刊要求统一设置,也应将该设置记入方法段。
本次使用全部 300 行,对照组与试验组各 150 例。体质指数缺失 7 例,吸烟缺失 3 例,各行按自身有效记录计算;既往心肌梗死行因期望频数稀疏采用 Fisher 精确检验,统计量显示为空标记,P=1.000。空统计量来自检验口径,并非漏做分析;这与模型无法估计的状态不同,制表时应保留检验说明。
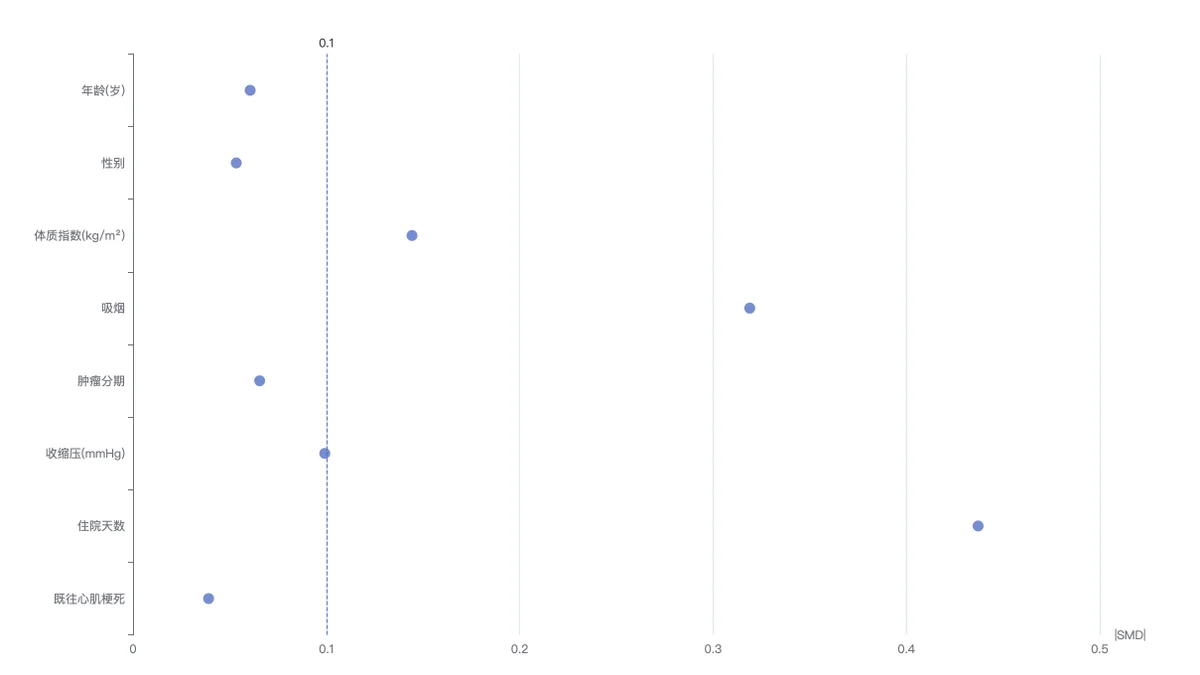
Love 图帮助定位需要进一步理解的特征,横轴量纲与 p 值不同。它展示的差异大小来自当前分组资料,应与变量的临床意义和研究设计共同阅读,后续模型中的校正决策也应有专业依据。
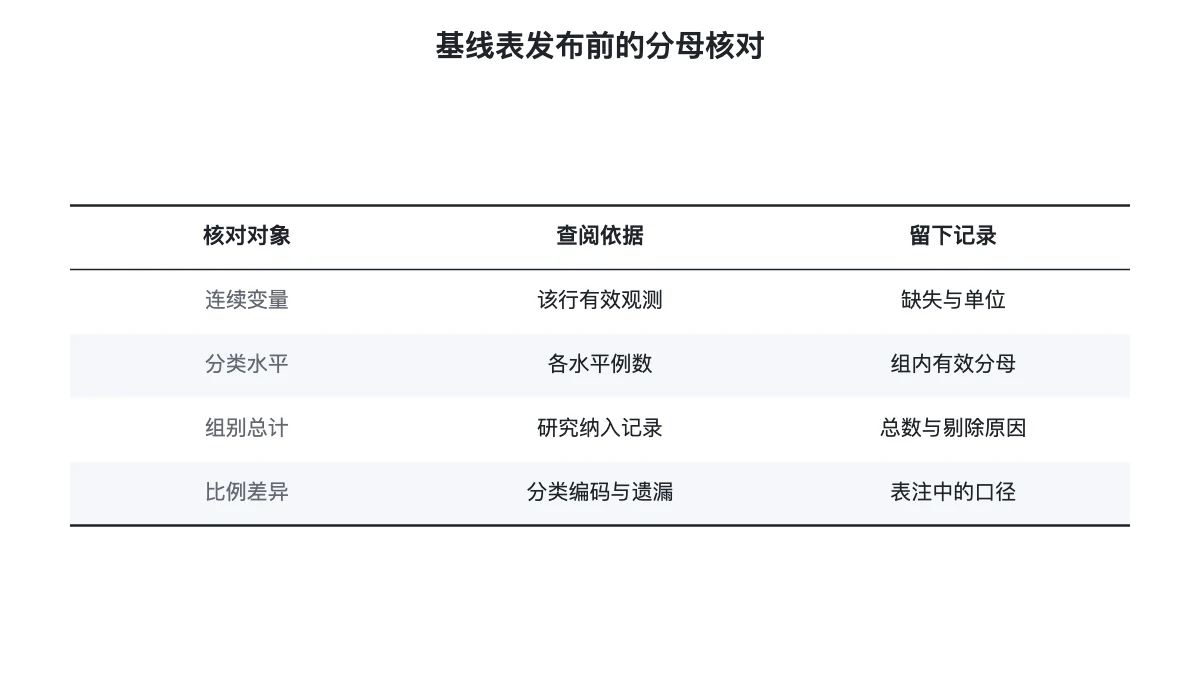
这份核对记录用于让表格发布前的数值关系可追溯,补足主表没有展开的资料状态。当前示例体质指数的 SMD=0.144,提示两组描述分布有差异,应结合临床背景解释。若变量存在遗漏,可据此查明组内比例与有效人数的对应关系,并决定表注应保留哪些说明。
基线表中容易误写的地方
- 用未显著的检验写成分组完全相同:描述实际差异与精度,结合研究设计讨论。
- 把分类变量各水平当成独立的多次检验:说明总体检验对应整个变量,保留清楚的表格层级。
- 将基线差异直接解释成治疗结果:先区分起点特征与随访结局,再决定后续分析。
临床基线的正文段落示例
可写为:按研究分组描述基线人口学与临床特征,连续变量根据预设口径报告位置与离散程度,分类变量报告有效例数及组内比例。表中同时注明各变量实际采用的检验,缺失情况另作说明;对于需要在后续模型中校正的因素,结合研究方案与专业知识确定。
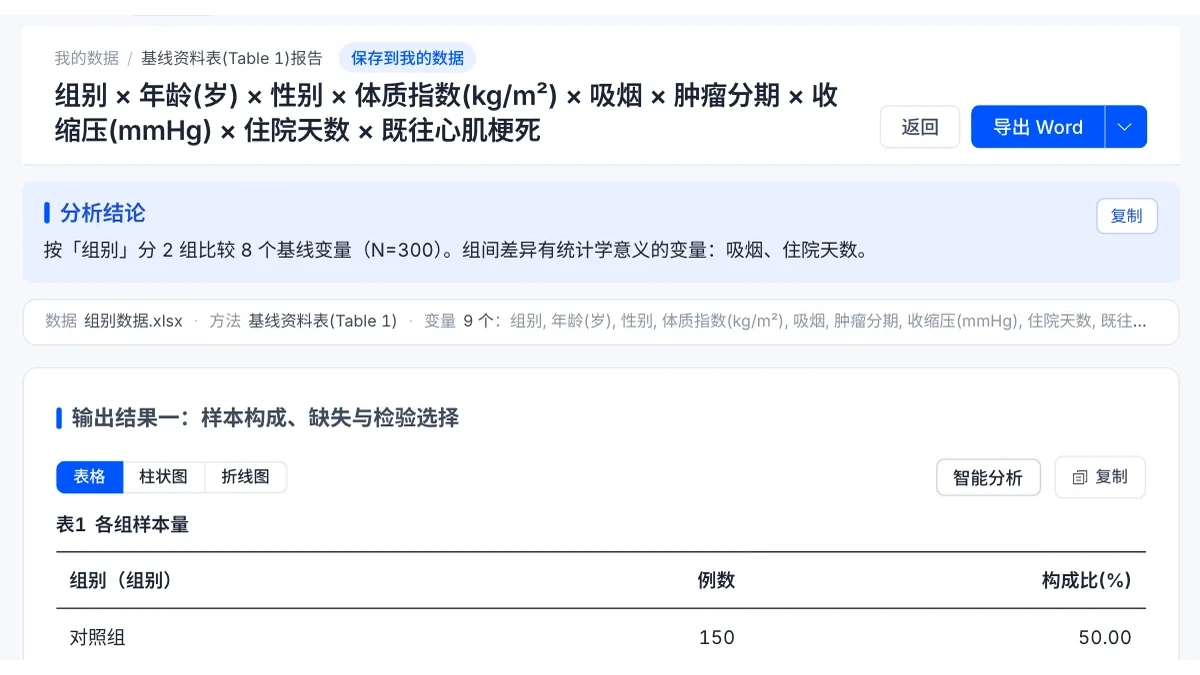
报告首屏显示本次变量清单、分析摘要和样本表节选,便于核对分析对象。整理 SPSS 临床资料时,仍要回到完整样本表与逐变量前提卡,确认各行分母和检验口径。
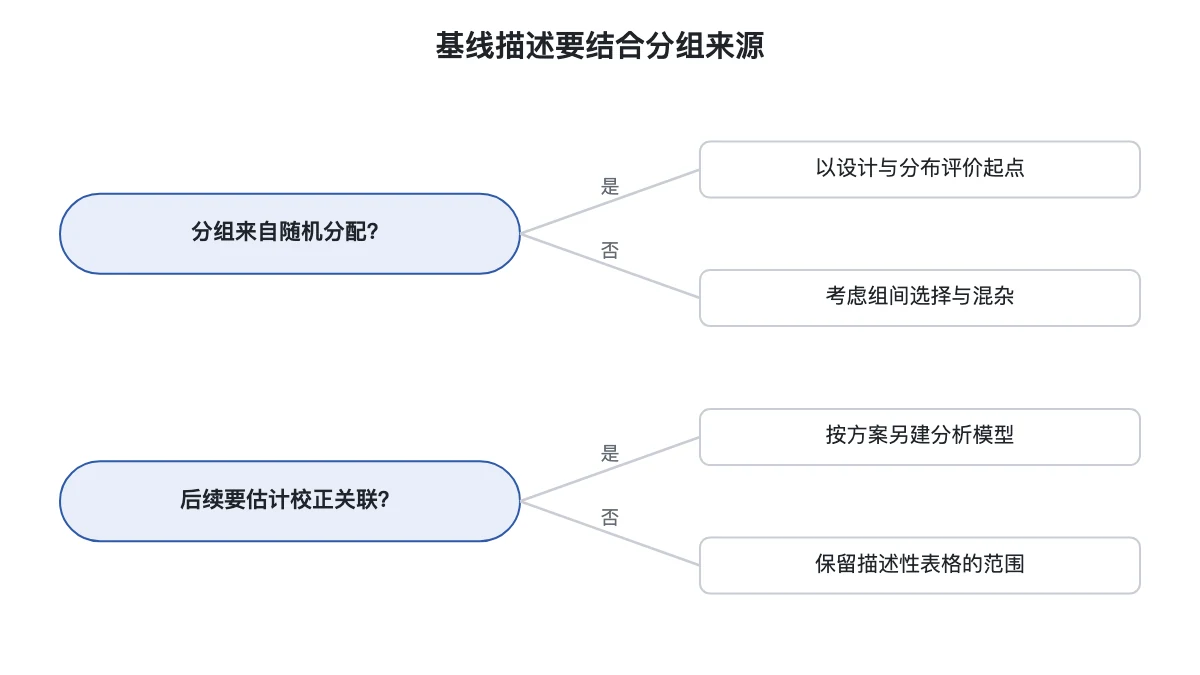
判断图补充的是研究设计层面的解释任务,避免一张表承担超出描述范围的结论。无论采用哪种设计,保留清楚的分布与资料处理规则,都是读者评价研究对象的基础。
分析和查看结果不用登录;开通会员后可导出 Word / PDF 报告、使用 AI 解读。先用演示资料核对主表、分母与表注,再整理实际研究的基线资料。
延伸阅读
常见问题
- 基线资料表的百分比用哪个分母?
- 按该组该变量的有效记录计算,因此存在缺失时可能小于组内总人数。表注应交代缺失情况,读者才能正确理解每行的例数与比例。
- table 1 中不显著能写两组相同吗?
- 未检出差异只描述当前检验的证据强度。还需看实际分布和差异大小;对于随机研究,基线检验也并非评价随机分配质量的依据。
- 临床基线里的分类编码会按均数报告吗?
- 先确认变量的测量类型。分类编码表示水平时应按类别整理;若数值取值很少却本来是定量评分,应在分析前核对类型和研究口径。