SPSS 逐步回归分析三线表怎么写:每一步的 R² 变化
逐步回归分析三线表应把筛选路径与最终模型分开:路径表列每步变量集合和 R²,系数表再报告最终估计、区间及选择后的推断限制。SPSS 是统计软件名称,本文依据独立平台 SPSSAI 的真实演示输出,给出模型间可核对的写作格式,不把筛选过程写成已验证的预测能力。
逐步回归分析三线表的路径格式
以下结果来自本站演示数据(模拟生成,不代表真实研究结论),从 120 行随机抽取 102 行,随机种子为 3。因变量为月度销售额,模型从原文件中的全部候选自变量作双向逐步筛选,进入标准为 p<0.05,剔除标准为 p>0.1;各步使用相同完整记录。 复现时从原演示表表头后的首条数据行起计,移除第 16、24、29、36、40、46、52、53、60、72、80、84、85、87、91、94、99、117 行,保留其余行的原顺序并另存上传;工作台不会自动按本文种子抽样。
本表用 A、B、C 标记原演示文件中因变量以外按列序排列的候选指标,只为压缩表格长度,原始列与模型没有改名。A 对应广告投入,B 对应门店面积,C 是文件中剩余的连续候选指标;写入正式论文时应按数据字典交代各项含义及单位。
| 模型 | 纳入的候选集合 | R² | 调整后 R² |
|---|---|---|---|
| 模型1 | A | 0.4692 | 0.4639 |
| 模型2 | A、B | 0.5848 | 0.5764 |
| 模型3 | A、B、C | 0.6323 | 0.6210 |
表中每行对应一个重新拟合的变量集合,R²是样本内对因变量变异的解释比例,调整后 R² 则还包含对变量个数的惩罚。本例随着候选项进入,两项指标均上升,说明这些步骤改善了当前样本的拟合描述;其结果尚未评价新样本上的预测误差。
每个数字从哪张报告表抄出
路径表的数值出自「变量筛选过程中各步模型的拟合对比」,变量集合、动作和模型序号可与其后一张筛选明细表对照。最终模型的 R² 与调整后 R² 还可在拟合优度表中复核,两处应使用相同变量集合和同批观测,出现差异时先查转录与模型版本。
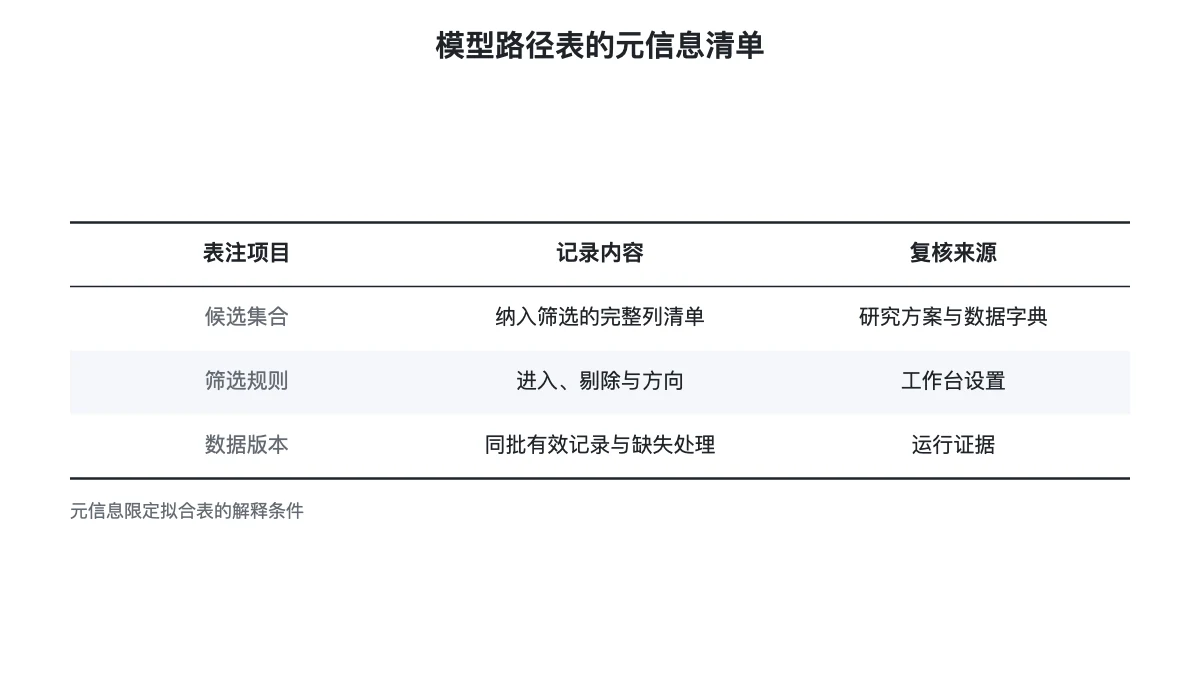
示意表补充的是论文表注的元信息:固定候选集合、筛选规则与缺失处理,并与样本内拟合指标分开记录。它帮助后来者理解模型形成过程,也避免仅在表头写一个含糊的「逐步法」而没有可复核的设置。
逐步回归结果的系数与诊断如何配套
| 最终参数(保持输入列顺序) | B | 标准误 | 95%CI | 原始p |
|---|---|---|---|---|
| 截距 | 7.813 | 3.898 | [0.078, 15.548] | 0.048 |
| 广告投入,每原始单位 | 3.490 | 0.496 | [2.506, 4.475] | <0.001 |
| 门店面积,每平米 | 0.062 | 0.017 | [0.028, 0.096] | <0.001 |
| 第三个候选指标,每百分点 | 0.620 | 0.174 | [0.274, 0.966] | <0.001 |
表中第三项按原演示表候选列顺序标识,没有改写实际输入列名。上述常规区间与原始检验条件于本次筛选后的模型,没有纳入变量选择的不确定性,正式稿应保留探索性选择的说明。
最终模型的广告投入系数 B=3.490,标准误 0.496,95%CI [2.506, 4.475];门店面积 B=0.062,标准误 0.017,95%CI [0.028, 0.096]。这些系数是在当前样本先筛选变量后估计的,报告中的常规区间未把选择过程的额外不确定性计算在内,应按探索性拟合结果解释。
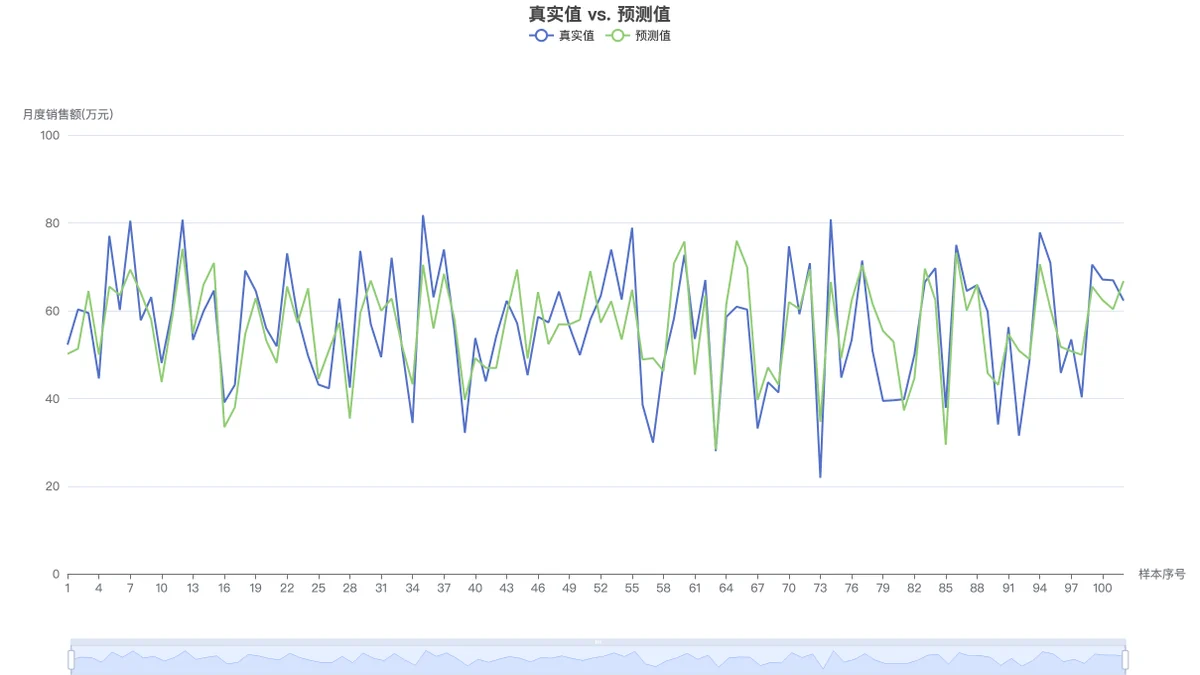
拟合折线图按样本顺序对照当前样本的预测值与实际值,可定位持续或孤立的偏离。它没有使用独立验证样本,因此两条线接近也未建立外推预测有效性;需要预测用途时,应另按研究方案完成验证。
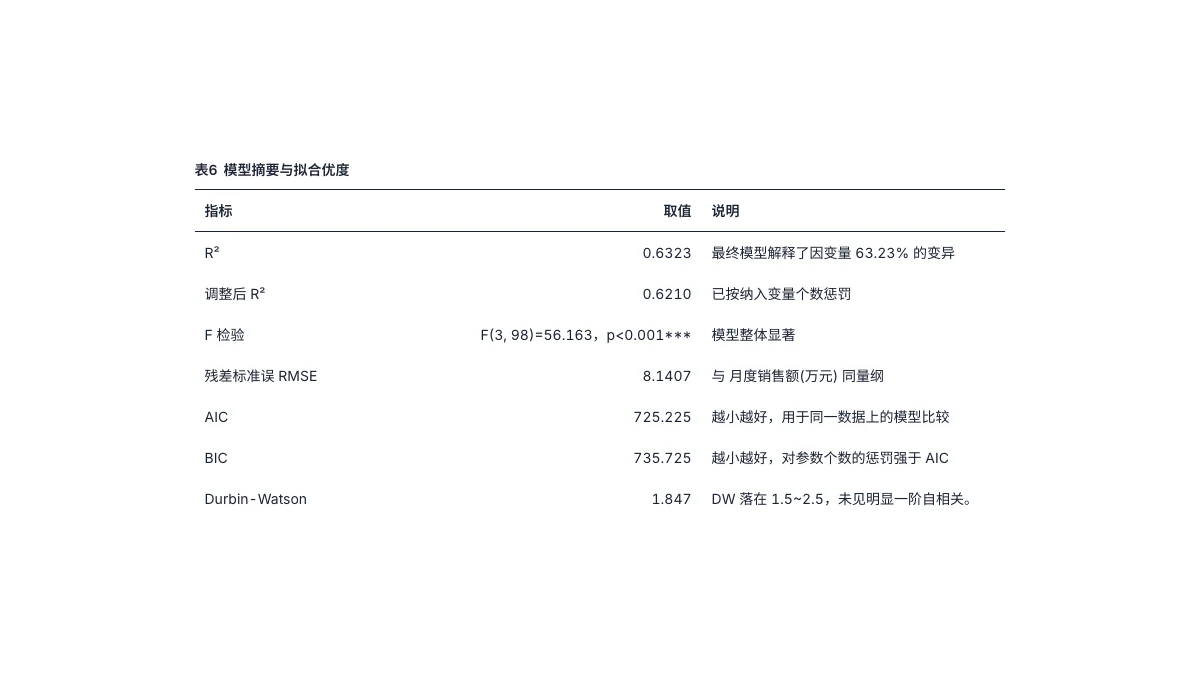
截图呈现最终模型拟合摘要,可用来核对路径末行是否与最终输出一致。主结果、路径表和诊断图应来自同一次分析,避免只换系数表而沿用另一版模型图;演示数据不用登录就能跑;用自己的数据分析、导出 Word / PDF 报告、使用 AI 解读需要开通会员。
回归三线表写作中容易混淆的地方
- 将 R²上升直接写成预测能力提升:改为当前样本拟合指标改善,另报告独立验证或交叉验证的结果。
- 只给最终系数而没有筛选路径:补上各步变量集合与拟合指标,使读者能追溯模型如何形成。
- 用多重比较校正消除全部筛选偏倚:系数间校正与数据选择模型是不同问题,需要单独说明选择性推断的限制。
- 把空白检验或未纳入项标为不显著:应区分未运行、不可估计和有效检验未显著,并以对应状态作表注。
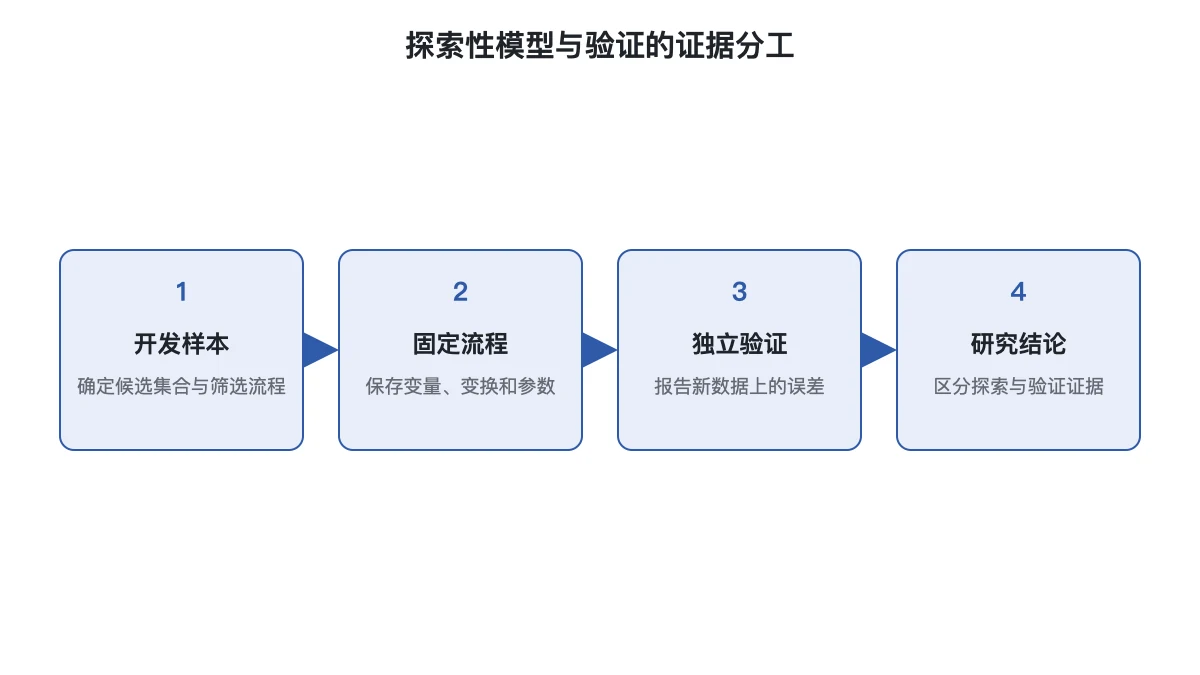
流程图把探索性建模与后续验证分开,强调验证数据用于检验既定流程,而非看结果后再反复回到开发集挑变量。若研究目的侧重解释,应优先依据理论预定变量集合,避免把一次筛选中留下的变量自动视为稳定的关联结构。
正文段落示例
可以写成:「采用双向逐步法,在预定的候选集合中筛选自变量,各步使用相同完整记录。模型的样本内 R²依次为 0.4692、0.5848 和 0.6323,最终模型调整后 R²为 0.6210。由于变量选择与系数估计使用同一批数据,本结果作为探索性拟合报告,系数的常规检验与区间未校正模型选择带来的不确定性。」正式稿需再补列最终系数表、全部候选指标含义、缺失处理与验证方案。
延伸阅读
常见问题
逐步回归分析三线表只写最终模型可以吗?
最终系数表还应配套说明候选集合、筛选规则和形成路径。各步拟合表能帮助读者核对模型变化,解释变量选择带来的局限。
逐步回归结果的R²增加就代表预测更准吗?
这是当前样本的拟合变化,是否能在新样本中保持预测精度,需要另行使用独立验证或事先定义的交叉验证方案。
回归三线表中的未纳入项可以标不显著吗?
未纳入、未运行和不可估计各有不同含义,应按实际状态注明。只有完成有效检验,才有对应的显著或未显著结论。