SPSS 偏相关分析原理与操作:控制变量后相关还剩多少
偏相关分析原理是先从两个分析变量中分别扣除指定控制变量的线性部分,再计算两份残差之间的相关;结果仍是条件关联,因果解释另需研究设计。SPSS 是统计软件名称,本文在独立平台 SPSSAI 的演示报告中,对照零阶与偏相关,说明控制后关联为何可能变大而非缩小。
偏相关的数据角色怎么排
以下结果来自本站演示数据(模拟生成,不代表真实研究结论),使用完整 120 行。工作压力得分、情绪耗竭得分和职业倦怠得分是分析变量,睡眠质量得分、组织支持感和工作投入度是控制变量;每行均为同一对象的完整记录,变量角色在比较前固定。
| 字段集合 | 角色 | 本例任务 |
|---|---|---|
| 工作压力、情绪耗竭、职业倦怠得分 | 分析变量 | 计算各对的剩余线性关联 |
| 睡眠质量得分、组织支持感、工作投入度 | 控制变量 | 同时用于双方的残差化 |
| 每个对象一行 | 观测结构 | 保持各列一一对应 |
这里的「控制」是统计模型的条件化操作,并未让真实对象的控制变量都变成同一个值。控制变量应根据问题、测量时序和领域知识选择,若把中介或碰撞变量纳入,可能改变研究对象或引入偏倚,显著性结果无法决定哪一组控制项在理论上合理。
在工作台复现偏相关分析
- 在数据分析中选择「偏相关分析」,载入其演示数据,核对各列含义和数值类型,保留上面列明的全部分析及控制变量。
- 按分析变量与控制变量的角色分别摆放,确认控制项在每一对比较中保持一致;本例没有单独为某个变量对更换控制集合。
- 点击开始分析,先核对前提卡的有效样本与控制变量数,再读取主表中的零阶相关、偏相关、区间和自由度;完整记录原始及多重性处理口径。
有效样本取决于某对分析变量和全部控制项的共同可用记录,因而有缺失时不同变量对的样本可能不同。比较控制前后系数时尤其要核对是否在同一批观测上计算,本例报告已在相同记录上给出零阶系数,避免把样本变化误认为控制产生的变化。
偏相关分析原理对应报告中的哪些数字
本例控制变量共有 3 个,检验自由度为 115。情绪耗竭得分与职业倦怠得分的零阶相关为 0.577,偏相关为 0.591,95%CI [0.459, 0.698],原始 p<0.001;这表明在该控制集合下仍检出正向线性关联,且本例系数略有增大。
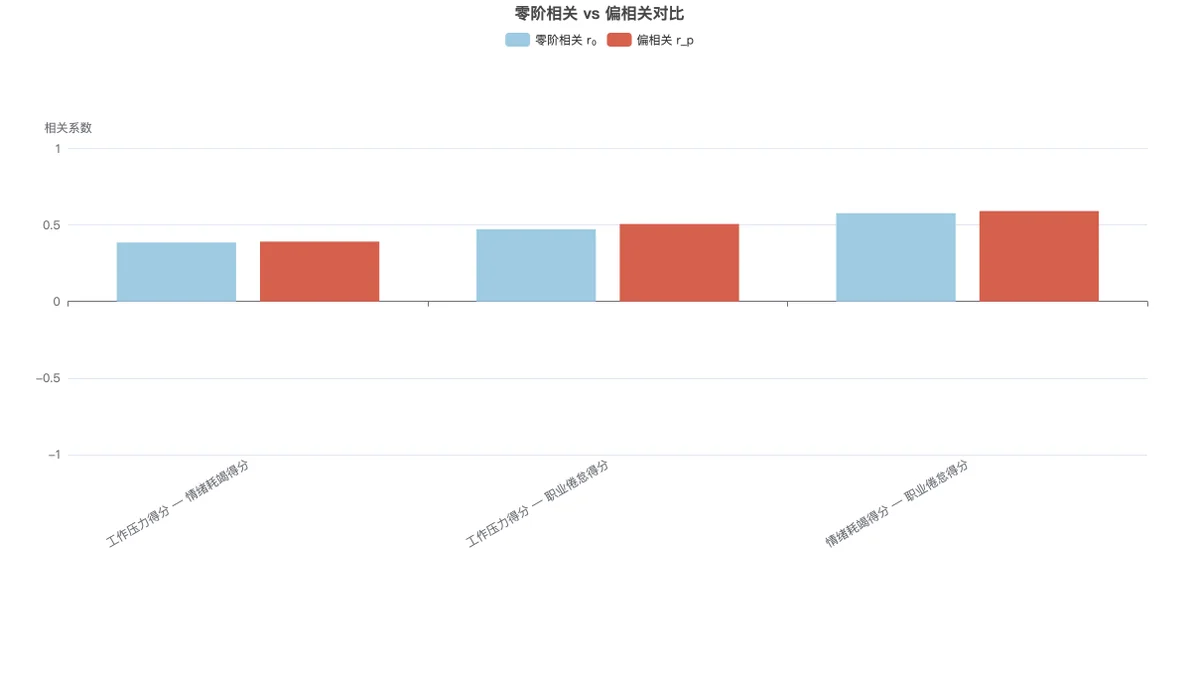
并列柱形图将控制前后估计放在同一轴上,方便看出哪个变量对变化较明显。控制后系数增加并非计算错误,也不意味着已经找到了真实因果关系;它只是当前线性投影与变量协方差结构共同产生的条件关联变化。
工作压力得分与职业倦怠得分的零阶系数为 0.472,控制后为 0.507。这组变化比上一组更明显,但尚不足以仅凭差值断言某项控制变量是混杂因素;若要区分具体控制项的作用,还需预先定义对应模型及研究依据,而不是从现有结果反推时序。
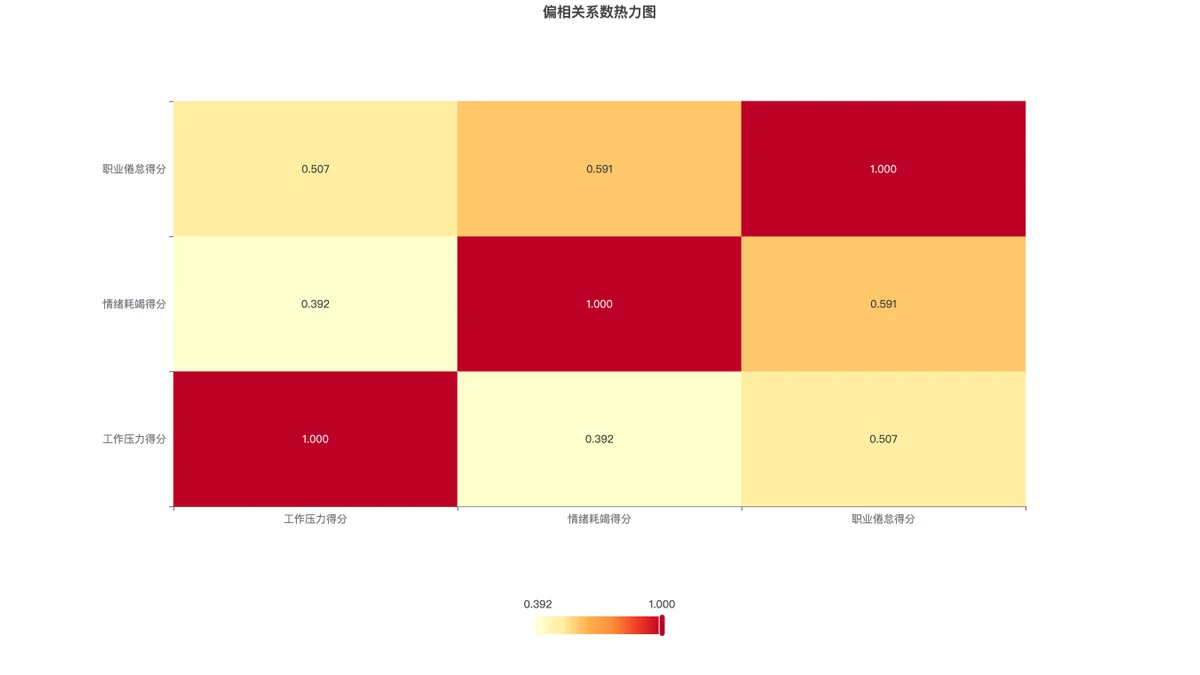
热力图显示当前控制集合下各对关联,颜色与单元格数值用于定位,显著性与精度仍应回到主表查看。对角线是变量与自身的相关,不属于需要解释的研究发现;有缺失显示或空白时,应区分数据不足、残差退化与真正未显著的检验。
控制变量和自由度要怎样写进论文
可写:「在演示样本中,控制睡眠质量得分、组织支持感和工作投入度后,情绪耗竭与职业倦怠仍呈正向线性关联,r_p=0.591,95%CI [0.459, 0.698],p<0.001。」正式稿需附样本来源、缺失策略和控制项纳入理由,避免只写一句「排除了其他影响」。
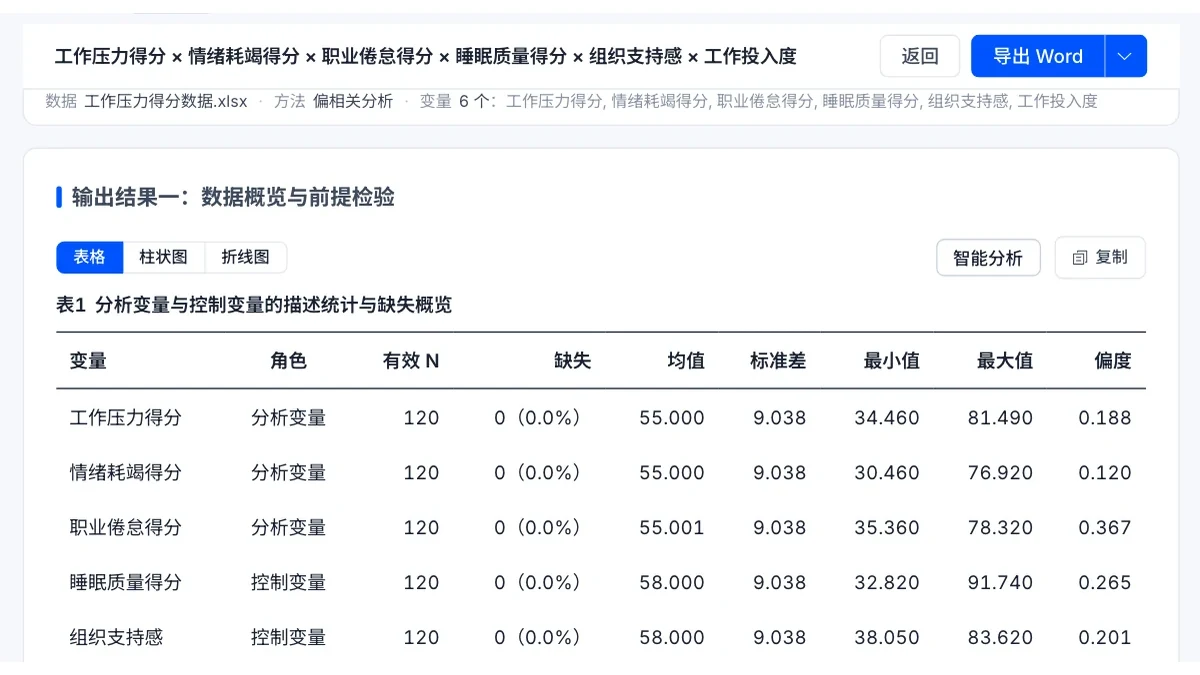
前提卡节选完整展示前五项变量角色及描述统计,说明这些数字与变量角色相互对应。本例控制变量 VIF 未见严重共线性提示,但这是估计稳定性的一部分证据,未测混杂、非线性和测量误差仍可能影响解释范围。
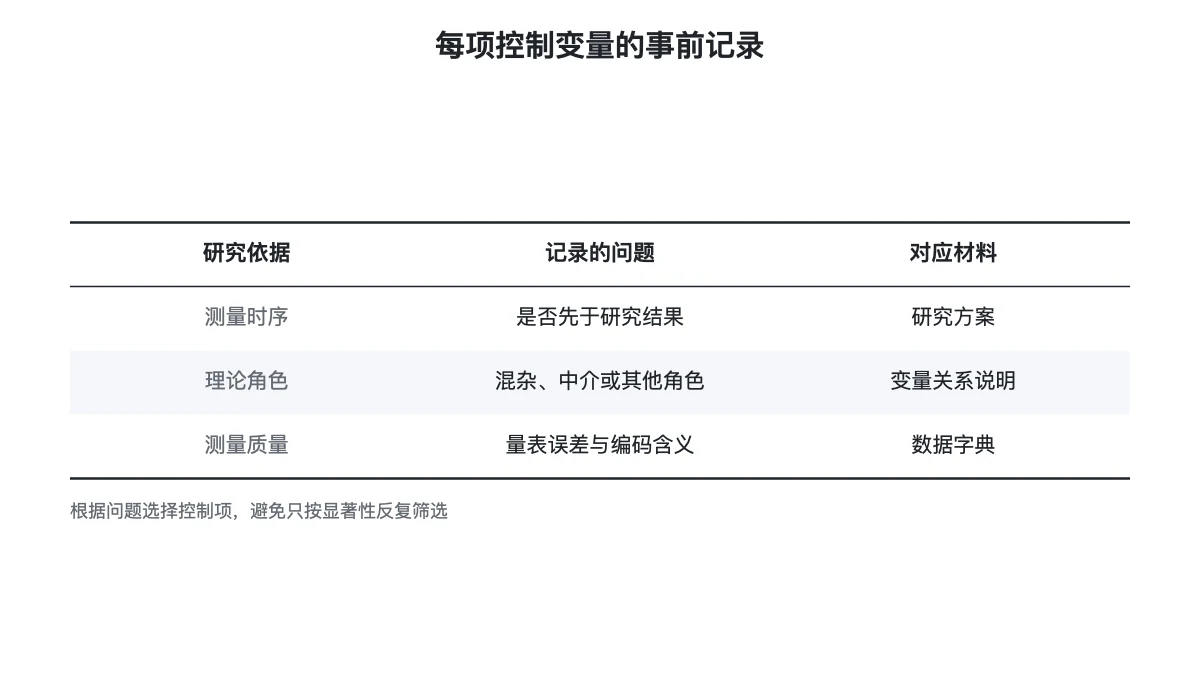
图中补充的是选择控制项的记录格式,重点留下每项变量为何进入模型的理由。它与统计诊断分工不同,适合在拟合前完成并与分析结果一起归档;演示数据不用登录就能跑;用自己的数据分析、导出 Word / PDF 报告、使用 AI 解读需要开通会员。
偏相关解读常见错误
- 认为控制后系数只能缩小:残差间的线性关联也可能增大,应按同批观测上的实际估计解释。
- 把条件关联写成净因果效应:应明确控制集合与线性形式,设计上的识别假设另行论证。
- 把未显著或无法估计都写成关系消失:前者报告证据不足与区间,后者先检查有效记录和残差方差。
延伸阅读
常见问题
偏相关分析原理就是把控制变量固定吗?
统计计算是分别对两项分析变量作线性残差化,再计算残差之间的相关。它没有改变现实对象的取值,解释仍限定在指定模型条件下。
控制变量越多越好吗?
控制项应有研究依据,也会消耗自由度。错误控制可能改变要回答的问题,纳入前需要交代时序、测量含义与理论角色。
控制后相关变大说明程序错了吗?
系数可能增加也可能减小,需确认同批样本和同一控制集合。变化本身只反映条件线性关联,不足以确立因果解释。