
SPSS NPS 净推荐值怎么算:推荐者、被动者与贬损者
更新于
NPS 净推荐值等于推荐者占比减去贬损者占比,计算时先按评分划分人群,再用全部有效评分作分母。SPSS 相关的推荐意愿分析可以在本站用演示数据练习;读结论时应把比例差和置信区间放在一起,避免只比较单个分数。
NPS净推荐值的数据要怎么排
一位受访者一行,推荐意愿评分单独一列,保留原量表的零到十分刻度。方法入口见NPS净推荐值分析,这里分析的是推荐意愿题,而非把所有满意度题都压成同一个指数。
以下结果来自本站演示数据(模拟生成,不代表真实研究结论),使用全部 200 条推荐意愿评分。数据中的非整数、越界和缺失记录在概览表中分别列出,因此确认有效分母应当先于查看净推荐值。
| 原始评分 | 人群 | 进入计算的位置 |
|---|---|---|
| 9—10分 | 推荐者 | 正向比例项 |
| 7—8分 | 被动者 | 全样本分母 |
| 0—6分 | 贬损者 | 负向比例项 |
这张表定义了分类规则,题干本身也需要与推荐意愿相符。把重复填写当成不同受访者会使样本看起来更充分,因此独立记录的核对需要回到采集流程,报告中的数字无法单独完成这项核查。
净推荐值计算在本站怎么做
- 选择「NPS净推荐值分析」,上传包含推荐意愿评分的 .xlsx 或 .csv 表。
- 放入推荐意愿评分列,确认原量表范围,检查数据概览中的有效样本与被剔除记录。
- 开始分析后依次读人群构成、NPS主结果和区间,再检查结论所对应的检验假设。
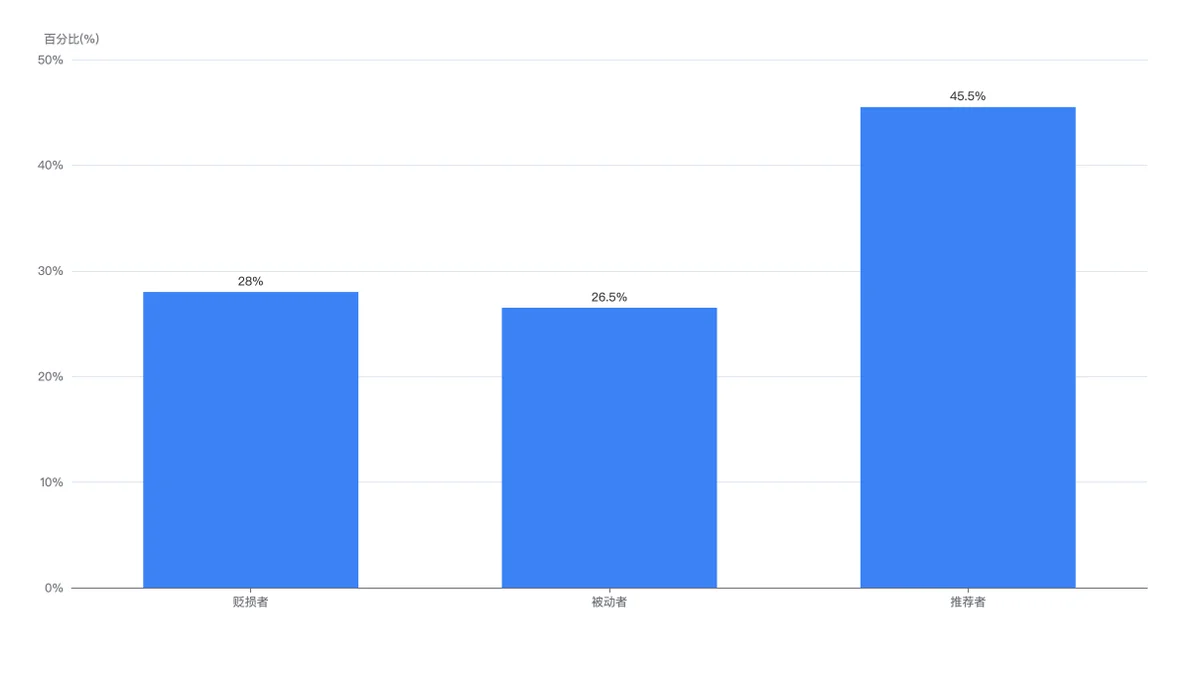
本例推荐者、被动者与贬损者分别为 91、53、56 人。被动者虽然没有直接出现在相减的两个分子里,仍留在全部有效应答的分母中,所以比较两份样本时,不能只看推荐者和贬损者的人数。
演示数据不用登录就能跑;用自己的数据分析、导出 Word / PDF 报告、使用 AI 解读需要开通会员。操作完成后先保留原始评分分布,再复制结果段,能让报告读者同时看到分组前后保留了哪些信息。
评分分布与人群构成怎么看
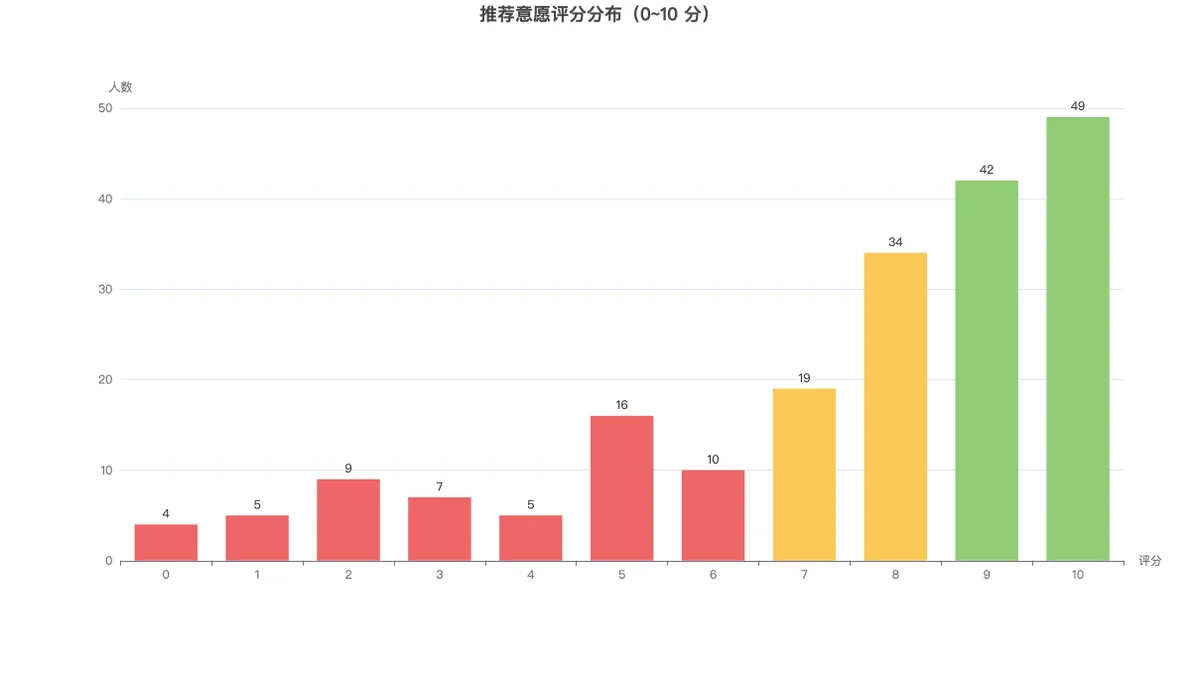
逐分值图保留了原始刻度,可以判断高分是否集中在某个档位,也能观察低分端是否分散。它补充的是三类标签内的细节,某个人从低分提高到同属贬损者的另一档,分类本身仍保持原样。
三类人群构成图适合交代整体分布,但同样的净推荐值可以来自不同的三类组合。为了让后续团队判断具体应该复查哪部分反馈,报告里应留下人群构成和原始评分,而不是只保存一个汇总数。
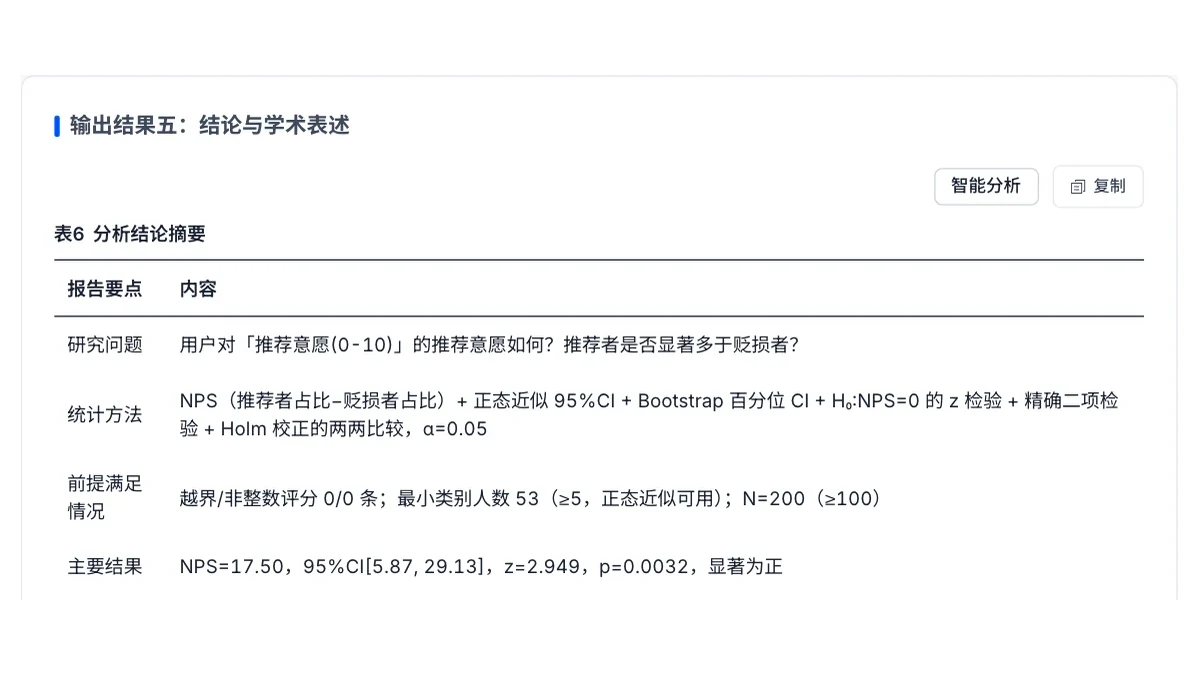
本次净推荐值为 17.50,解析置信区间为 [5.87, 29.13]。区间位于零之上,表示在当前抽样与独立性假定下,有推荐者比例高于贬损者比例的统计证据;它没有检验是否完成某个业务目标。
置信区间与检验假设如何连接
报告同时提供解析区间和重抽样区间,以及围绕零净推荐值的检验。下图梳理的是读数顺序:先交代指标,再限定推断对象,最后根据研究目标决定是否需要另做跨期或组间比较。
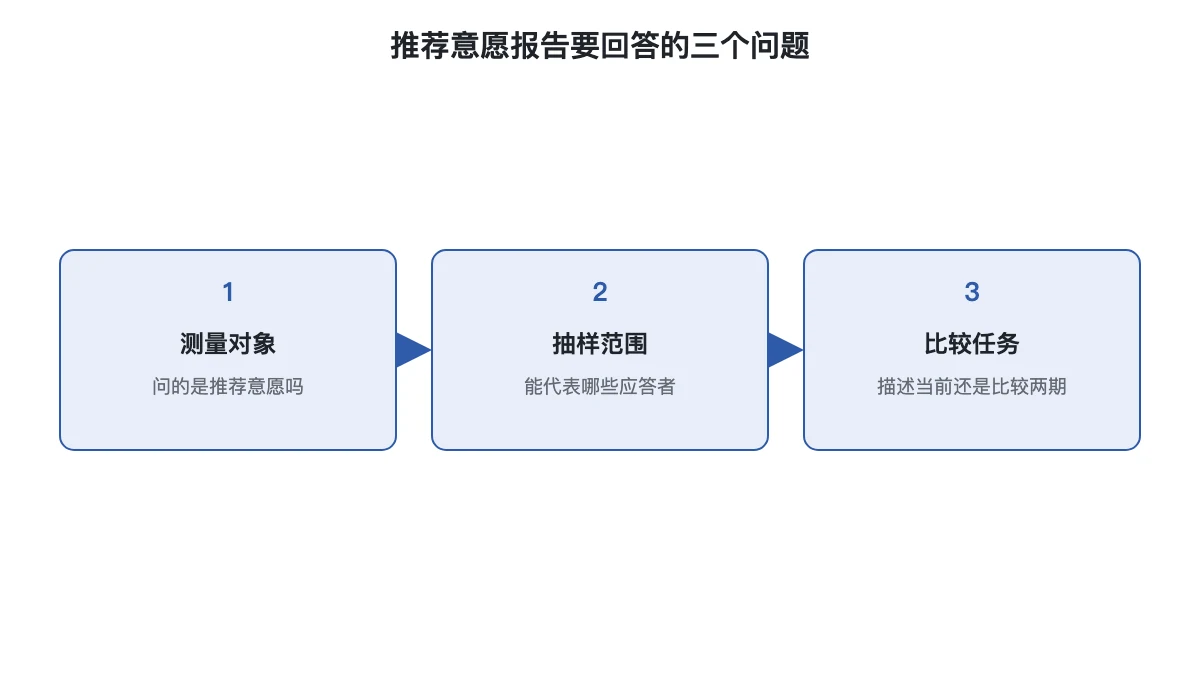
跨期研究若要判断两期是否发生变化,应设计直接的差值分析,单看两段区间重叠情况只能作粗略观察。推荐意愿也属于态度指标,对实际推荐行为与经营结果的解释,需要相应的行为数据和研究设计。
推荐意愿结果在论文里怎么写
可以写成:本研究对推荐意愿演示数据进行净推荐值计算,NPS为17.50,解析置信区间为[5.87, 29.13],在当前数据及模型前提下检出正的比例差。结果仅描述这批评分中的推荐意愿构成,不据此推断真实业务改善。
正式报告还需补上采样范围、时间窗口、应答率和独立性保障方式。这些信息来自研究过程,当前演示报告并未提供,因此填写模板时应根据自己的研究补全,而非沿用模拟数据的背景。
NPS分析常见错误
- 把被动者从分母删去:检查比例的基数是否为全部有效评分。
- 把偏离零写成达到目标:将统计假设与事先设定的业务目标分别报告。
- 把推荐意愿写成实际推荐行为:保留量表题意,行为结论另用行为记录验证。
- 只看两次点估计的升降:研究比较应同时考虑抽样结构和差值的不确定性。
延伸阅读
常见问题
- NPS净推荐值为什么没有被动者那一项?
- 净推荐值定义为推荐者占比减去贬损者占比,被动者仍包含在全体有效样本的分母里。他们不直接进入分子,却会改变各类比例。
- 净推荐值计算能用满意度五分题吗?
- 本站这个模块接收零到十分的推荐意愿评分,评分题意和量表范围都应先核对。五分满意度测量的是另一概念,不宜直接照用同一分类边界。
- NPS的置信区间跨零应该怎样写?
- 应写当前数据尚未检出净推荐值偏离零的统计证据,并同时给出点估计与区间。若区间无法估计,则交代数据或计算限制,保留不可估计状态。