
SPSS 多重插补结果怎么合并:多套数据的汇总规则
更新于
多重插补结果应把各套估计的组内方差与跨套变异一起合并,而非挑一套填充值或拼接所有记录。SPSS 相关的插补问题可以在本站练习 Rubin规则;当前模块合并的是变量均值,后续回归系数的汇总需要另外设计分析流程。
多重插补结果的数据与目标怎么定
先定义要报告的估计量,再整理参与预测的变量,避免把插补理解为一项脱离分析目的的数据修补。本站方法说明见多重插补,这篇只解释本次报告已计算出的均值合并结果。
以下结果来自本站演示数据(模拟生成,不代表真实研究结论):从原始 140 行中随机抽取 119 行,使用收缩压与总胆固醇两列。子样本在上传前准备:以原表行序为基准,用 Python 的 random.Random(3).sample 从行位置无放回抽取,再按原行序保存;这不是在工作台直接载入完整演示表。报告移除一条全缺失记录后,有效样本为 118 条,数据中确实存在需要插补的单元格。
| 变量 | 性质 | 核查重点 |
|---|---|---|
| 收缩压(mmHg) | 定量 | 测量单位及填入值范围 |
| 总胆固醇(mmol/L) | 定量 | 变量间可利用的关联 |
| 整行均缺失 | 无观测信息 | 与局部缺失分别记录 |
这次演示只纳入两个测量变量,因此推断范围也应限定于它们的均值。研究中若还关心其他协变量、交互关系或结局,插补模型的设定需要与研究目标相配,当前示例没有替这些变量补齐信息。
插补数据集与参数在本站怎么设置
- 选择「多重插补」,放入两个待分析的定量变量,先检查各列缺失概况。
- 本例保留插补次数 5、最大迭代次数 10、插补随机种子 42 的既定设置,运行后核对概览表记录的实际参数。
- 查看均值的 Rubin 合并估计,再把方差分解与缺失信息比作为不确定性解释的一部分。
演示报告使用贝叶斯岭回归的后验采样构造多套填充值,线性高斯设定属于该实现的边界。对有自然上下界的测量,填入值是否合理仍需人工核查;生成了完整数字并不意味着它们已经符合专业知识。
演示数据不用登录就能跑;用自己的数据分析、导出 Word / PDF 报告、使用 AI 解读需要开通会员。保留参数和缺失处理记录,有助于在研究报告里区分原始缺失、被移除的记录以及最终参与均值估计的样本。
Rubin规则里的均值与标准误怎么看
本次收缩压的合并均值为 128.2914,合并标准误为 1.4547。前者描述估计位置,后者衡量该均值的不确定性,两个统计量承担不同任务,不能把平均标准差误填进标准误一列。
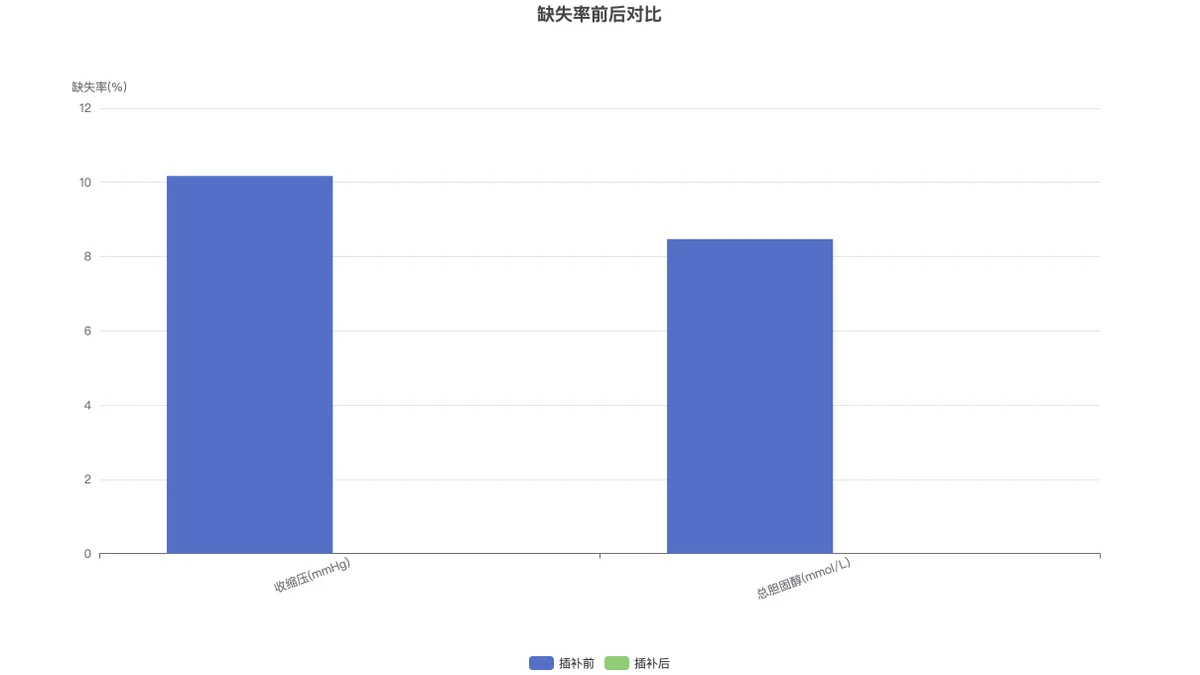
缺失率前后对比展示两列测量在插补后的完整程度。缺失位置被填入后,柱图上的缺失比例下降,但这只是数据完整性的变化;填充值仍含估计误差,图形本身没有检验随机缺失假设。
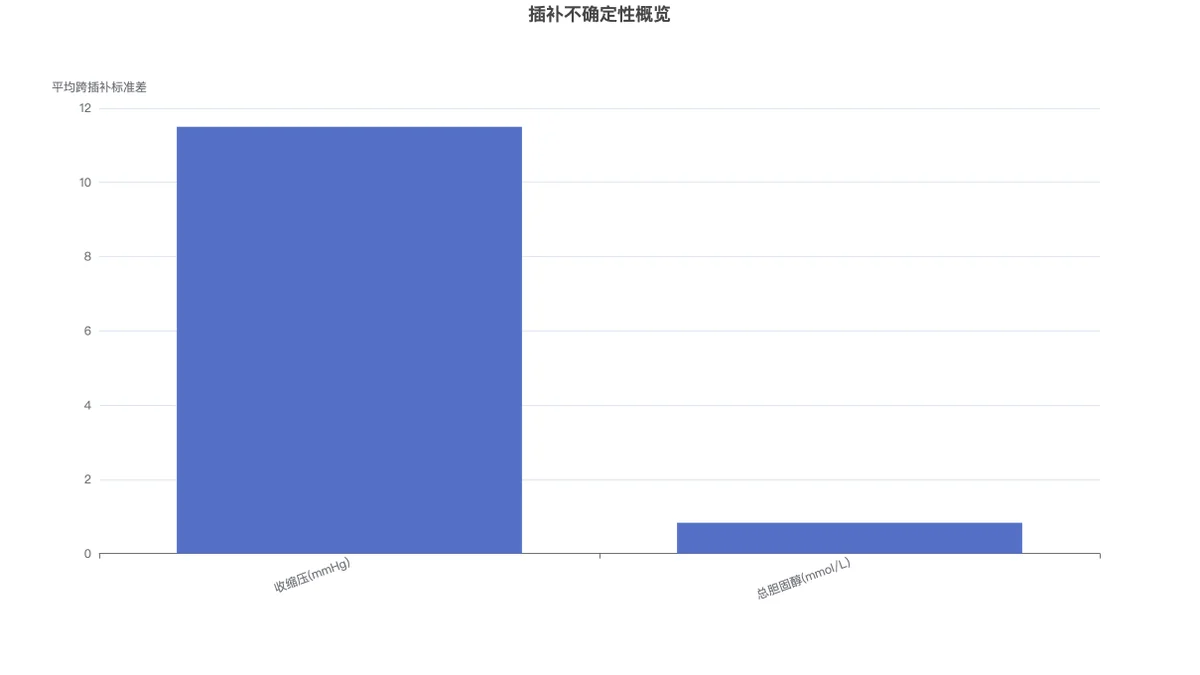
各套均值先取算术平均;设套数为 m,总方差 T=Ū+(1+1/m)B,其中 Ū 是各套均值估计方差的平均,B 是各套均值的样本方差。收缩压的 Ū=2.0624、B=0.0449、T=2.1163,合并标准误为 √T;代入本例套数可核对总方差,显示值因舍入只作近似核算。下图展示缺失位置上填充值的平均跨插补标准差,带有原变量单位;两列单位不同,柱高不用于比较谁的均值估计更精确。缺失信息比则针对估计精度,应与原始缺失率区分。
先核对合并对象再复用报告
报告的不确定性卡中,总胆固醇的缺失信息比为 15.04%,按本次报告采用的经验规则,默认插补次数被提示偏少。这个提示针对蒙特卡洛稳定性,增加次数也无法修复错误的缺失机制假设或明显失配的插补模型。
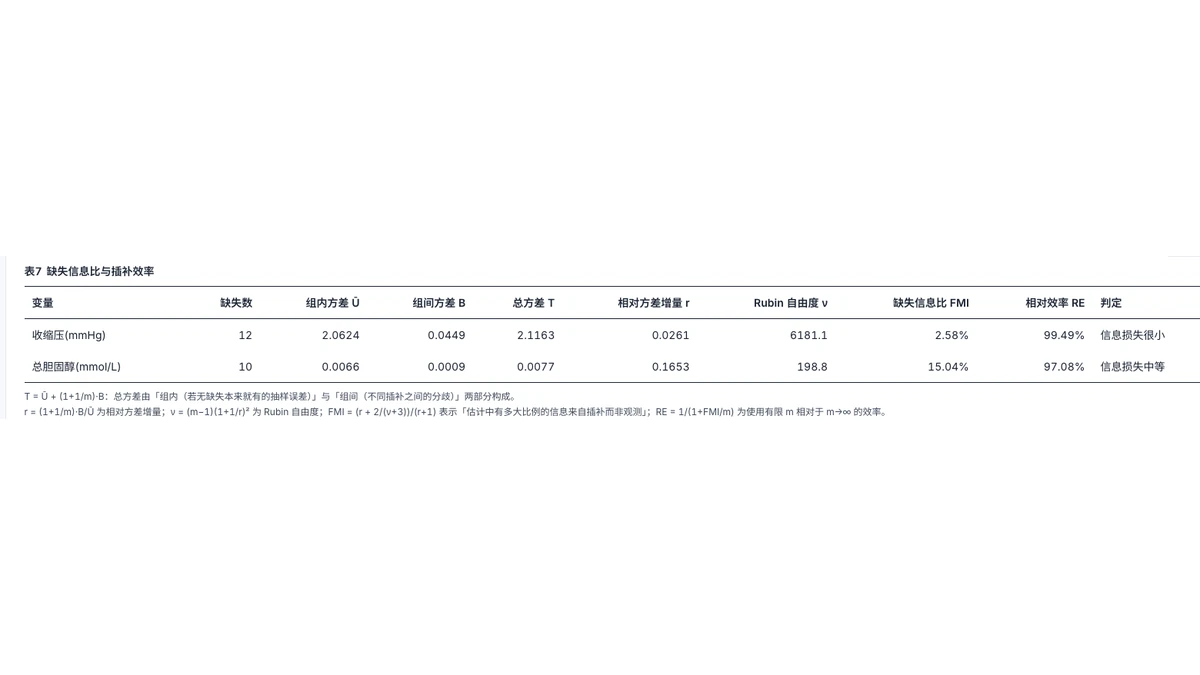
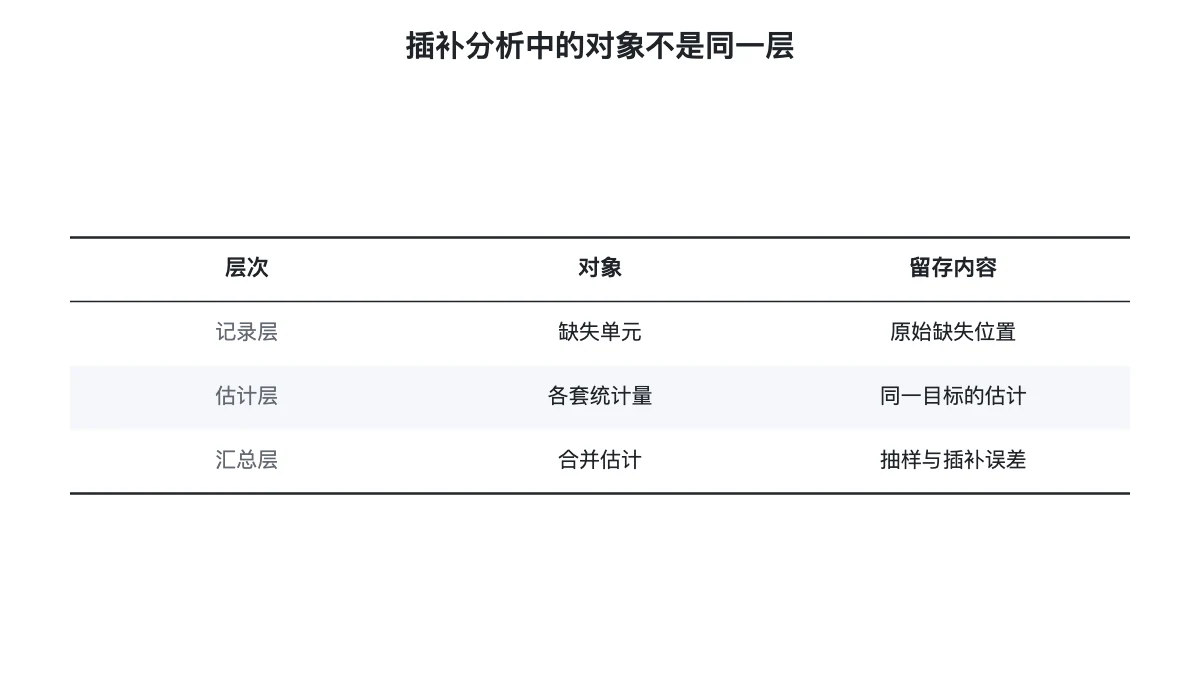
下图把准备、估计和汇总拆开,强调合并对象应保持一致。方差分解表用于核对组内、组间变异与合并精度。本站当前输出均值结果,预览表只用于观察其中一套的填入情况,未提供从这些数据直接批量拟合回归并自动汇总的功能。
多重插补的方法段怎么写
可以写成:对两列定量测量的缺失值实施链式方程多重插补,采用贝叶斯岭回归后验采样,按 Rubin规则合并变量均值及其方差,并检查缺失信息比。收缩压合并均值为128.2914,合并标准误为1.4547;这些结果仅用于模拟数据的均值描述。
正式研究还应说明为什么纳入这些变量,以及随机缺失假设的专业依据。MCAR必要条件检验未显著,仅表示当前检验未发现相应关联证据,既不能确认MAR,也无法排除由未观测值驱动的缺失。
多重插补常见错误
- 把完整预览当成最终研究数据:区分核查填入值与合并估计两项任务。
- 只平均各套标准误:按方差层面汇总,同时保留跨套差异。
- 把缺失信息比写成缺失比例:分别注明估计精度指标与原始缺失量。
- 将本站均值合并说成自动合并所有后续模型:只报告本次实际执行的链路。
延伸阅读
常见问题
- 多重插补结果是把所有数据拼起来吗?
- 应合并每套数据上得到的同类估计量,并同时纳入组内和组间变异。直接拼接记录会把同一观测的不同填充值当作新增独立样本。
- Rubin规则合并的是回归系数吗?
- 一般方法可针对符合条件的估计量使用,但本站当前模块直接输出的是各变量均值的合并结果,没有自动把插补数据接到后续回归模型的链路。
- 插补数据集预览能选一套用于论文吗?
- 预览适合核对填入值和变量范围,单独选一套会遗漏跨套的不确定性。正式报告应保留全部插补的合并口径,并交代插补设定与分析范围。