SPSS KM生存分析:中位生存时间与生存率表怎么读
更新于
km生存分析先用随访时长和事件标记估计生存曲线,再读曲线降到一半时的中位生存时间,以及指定时点的生存率。本文在本站演示如何分开报告这两类结果;曲线尚未达到相应水平时,应保留“不可估”的结论。
生存资料怎么排:删失与缺失分开处理
以下结果来自本站演示数据(模拟生成,不代表真实研究结论):从随访资料中随机抽取 170/200 行,抽样种子为 3。每行对应一位观察对象,时间单位为月;这里的治疗方案标签只是模拟分组,结果用于学习统计报告。操作入口和方法说明见Kaplan-Meier生存分析。
| 列名 | 类型与含义 | 使用位置 |
|---|---|---|
| 随访月数 | 定量,从共同定义的起点到事件或删失 | 生存时间 |
| 结局事件 | 分类编码,1 为事件、0 为删失 | 事件指示 |
| 治疗方案 | 分类,常规化疗或靶向治疗 | 分组比较 |
起点、事件定义和记录单位应先在研究方案里统一。比如把“入组至复发”的时长与“手术至死亡”的时长混进同一列,即使能得到一条曲线,也无法赋予共同的研究含义;这属于资料定义问题,读结果时要先排除。
本次有效资料包含事件 108 例、删失 62 例。删失者在停止观察前仍进入风险集,提供“至少随访到此时”的信息;把他们整行删除会改变估计对象。真正的缺失则是时间或事件状态没有可靠记录,需要回查原始资料,并在报告里交代纳入规则。
km生存分析怎么做:先核对编码再读取报告
- 在数据分析的方法列表选择「Kaplan-Meier生存分析」,载入演示资料;复现本文数字需使用上述抽样数据,直接载入完整演示表会得到另一组估计。
- 按页面的生存时间、事件状态和分组字段配置相应列,核对事件值的含义与月数单位。查看资料概览里的有效记录、事件与删失构成,避免把事件和删失的编码读反。
- 点击开始分析后,依次查看主结果表和生存曲线,再查看效应量卡中的时点生存率与限制平均生存时间。分析和查看结果不用登录;开通会员后可导出 Word / PDF 报告、使用 AI 解读。
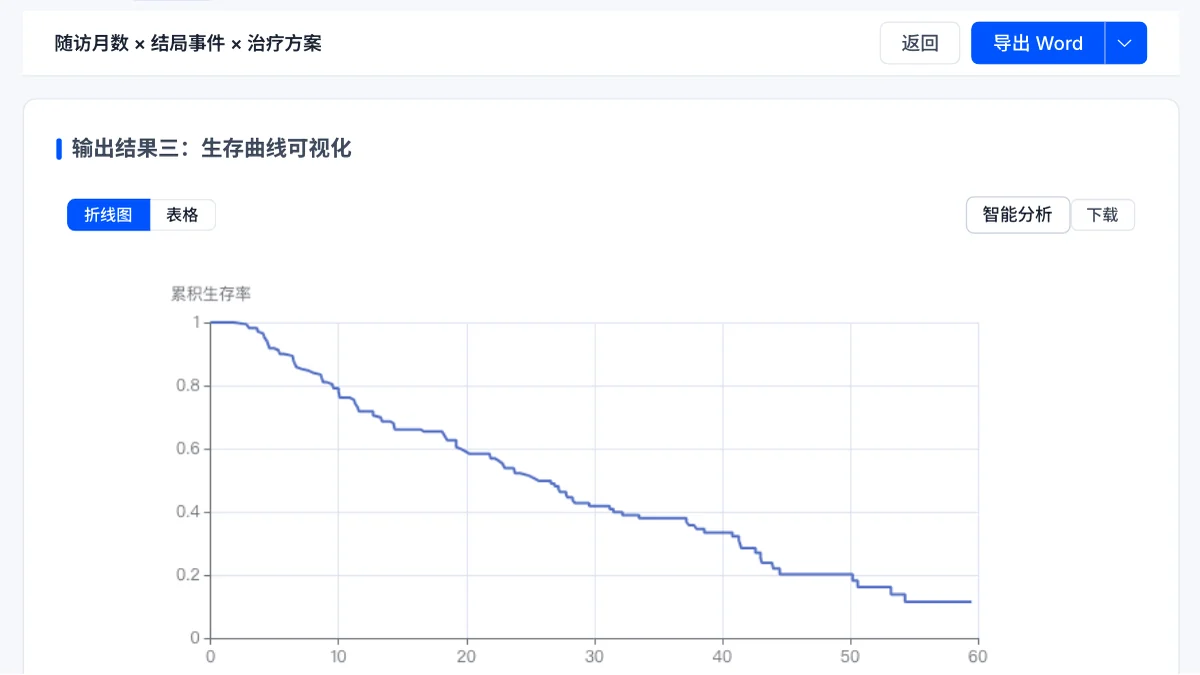
报告的可视化卡有“折线图”和“表格”切换入口。下面截图用于定位这一入口:折线图呈现随时间下降的估计,表格便于逐行核对曲线上相应位置;论文中应写明实际使用的时点,而非仅描述曲线高低。
中位生存时间怎么看:别用随访中位数顶替
主结果表中,常规化疗组的中位生存时间为 18.300,95%CI 为 11.600~25.300;靶向治疗组为 33.500,95%CI 为 24.900~41.500,单位均为月。这里估计的是生存函数下降到一半的时间,区间刻画估计的不确定性;它与所有记录的随访月数取中位数回答不同问题。
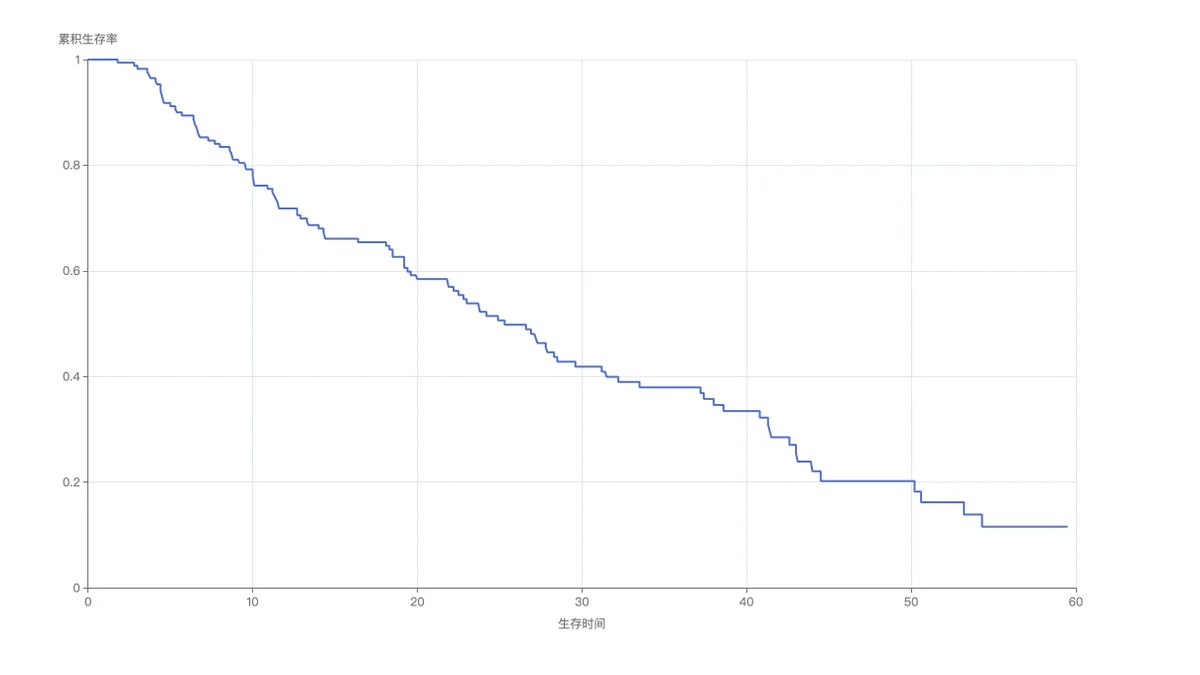
全体曲线用于展示合并后的生存过程,分组曲线则保留组别差异。读曲线时应留意尾部信息逐渐减少:曲线末端仍在延伸,并不意味着远期估计与早期同样精确;也应区分曲线位置、区间和组间检验,各自负责不同层面的判断。
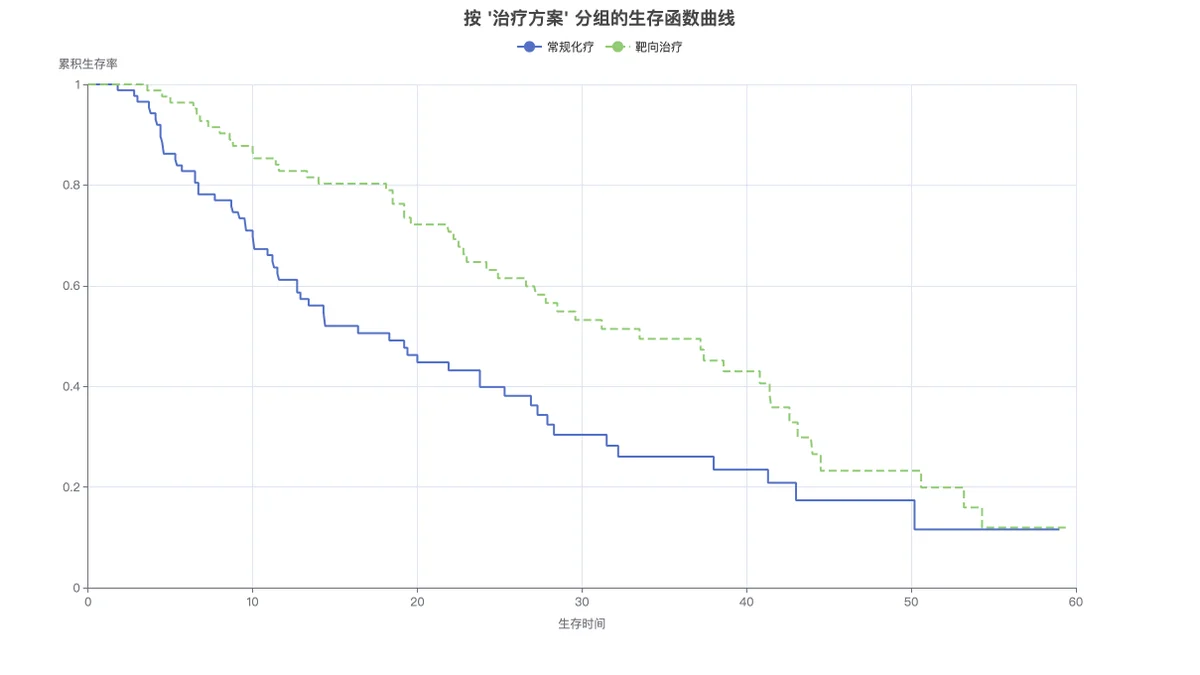
本次 Log-Rank 检验 χ²=9.064,p=0.003,提示两组生存分布存在统计学差异。但比例风险诊断 p=0.022,提示用恒定风险比概括整个随访期需要保留。此时应补充限制平均生存时间,而非把一项显著检验直接写成某种方案导致更长生存。
生存率表怎么看:先锁定时点再读区间
时点生存率回答“观察到某个月时仍未发生事件的概率是多少”。本次报告在 19.75 月处,常规化疗组 S(t)=0.4622,95%CI 为 0.3496~0.5674;靶向治疗组 S(t)=0.7216,95%CI 为 0.6081~0.8074。这些是考虑删失后的估计,并非简单用尚未发生事件人数除以最初总人数。
该时点来自本次随访时长的分位数,并非事先指定的临床终点。写研究论文时,应先确定有意义的报告时点,再确认该处仍有足够的随访信息;把自动生成的时点擅自称为固定年限生存率,会改变结果含义。
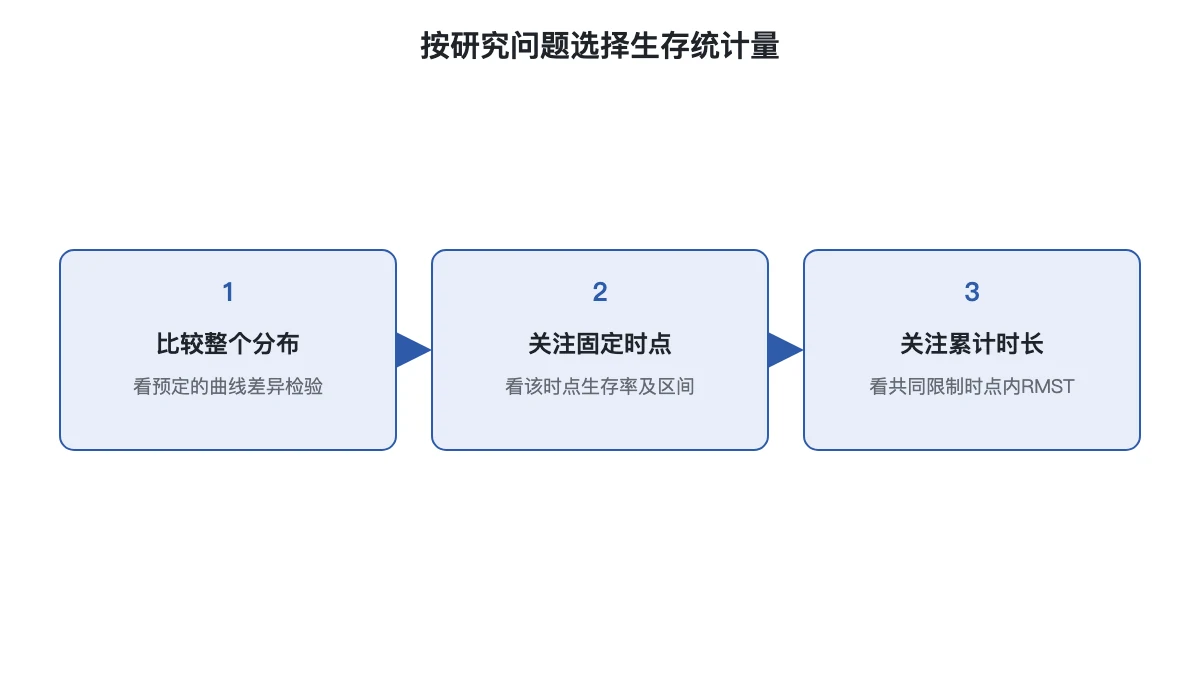
下面的示意图给出三种研究问题对应的阅读出口。它用于选择应该引用的统计量,具体数值仍以本篇真实报告为准;曲线整体差异、某个时点的概率以及限制期间的平均时长应分别表述。
生存结果在论文里怎么写
基于随机抽取的模拟随访资料,采用 Kaplan-Meier 法估计生存函数。两组中位生存时间及区间如主结果表所示,Log-Rank 检验提示生存分布存在差异;比例风险诊断提示该假定可能不成立。在共同限制时点 59.00 月内,靶向治疗组相对常规化疗组的 RMST 差为 9.394 月,95%CI 为 3.391~15.396,p=0.002。结果描述模拟分组的关联,不据此推断治疗因果效应。
正式报告还要补齐研究对象来源、事件定义、失访原因与分析前选定的检验。若 p 达到预定阈值,报告检出的差异及区间;未达到则写未检出差异;统计量不可估时说明资料限制,保留不可估状态。
生存资料解读常见错误
- 把随访中位数抄到生存时间栏:回到主结果表核对统计量名称,分别报告随访与生存估计。
- 用两组中位数区间的重叠判断显著性:采用预定的组间检验,区间用来呈现精度。
- 只因删失粗筛显著就删病例:回查删失原因和发生方向,行政随访结束与预后相关失访应区分讨论。
- 把尾端曲线外推到资料范围之外:限制结论的时间范围,补充该范围内有意义的生存率。
延伸阅读
常见问题
- km生存分析的中位生存时间显示不可估怎么办?
- 先确认曲线是否下降到一半。尚未达到时应如实报告不可估,补充随访范围内预先关注时点的生存率及区间,避免把最后一次随访时间当作中位数。
- 删失病例要从生存率计算中删掉吗?
- 删失病例在离开随访前仍提供信息,应保留其已观察到的时长与删失标记;删失和缺失是不同概念,还需核实失访是否可能与预后有关。
- 两组中位生存时间的区间重叠就没有差异吗?
- 两个中位数各自的区间重叠程度并非正式组间检验。应结合预先指定的曲线比较检验与效应量,并单独交代比例风险诊断和删失机制。