sav文件用什么打开:不装 SPSS 也能读入数据直接分析
更新于
sav文件用什么打开?不装 SPSS 也行:在 SPSSAI 网页上传 .sav 文件,就能看到数据并直接分析,sav文件怎么打开的问题到这一步就解决了。数据值和缺失值会被读入,列名保持原始变量名,名义变量的取值标签会转成文字。
现象:sav文件怎么打开,打开后又和 SPSS 里不一样
.sav 是 SPSS 的二进制数据格式,Excel 之类的表格软件不能直接识别,所以双击打不开。上传到本站后文件能读,但会发现几处与 SPSS 数据视图不同:列名是原始变量名而不是标签,有序和尺度变量保留数字编码,日期变成了文本,名义变量则按值标签显示成文字。
原因:sav文件用什么打开,读进来的哪里不同
- 缺失值:SPSS 里用户指定为缺失的取值(例如 99 代表未作答)读入时按缺失处理,在预览表格里显示为空。
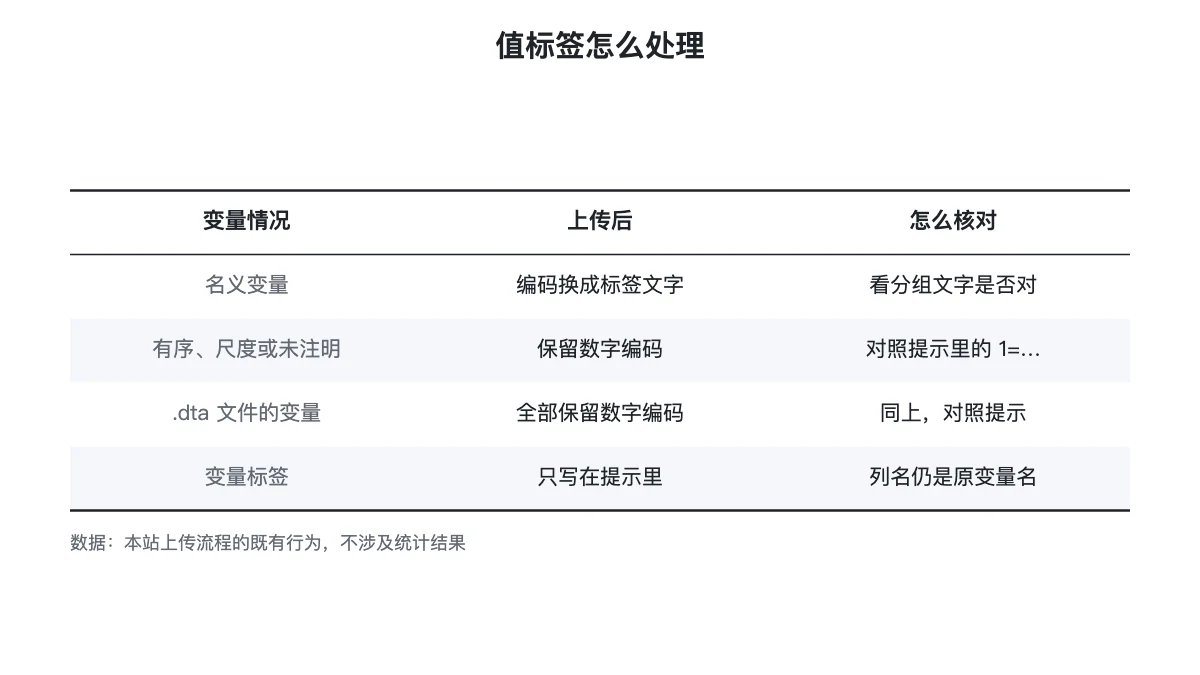
- 标签:列名始终是原变量名。只有 SPSS 里测量级别标成名义的变量,才按值标签把编码换成文字;有序、尺度或没注明级别的变量保留数字编码,因为有序编码换成文字会丢掉顺序,.dta 文件的列也都保留编码。
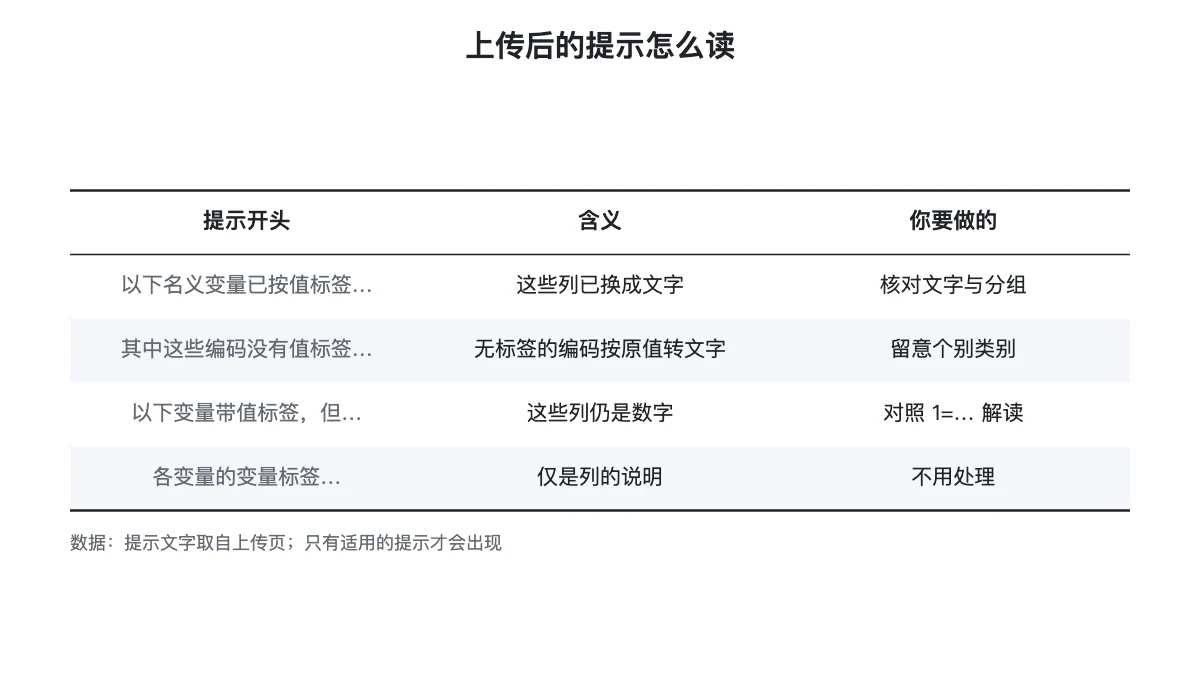
- 提示:上传后页面最多弹出四条提示,只有适用的才出现,开头分别是「以下名义变量已按值标签把数字编码换成文字(列名不变):…」「其中这些编码没有值标签,已按原值转成文字,与其它类别一起使用:…」「以下变量带值标签,但测量级别为有序、尺度或未注明,保留数字编码以免打乱顺序,解读时请对照:…」「各变量的变量标签(列名仍用原变量名):…」。
- 日期:日期时间列统一转成文本,时间部分都是零点的只保留年月日,写成 YYYY-MM-DD 这样的形式。
解决步骤:sav文件用什么打开最省事
- 直接上传 .sav 文件,无需先另存为 Excel 或 CSV;格式与大小的细节见SPSS 在线分析怎么用。
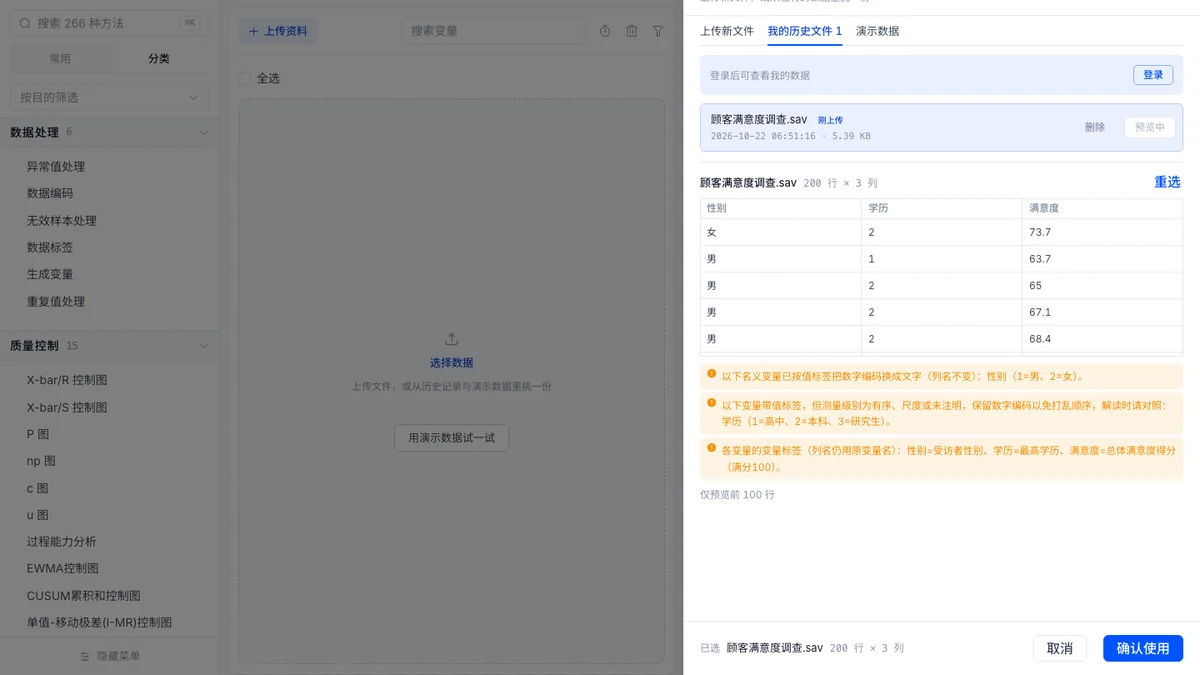
- 在预览表格里核对行数、列数,以及原本设为缺失的取值是否已显示为空。预览只显示前 100 行,总行数和列数以窗口里的文件摘要为准,下图的文件写着 200 行 × 3 列。
- 对照上传后的提示,确认被转成文字的列是你预期的;仍是数字编码的分类变量,在页面上把类型改成定类再分析。
下图的文件出现了三条提示。性别是名义变量,已按值标签换成男、女;学历是有序变量,保留 1、2、3 的数字编码,提示里写明 1=高中、2=本科、3=研究生;最后一条列出各变量的变量标签,列名仍是原变量名。
怎么确认已经解决
核对时看三项判据。预览的行数、列数与文件说明或原始记录里的样本量一致;设为缺失的取值在预览里是空白,而不是 99;提示里点名的名义变量在分析结果里显示为文字,有序变量仍是数字编码。
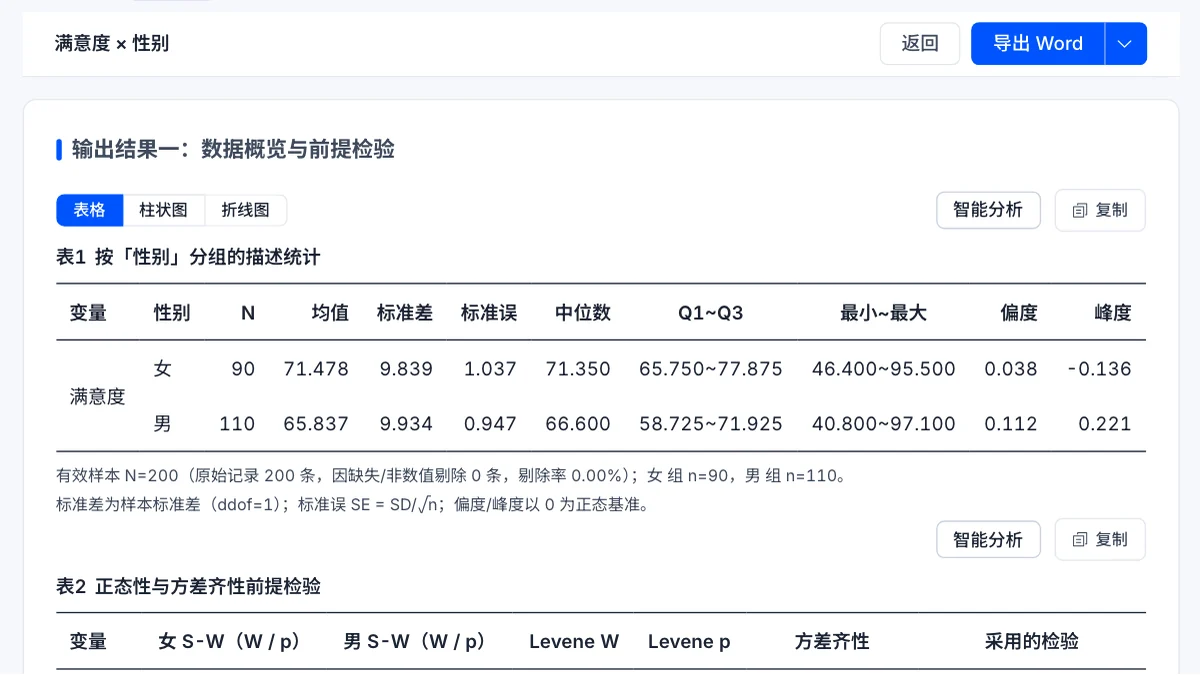
数据概览只要 3 行数据就能运行,适合上传后先体检一遍。想直接验证转换结果,也可以做一次分组分析:下图是上面那个带值标签的文件按性别分组做独立样本 T 检验,分组列里是女、男,而不是 1、2。如果某个分类变量仍被当成定量变量,数据概览会给它算均值和标准差,这样的均值没有意义,应该在页面上先把类型改成定类再重跑。
分析和查看结果不用登录;开通会员后可导出 Word / PDF 报告、使用 AI 解读。登录后可保存历史和我的数据。AI 解读不发送你上传的数据表文件,发送的内容见SPSS 在线做统计分析数据安全吗。
数据读进来之后,下一步用哪个方法
按目的选:想知道缺失是怎么产生的,用「缺失模式分析表」;确定要补缺失,按情形选「多重插补」或「均值估计/回归插补」;要看定量变量的分布细节,用「描述性统计」;分类变量的频数与占比,用「频数分析」;按组拆开看,用「分类汇总」。
延伸阅读
常见问题
- 没有 SPSS 软件,sav 文件用什么打开?
- 在 SPSSAI 网页上传 .sav 文件即可,无需安装软件。.sav 与 .zsav 用同一方式读取,.por 也直接支持;上传后在预览表格里核对数据,分析和查看结果不用登录。
- sav 文件里的缺失值上传后会变成什么?
- 在 SPSS 中定义为缺失的取值会读成空白,不会当作 0 或 99 参与计算。多元方法默认按整行剔除,报告里会写明原始记录数与有效样本量。
- sav 文件的变量标签和取值标签上传后还在吗?
- 列名始终保持文件里的原始变量名。取值标签只对 SPSS 里测量级别标成名义的列转成文字,有序、尺度或没有标注级别的列保留编码数字,.dta 文件的列也都保留编码。上传后页面最多弹出四条提示,按文件内容而定,会说明哪些列被转换、保留编码的列各自的值标签和每个变量的标签。