SPSS 卡方拟合优度检验怎么做:实际分布与期望分布比较
更新于
卡方拟合优度检验怎么做,先把每位对象记录为一个类别,再预先明确期望比例,最后检查期望频数并读取整体检验。本篇的均等比例仅用于演示,不是血型在人群中的真实比例假设。
数据要怎么排
本篇使用卡方拟合优度检验演示数据(模拟生成),全部300行进入分析。每行是一位对象的血型,类别为A型、O型、B型和AB型;同一个体无法重复进入样本,也不应把汇总人数误当作新增对象。这里回答单一分类变量是否偏离指定分布,与两个分类变量是否关联的列联表问题不同。
| 数据项目 | 本篇安排 | 需要核对 |
|---|---|---|
| 血型分布 | 每人一个类别 | 分类互斥且覆盖资料 |
| 期望分布 | 均等比例 | 是否符合研究假设 |
| 计数单位 | 独立对象 | 无法重复计人 |
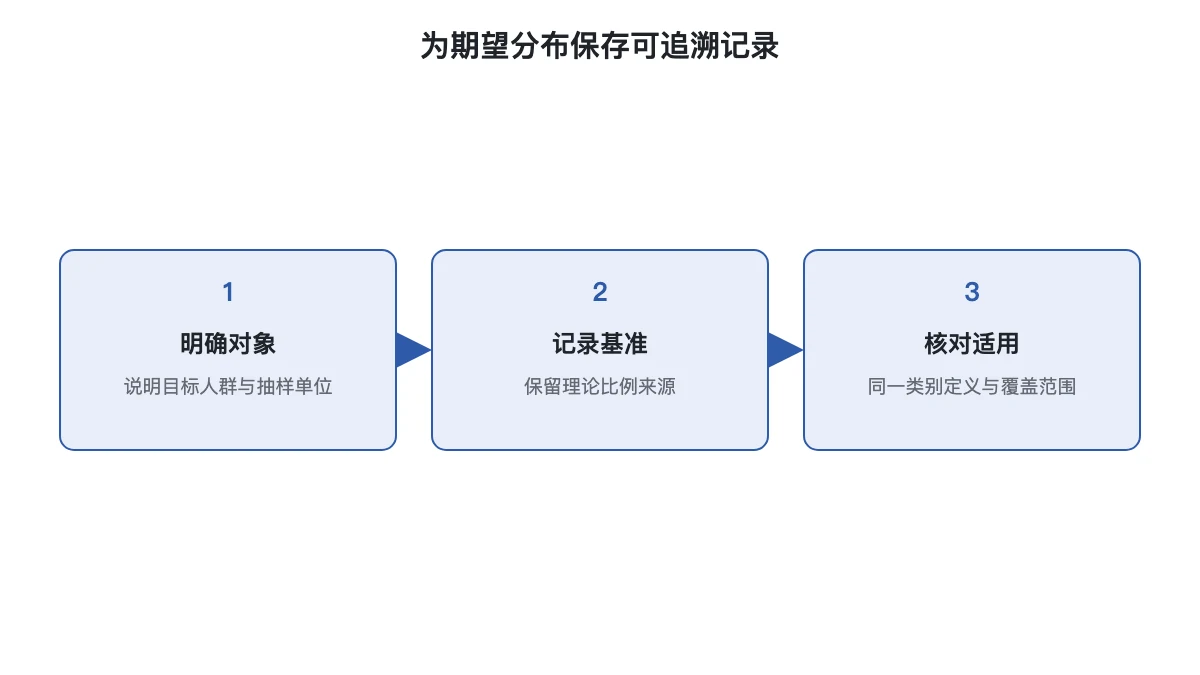
期望频数由有效总例数与设定比例共同决定,不是从每个类别自己的实际频数复制而来。如果把观测比例直接作为期望比例,再检验它与自身是否相同,问题就失去了原本意义。正式研究若引用外部人群分布,应说明来源和适用人群,本篇不提供可移用于真实血型研究的基准。
卡方拟合优度检验怎么做
- 选择「卡方拟合优度检验」,放入血型分布列,核对当前期望分布为均等比例,确认这与本次演示目的相符。
- 开始分析后检查有效人数、类别及期望频数表;先判断卡方近似条件,再读统计显著性。
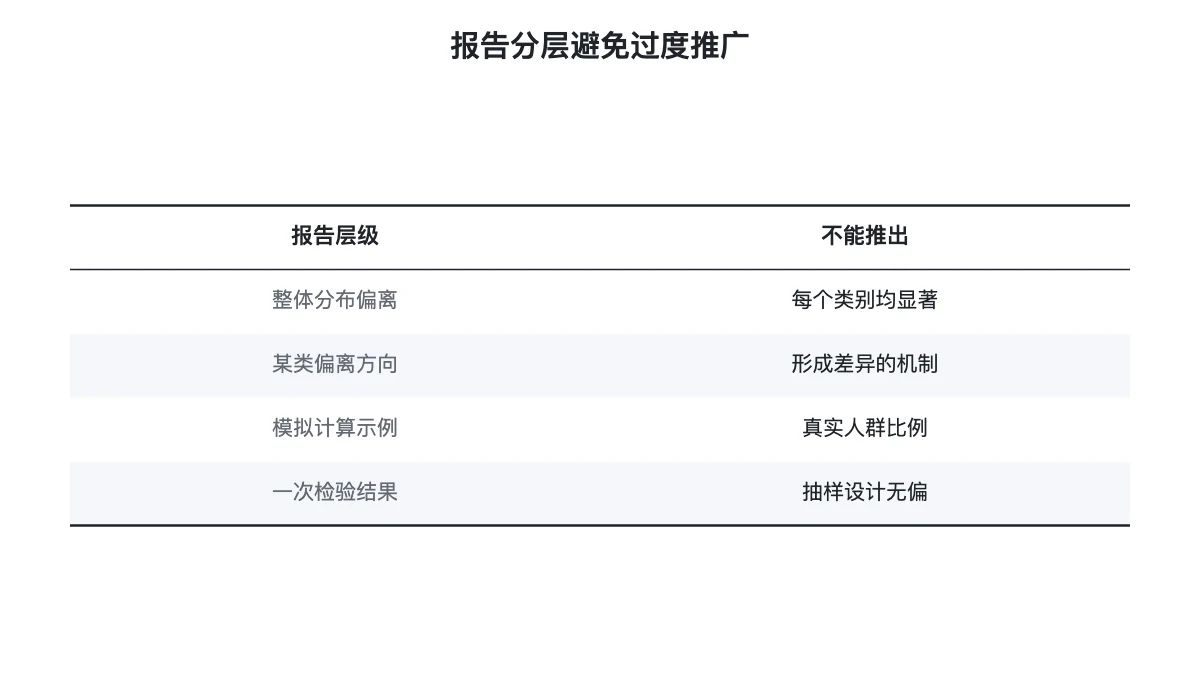
- 阅读整体结果、偏离规模和逐类别校正结果,分别记录它们回答的问题,不把某一类别的偏差归为所有类别。
期望频数条件与观察对象独立性需要分开核对:前者在表中有数值证据,后者依赖收集设计,无法从软件运行成功推断成立。若存在同一对象的重复分类,应先确认配对结构,而不是继续按独立计数解释结果。
实际分布与期望分布怎么看
本篇各类别期望频数均为75,卡方近似的期望频数条件满足。Pearson整体检验为χ²(3)=32.267,p<0.001,提示实际类别分布偏离此处设定的均等比例;这不意味着样本偏离某个真实人口总体,因为本次没有使用那样的理论基准。
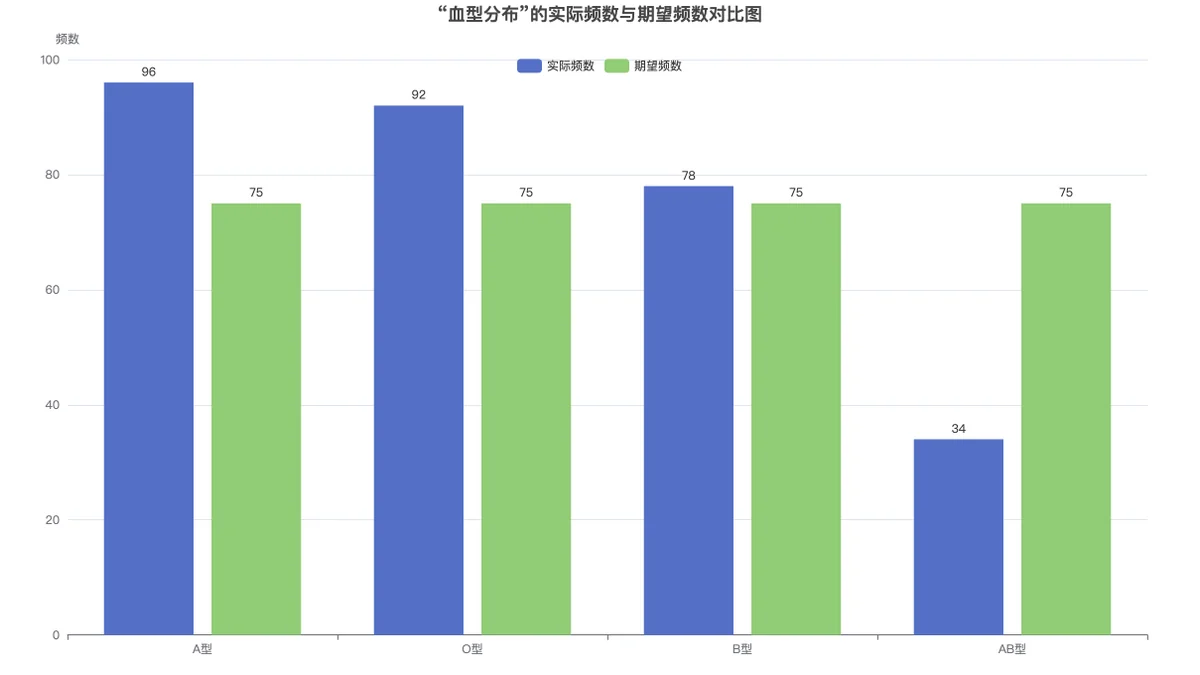
拟合度对比图用于观察偏差方向:实际柱高于期望柱表示高于理论预期,反之表示低于预期。图中高低无法直接等同于逐类别显著性,仍需结合标准化残差及校正后概率。报告显示,Bonferroni校正后A型与AB型的偏离达到显著水平,其余类别无法照整体结果一并写成显著。
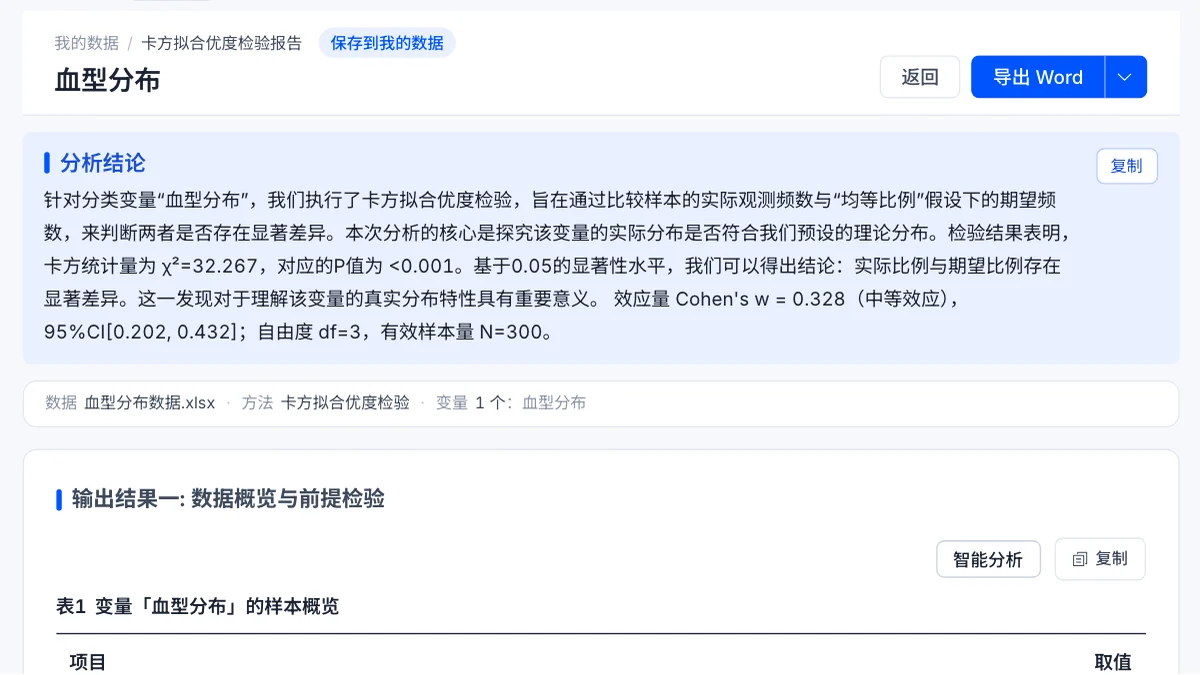
首屏摘要帮助核对方法与资料,详细判断仍要回到对应表格。本例Cohen’s w为0.328,描述相对于设定理论分布的整体偏离规模;它不是某个血型的患病风险,也无法说明形成分布差异的机制。模拟例子的统计显著性只说明计算路径,无法代入实际流行病学结论。
论文里怎么写
可以写:“以均等比例作为演示基准,采用卡方拟合优度检验比较血型类别的观察分布与期望分布,整体检验提示存在偏离;逐类别分析采用Bonferroni校正,A型与AB型达到显著水平。”真实论文还要报告类别频数、基准来源和效应量,并保留未检出与无法估计的情况,无法只留下显著类别。
类别标签也会影响统计问题的定义。若同一类别在资料中有多个拼写,应先依据真实含义整理,避免人为增加类别;若某个类别确实没有观测,也无法因为不方便就从理论分布删除。正式分析应保留完整类别定义及期望比例记录,说明是否存在不覆盖的分类。任何合并都要有内容依据,而不是观察残差之后为了改变结果再重新划分。
拟合优度检验常见错误
- 把均等比例当成人口规律 → 用研究问题支持的理论分布,并交代来源。
- 用整体p给每类标星号 → 分别引用逐类别校正结果。
- 把残差绝对值当作各类可直接比较的检验量 → 核对标准化残差与期望频数。
- 把不显著写成完全拟合 → 说明当前未检出偏离,并讨论估计精度与设计能力。
完成核对后,结论应能追溯到一套固定期望比例和同一次有效样本。若事后改变理论分布,应解释分析目的的变化,而不是把新结果接到原来的假设后面。开通会员后可导出 Word / PDF 报告、使用 AI 解读。
延伸阅读
常见问题
- 拟合优度检验的期望比例能事后改吗?
- 不应为获得某个结论而修改。理论分布应有研究依据,若由同一资料估计,还须核对自由度与适用方法。
- 整体显著就表示每类都不同吗?
- 无法。整体检验说明至少有一类偏离,具体类别需查看单独比较及多重性校正。
- 不显著能说明符合理论分布吗?
- 只能说当前证据未检出偏离,无法证明分布完全相同,也无法据此忽略检验能力。