
SPSS 多选题数据分析方法:响应率与个案百分比
更新于
多选题数据分析方法的核心,是先分清两种比率:按人数算的个案百分比(本站叫普及率),和按勾选人次算的响应率。两者分母不同,混用是多选题报告里最常见的错误。下面用 200 份演示问卷,说明数据怎么排、两种比率怎么读、检验用什么。
数据要怎么排
多选题的数据形态是硬要求:每个选项单独一列,取值只能是 0(未选)和 1(已选),一行是一位受访者。至少要有 2 个选项列。方法说明见多选分析。
| 列名 | 取值 | 放进哪个区 |
|---|---|---|
| 购买考虑-物流迅速、品牌知名、售后完善 | 0 或 1 | 放入多选题的各选项列 |
| 购买考虑-外观时尚、品质可靠、另一项 | 0 或 1 | 放入多选题的各选项列 |
如果原始数据是「A,B」这样的文本堆在一格,应先整理为彼此独立的 0/1 选项列,再核对各列含义。缺失单元格按「未选」记 0,所以要先确认数据里的 0 是看了没勾,而不是没答这道题。
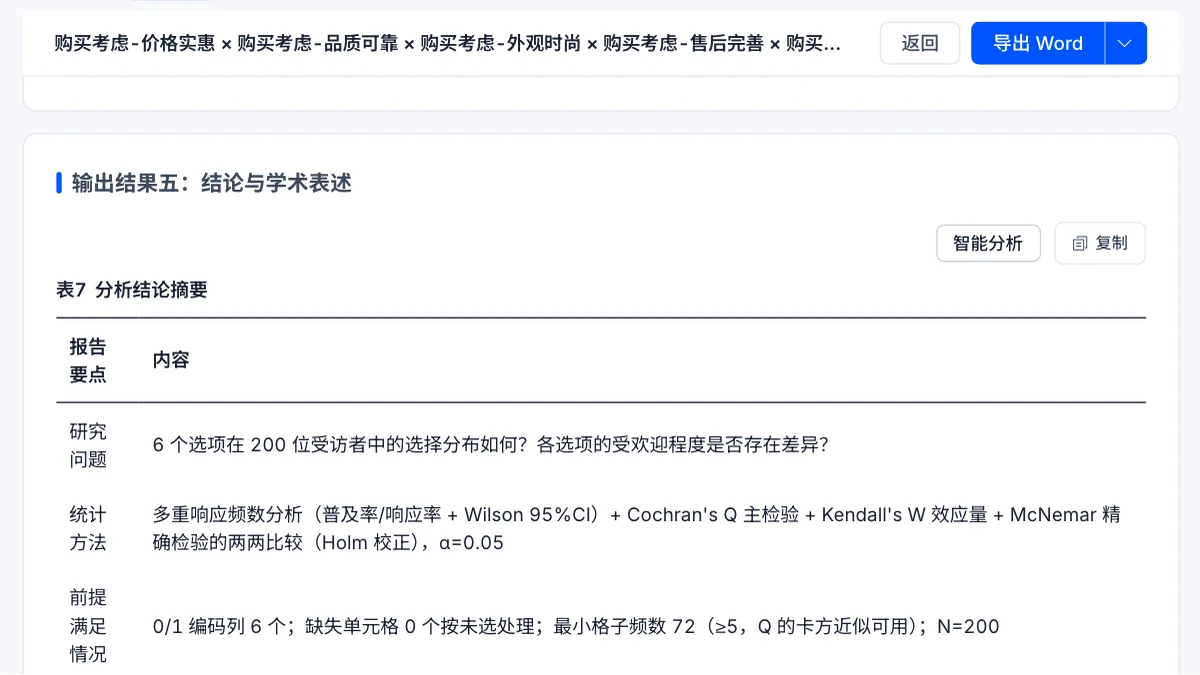
以下结果来自本站演示数据(模拟生成,不代表真实研究结论):200 位受访者,6 个选项,总勾选 643 人次。本篇使用完整演示表,各选项列属于同一批答题者。
多选题数据分析方法:三步
- 在方法列表里选「多选分析」,把 6 个 0/1 选项列拖进「放入多选题的各选项列」区。
- 先看第一张卡:样本量、总勾选人次、人均选择数、覆盖率。
- 再读各选项的普及率与响应率,最后看主检验。开通会员后可导出 Word / PDF 报告、使用 AI 解读。
个案百分比与响应率怎么读
概览表显示:200 人共勾选 643 人次,平均每人选 3.215 项(标准差 1.399);195 人至少选了 1 项,覆盖率 97.50%;5 人一项没选,12 人全选。这些指标描述作答覆盖与勾选数量,整题未答与有意全不选仍需用研究记录区分。
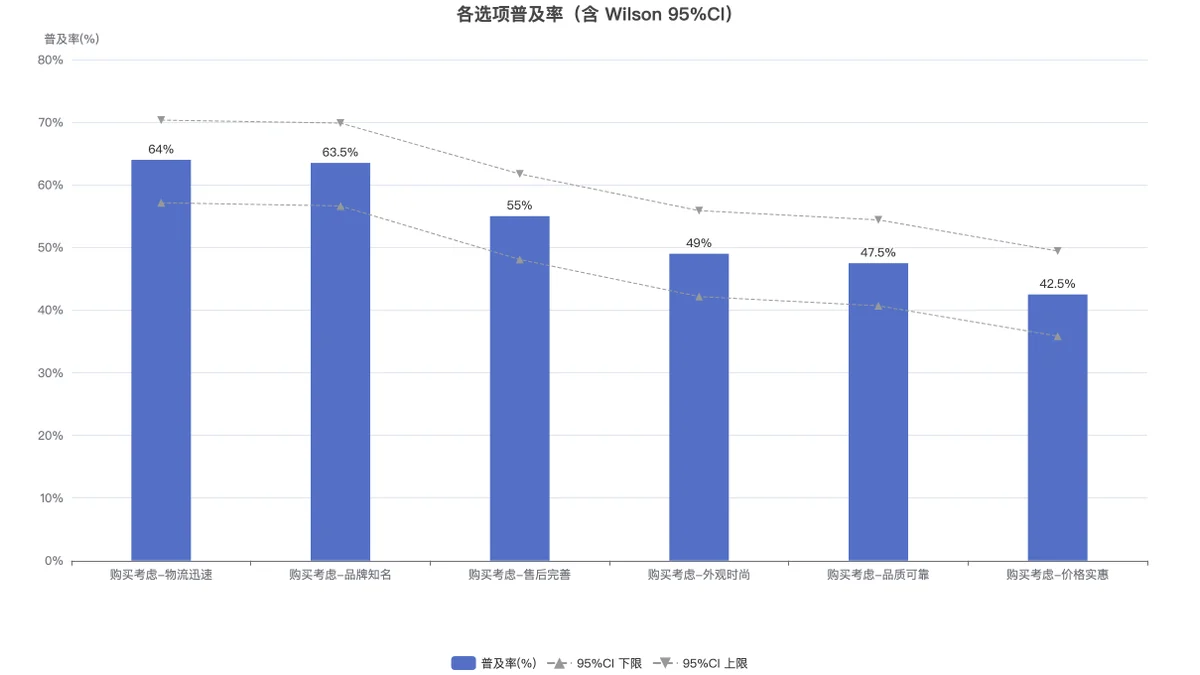
同一个选项有两个比率,以物流迅速为例,它被 128 人选中:普及率 64.00%(95% 区间 [57.14, 70.33]),响应率 19.91%。两列只是使用了不同分母,不代表同一选项得到了两种互相矛盾的评价。
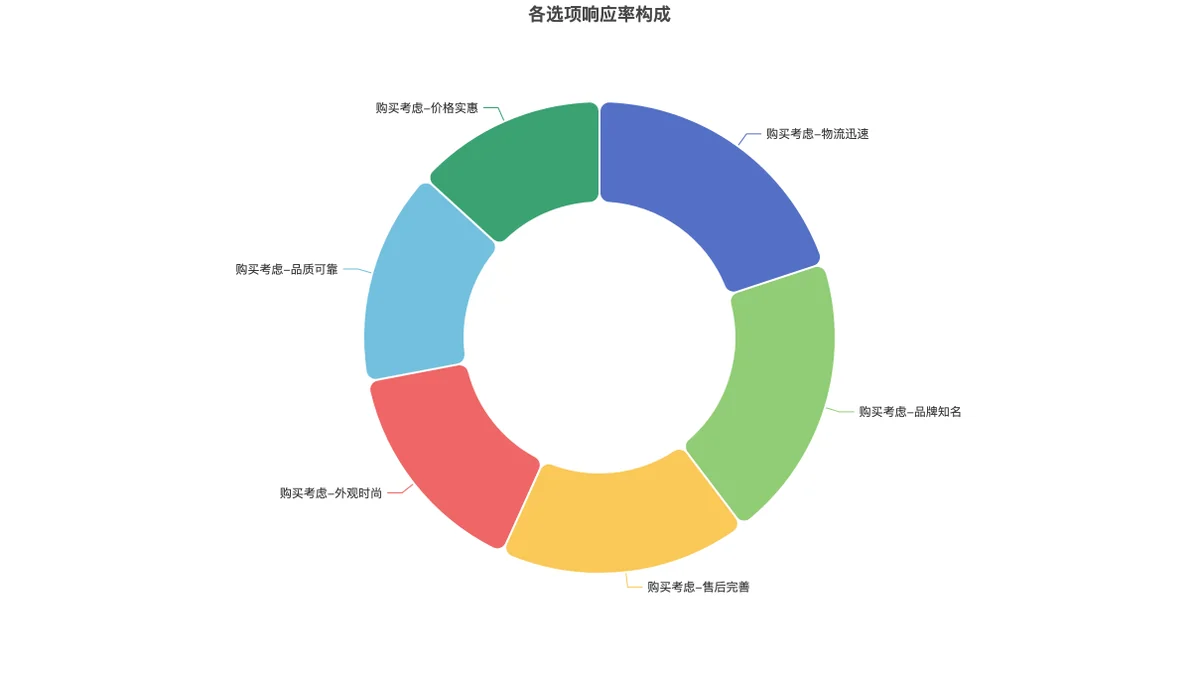
前者回答「200 人里有多少人选了它」,后者回答「它占全部勾选的多少」。普及率各项之和为 321.5%,即人均 3.215 项换算成百分数;响应率各项之和恰好等于全部勾选。写结论时要写清用的是哪一个口径。
环形图使用勾选人次构成作为分母,各部分合在一起才是全部响应。它描述的是回答分配,读面积时应保留人次口径。
普及率从高到低依次是:物流迅速 64.00%、品牌知名 63.50%、售后完善 55.00%、外观时尚 49.00%、品质可靠 47.50%,最低的第 6 项为 42.50%。最高与最低相差 21.50 个百分点,两者的区间不重叠。
主检验:为什么是 Cochran's Q
同一位受访者在所有选项上都作了答,各选项是相关样本,应保留同一人的配对关系。报告的主检验是 Cochran's Q:Q(5)=33.380,p<0.0001,原假设是各选项被选的概率相等,结论是被选概率存在显著差异。
报告并列的拟合优度结果把勾选人次当作独立计数,与当前重复选择的设计不同。本文依据相关样本的主检验,不把另一个检验的显著性合并为两份独立证据。
效应量用 Kendall's W,本例为 0.0334,说明 Q 虽然显著,各选项受欢迎程度的整体差距并不悬殊。配合 21.50 个百分点的普及率极差来读,比只看 p 值可靠。
两两比较:原始显著和校正结论为何不同
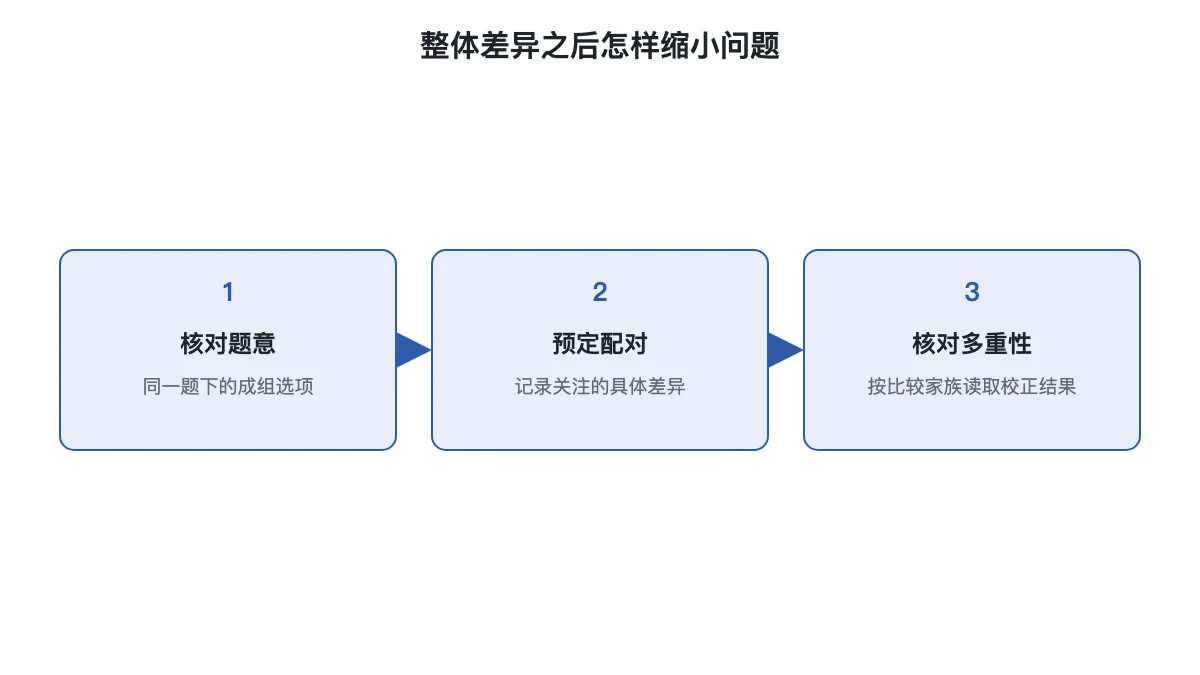
整体 Q 检验没有指出具体哪两项不同,本次报告另外形成了十五个配对。以最低普及率的第六项与售后完善为例,McNemar 原始 p=0.0176,但 Holm 校正后 p=0.1585;若按预定显著性水平判断,应保留校正后未检出差异的结论。
这组结果让“整体存在差异”与“每一对都不同”的区别可以直接核对。整体拒绝只要求某些选项的概率不同,某个配对在校正后没有足够证据,并不与整体检验矛盾;也不宜只在看完结果后挑出原始显著的一对,把其余比较从报告中隐去。
配对结果还包含 φ 相关,它回答共同选择的方向,与 McNemar 对两选项选择概率差异的检验不同。记录配对问题时,先写清关心的是“同时出现”还是“选择率不同”,再引用对应列;本次结果没有将相关大小当成选项重要性的排序。
论文里怎么写
200 名受访者的人均选择 3.22 项,覆盖率为 97.50%。物流迅速的普及率最高(64.00%,95%CI [57.14, 70.33]),响应率为 19.91%。Cochran's Q 检验显示各选项被选概率差异显著,Q(5)=33.380,p<0.0001,Kendall's W=0.0334。
多选题结果核对中的具体错误
- 把第六项与售后完善的原始显著写进摘要:先核对它属于本次配对家族,再用报告中的 Holm 列确定结论。
- 用整体 Q 的显著覆盖每个配对:逐对保留检验对象与校正口径,允许整体与具体配对给出不同层面的结论。
- 把 φ 大小写成哪项更重要:回到选择概率差异,分别说明共同选择关系与回答构成。
- 将覆盖率理解为完成整份问卷的比例:本报告覆盖的是此题至少勾选一个选项,问卷完整性需要另外核对。
延伸阅读
常见问题
- 多选题的响应率和个案百分比有什么区别?
- 分母不同。个案百分比(报告里叫普及率)以人数为分母,各选项之和可超过总人数;响应率以总勾选人次为分母,各选项之和恰好等于全部勾选。本例物流迅速的普及率是 64.00%,响应率是 19.91%。
- 多选题数据要怎么排?
- 每个选项单独一列,取值只能是 0(未选)和 1(已选)。选项文本堆在一列的格式,本模块接收的是各选项列;应先整理成可核对的 0/1 编码再配置。
- 多选题可以直接做卡方检验吗?
- 不适合。同一位受访者会贡献多次勾选,观测不独立。本例全部勾选只来自 195 位受访者,报告用相关样本的 Cochran's Q 做主检验。