SPSS kmeans聚类结果怎么看:聚类中心与方差分析表
更新于
kmeans聚类结果先看各簇规模,再读标准化与原始尺度的聚类中心,最后结合质量和稳定性指标判断划分的局限。聚类后的方差分析表描述参与变量在这些簇间的差异,其显著性并非簇客观存在的独立证据。
聚类数据怎么排:三列特征决定划分含义
以下结果来自本站演示数据(模拟生成,不代表真实研究结论):消费特征表随机抽取 144/180 行,种子为 111,指定分为 4 簇。方法说明见聚类分析(K-Means);演示记录用于讲解分群,无真实客户经营结论。
| 列名 | 类型 | 在本次聚类中的用途 |
|---|---|---|
| 年消费金额(千元) | 定量 | 消费规模特征 |
| 月均到店次数 | 定量 | 到店频次特征 |
| 客单价(元) | 定量 | 单次消费特征 |
三列都作为特征参与距离计算,数据一行对应一个样本。现成的会员等级与希望预测的结果应和聚类特征区分:本文并未依据已知类别训练分类模型,也未检验某个消费行为对另一指标的因果作用。
本站模块会对参与特征做 Z-score 标准化,再在该空间按欧氏距离聚类。标准化使不同单位可放到共同尺度,但特征的取舍仍会影响划分;如果同一业务维度被多列重复表达,它会通过多个坐标进入距离,解释结果时应交代选列依据。
kmeans聚类怎么做:参数与样本同时对齐
- 在数据分析中选择「聚类分析(K-Means)」,载入数据并把上述定量列作为聚类特征。核对实际记录数与列名,复现本文需使用同一随机子样本。
- 将聚类个数设为 4,再开始分析。报告按指定的簇数形成划分,同时提供簇数扫描作为参照;扫描参考与指定值不同也要保留并解释。
- 先读主结果卡里的中心和规模,再看可视化与质量卡。演示数据不用登录就能跑;用自己的数据分析、导出 Word / PDF 报告、使用 AI 解读需要开通会员。
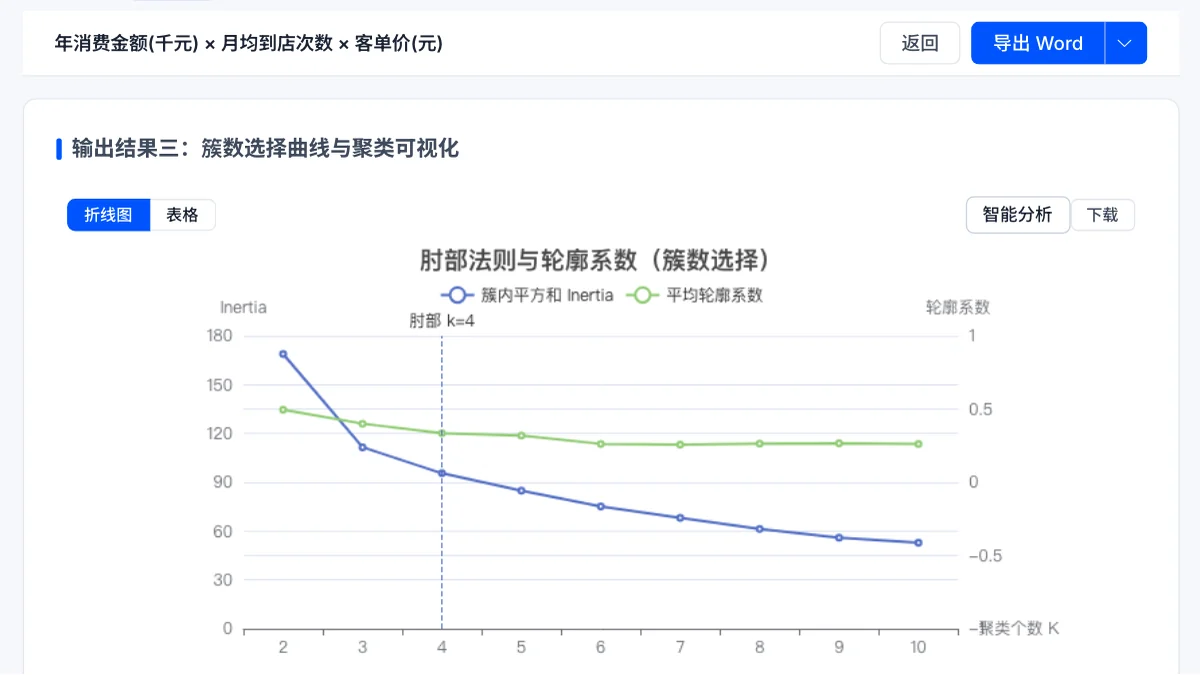
可视化卡的切换入口用于在图形和表格之间核对结果。下面截图保留本次报告的界面状态,帮助定位簇数选择图;精确读数仍应与结果表和图轴分别对应,避免把不同轴的数值直接比较。
聚类中心怎么看:两种尺度各回答一个问题
标准化中心适合比较某个簇相对本次总体的特征。本例 cluster_2 的年消费、到店频次、客单价中心分别为 1.183、1.117、1.059,都高于总体平均;cluster_1 对应为 -1.295、-1.171、-1.034,都低于平均。正负号描述的是相对位置,并非优劣评级。
原始尺度中心则便于说明实际量级。例如月均到店次数在 cluster_1 为 4.222,在 cluster_2 为 7.826。两簇分别有 32 与 46 个样本;一个簇的中心描述该簇的平均特征,并不意味着每位成员都恰好等于中心。
同一变量在各簇的中心可以横向比较,单位不同的变量则适合回到标准化表比较。给簇命名时,应保留“本样本、所选特征与指定簇数”的条件,避免把模拟资料里的相对位置推广为普遍客户类别。
聚类结果解读:簇数曲线与散点图怎么配合
本次肘部参考指向 4 簇,而轮廓系数扫描的较佳值出现在 2 簇,两种依据未给出相同答案。肘部依据目标函数下降的转折,轮廓系数兼顾簇内紧凑和簇间分离;指定更多簇可能增加画像细节,也可能切开原本较连贯的人群。
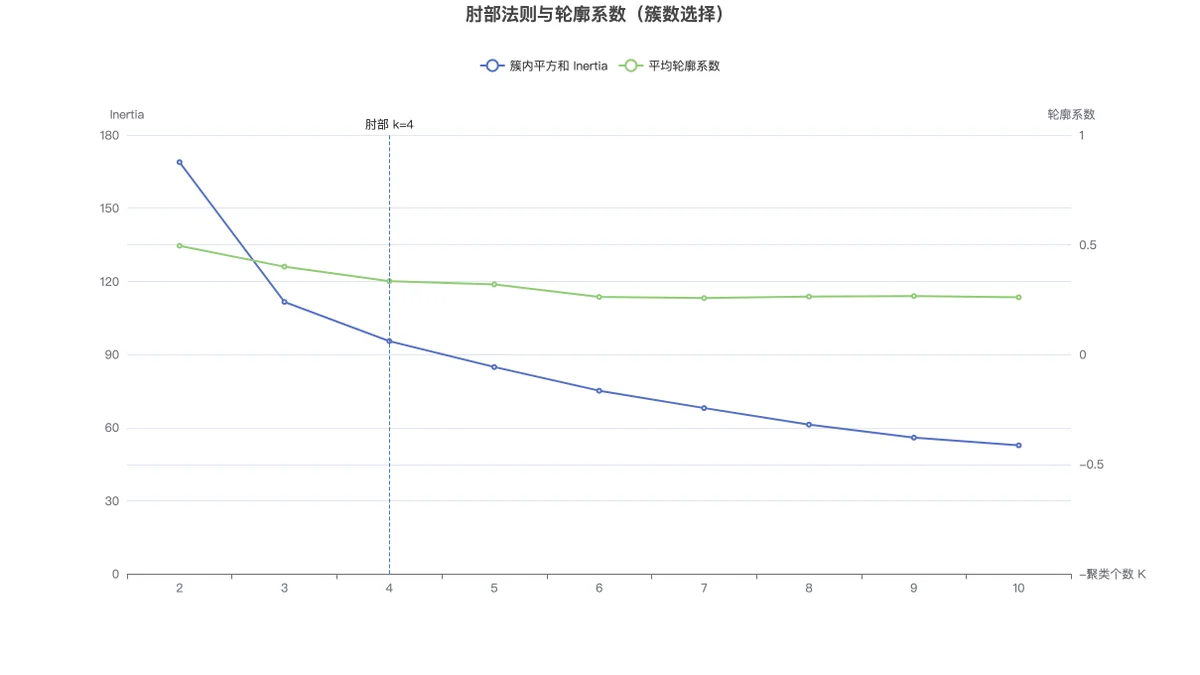
指定划分的平均轮廓系数为 0.3341。报告将其描述为结构尚可,应结合散点分布理解这一有限区分度;PCA 散点图是将参与聚类的空间投影到平面,并非算法只使用了横纵轴这两个变量。
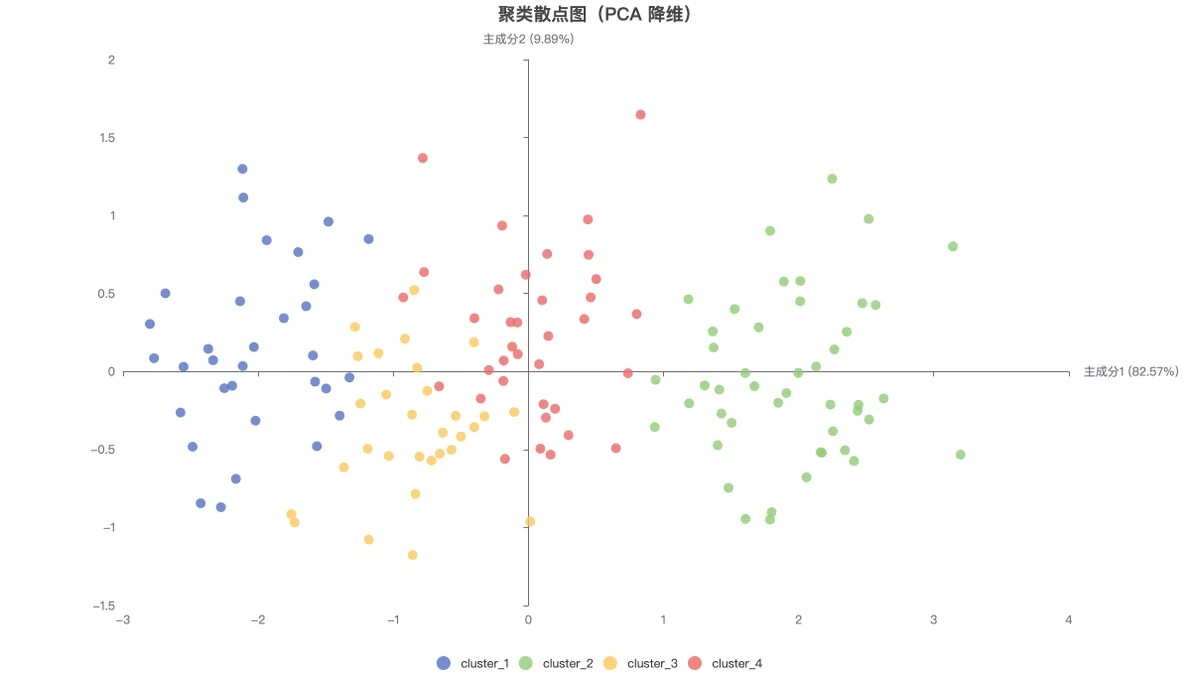
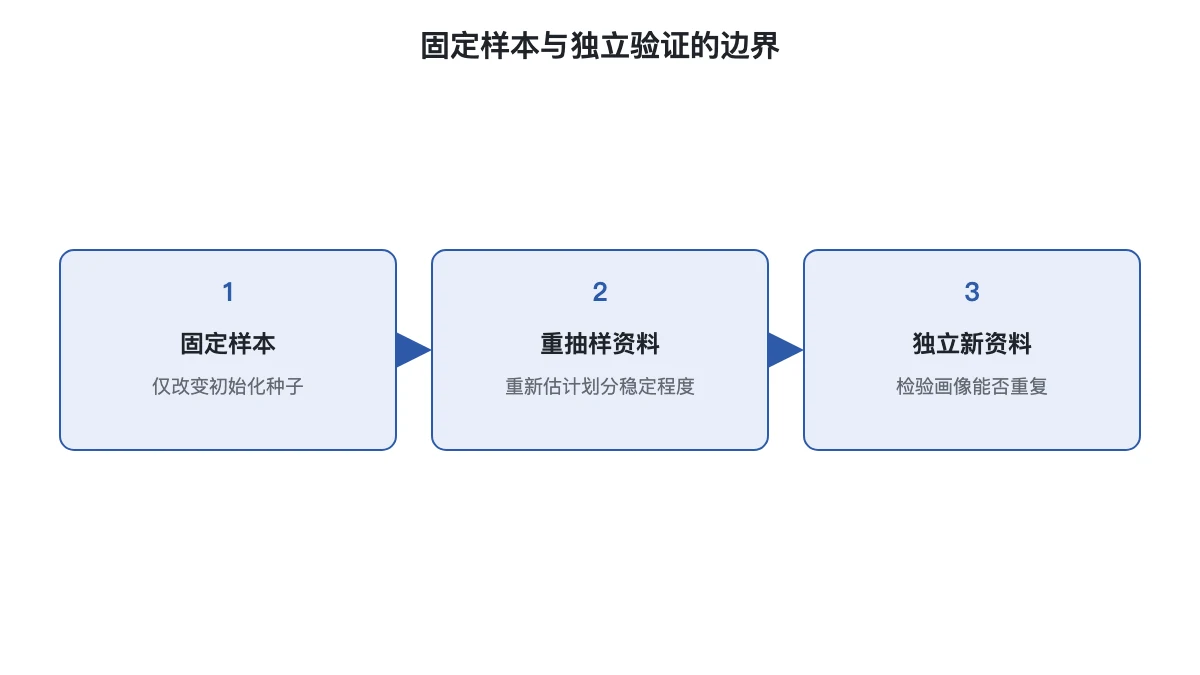
不同颜色在平面上有分离也有相邻区域,投影后的重叠与完整特征空间中的距离各有含义。报告更换初始化种子后的平均 ARI 为 0.8900,描述本批数据上算法划分的一致程度;它没有更换研究样本,因而尚未回答新资料能否重复这些群体。
方差分析表怎么看:组间差异只是事后描述
年消费金额的簇间 F=241.007,p<0.001,η²=0.8378。由于年消费金额已参与构造簇别,这项结果可用于呈现当前划分中的区分特征,而非证明存在真实人群分类;也不适合据此写成类别导致消费变化。
下面示意图梳理验证资料的来源边界,帮助区分“算法重复运行”与“换资料验证”。报告给出的初始化扰动属于前者,研究设计若要谈推广,应另行准备验证资料,并预先规定判据。
聚类结果在论文里怎么写
对模拟消费特征的随机子样本进行 Z-score 标准化后,以欧氏距离运行 K-Means,指定形成四簇。报告同时呈现标准化中心、原始尺度中心与各簇人数;簇数依据存在差异,保留指定划分作为探索性画像。簇间方差分析仅描述本次分群特征,初始化扰动检验也仅评估固定样本上的算法稳定性,尚需外部资料检验可重复性。
聚类中心解读常见错误
- 把标准化中心当作业务原值:回查表头的尺度,业务量级引用还原后的中心。
- 把类别编号当成排序:按特征命名并注明条件,避免编号承担价值判断。
- 只因事后检验显著就确认簇存在:补充质量与验证资料,保留探索性解释。
- 把初始化 ARI 当成跨样本验证:写明每次运行保持的数据和改变的参数。
延伸阅读
常见问题
- kmeans聚类的编号越大代表价值越高吗?
- 编号只是本次划分的标签,没有高低顺序。应按各簇的实际中心描述特征,重新运行后即使编号改变,也要比较成员与中心,避免只凭编号对照。
- 聚类中心为什么有负数?
- 标准化尺度的负值表示低于此次样本的总体平均,而非原始业务数值为负。需要业务解释时,结合还原到原始量纲的中心表,并保留原始单位。
- 聚类后的方差分析显著能确认分群有效吗?
- 这些变量本身参与了分群,随后得到的组间检验不属于独立验证。应将其作为本次划分的描述,补充内部质量、初始化稳定性和外部资料验证。