SPSS 列联表卡方检验怎么做:交叉表与行列百分比
更新于
列联表卡方检验怎么做:把一个分类变量放进行变量区,把要交叉的分类变量放进列变量区,报告会给出交叉表、卡方检验、效应量和逐格残差。以下结果来自本站演示数据(模拟生成,不代表真实研究结论):300 行里随机抽取 255 行(85%),看吸烟状况与疾病严重程度是否有关联。
数据要怎么排
两列分类数据,255 行没有缺失:吸烟状况(不吸烟 137 人,吸烟 118 人),疾病严重程度(轻度、中度、重度)。吸烟状况放进「行变量(分类字段)」区,疾病严重程度放进「列变量(可多选)」区,各区的要求见列联(交叉)分析帮助文章。
| 角色 | 变量 | 放入区域 |
|---|---|---|
| 行变量 | 吸烟状况 | 行变量(分类字段) |
| 列变量 | 疾病严重程度 | 列变量(可多选) |
列联表卡方检验的操作步骤
- 在方法列表里点开「列联(交叉)分析」。
- 把吸烟状况拖入「行变量(分类字段)」区,疾病严重程度拖入「列变量(可多选)」区。
- 点击开始分析,前提体检在第一张卡,交叉表和卡方检验在第二张卡。
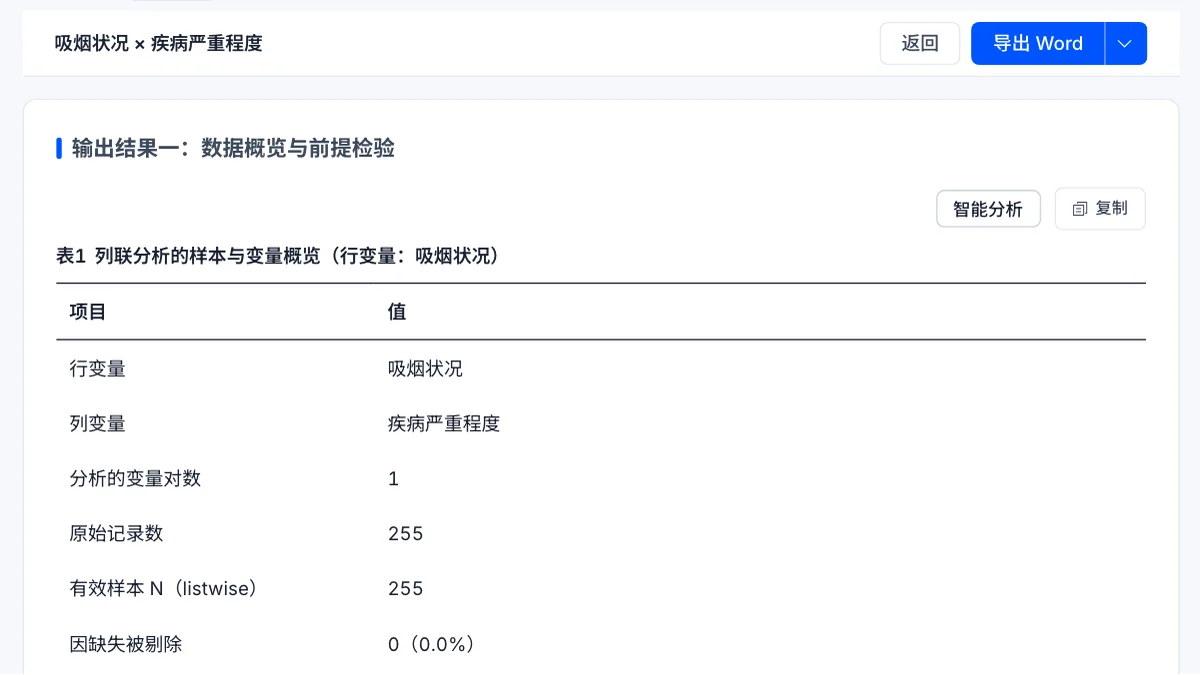
下图是第一张卡的表 1,列出行变量、列变量、变量对数、原始记录数、有效样本和因缺失剔除的条数。往下滚动,同一张卡里还有类别结构和卡方适用前提,先确认卡方近似条件是否满足再读后面的结果。
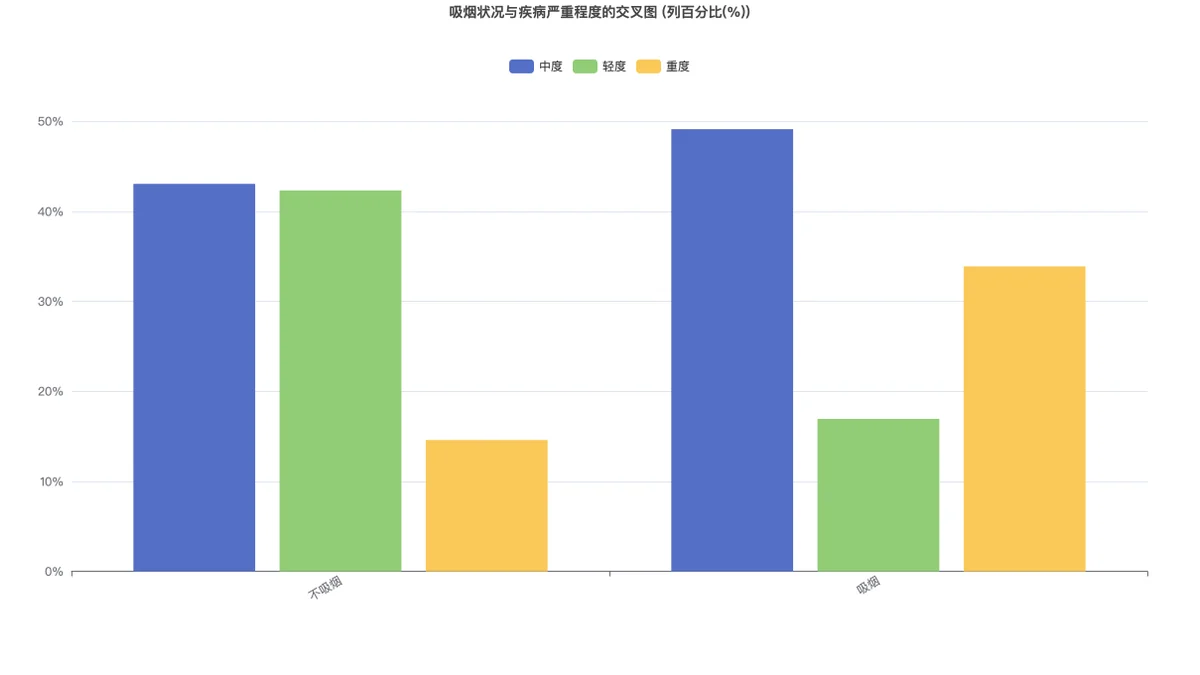
spss交叉表怎么读:列百分比与行百分比
交叉表是转置显示的:吸烟状况是行变量,它的两个类别却排在表头成了两列;疾病严重程度是列变量,三个类别竖着排成三行。每个格子写频数和括号里的百分比。
| 疾病严重程度 | 不吸烟 | 吸烟 | 总计 |
|---|---|---|---|
| 中度 | 59(43.07%) | 58(49.15%) | 117(45.88%) |
| 轻度 | 58(42.34%) | 20(16.95%) | 78(30.59%) |
| 重度 | 20(14.60%) | 40(33.90%) | 60(23.53%) |
| 总计 | 137 | 118 | 255 |
括号里是列百分比,分母是吸烟状况每个类别的人数:不吸烟的 137 人里,轻度占 42.34%。要看行百分比,也就是疾病严重程度每个类别里不吸烟与吸烟各占多少,在第三张卡图表上方的下拉框里把指标切换成行百分比,下拉框里还有频数可选。以重度一行为例:60 人里不吸烟 20 人、吸烟 40 人,行百分比就是这两个数各自除以 60,吸烟者占了三分之二。
卡方检验结果
第一张卡:2×3 表,最小期望频数 27.76,没有期望频数小于 5 的格子,满足近似条件。主结果表:Pearson χ²(2)=23.905,p<0.001,Holm 校正后同样小于 0.001;似然比 G²=24.713,结论一致。表里「精确检验 / 校正」一栏写的是「不适用(非 2×2 表)」,这个模块只对 2×2 表另给 Fisher 精确检验。
第四张卡给关联强度:Cramér's V=0.3062,95%CI [0.1957, 0.4168],报告判读为中等。下面的热力图是调整标准化残差,红色比独立假设下预期的多,蓝色比预期的少。
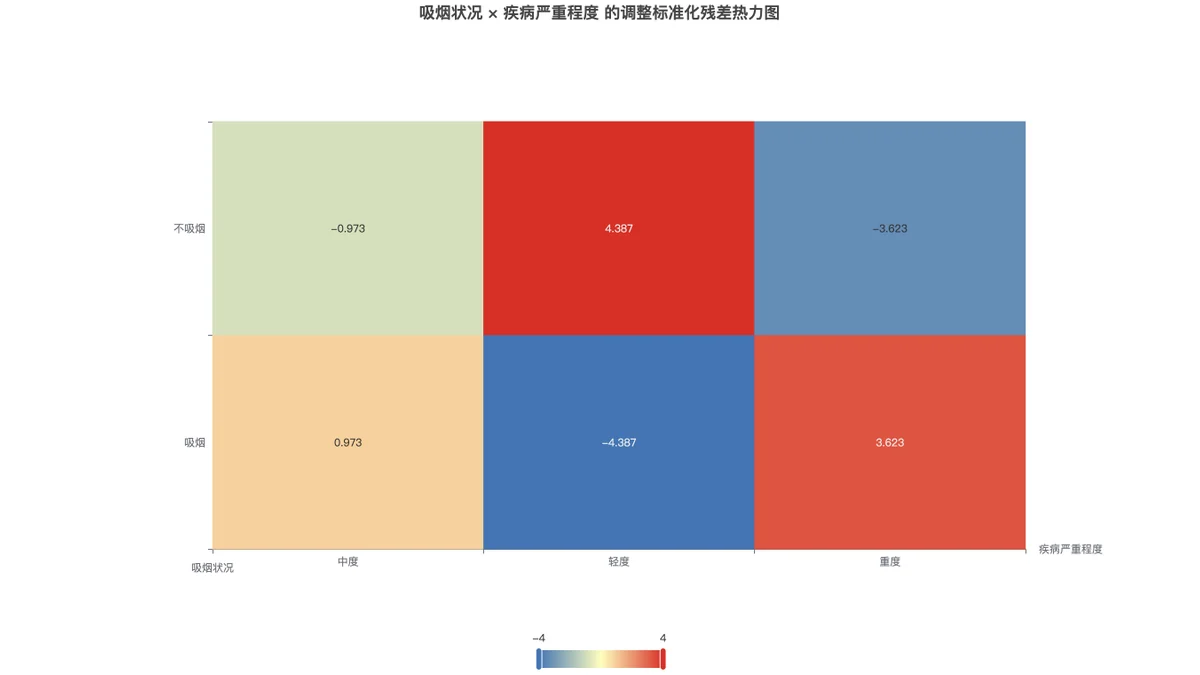
整体显著不告诉你是哪几格,逐格残差表给出了答案。表里每一行是一个格,残差的绝对值越大,偏离期望越远。
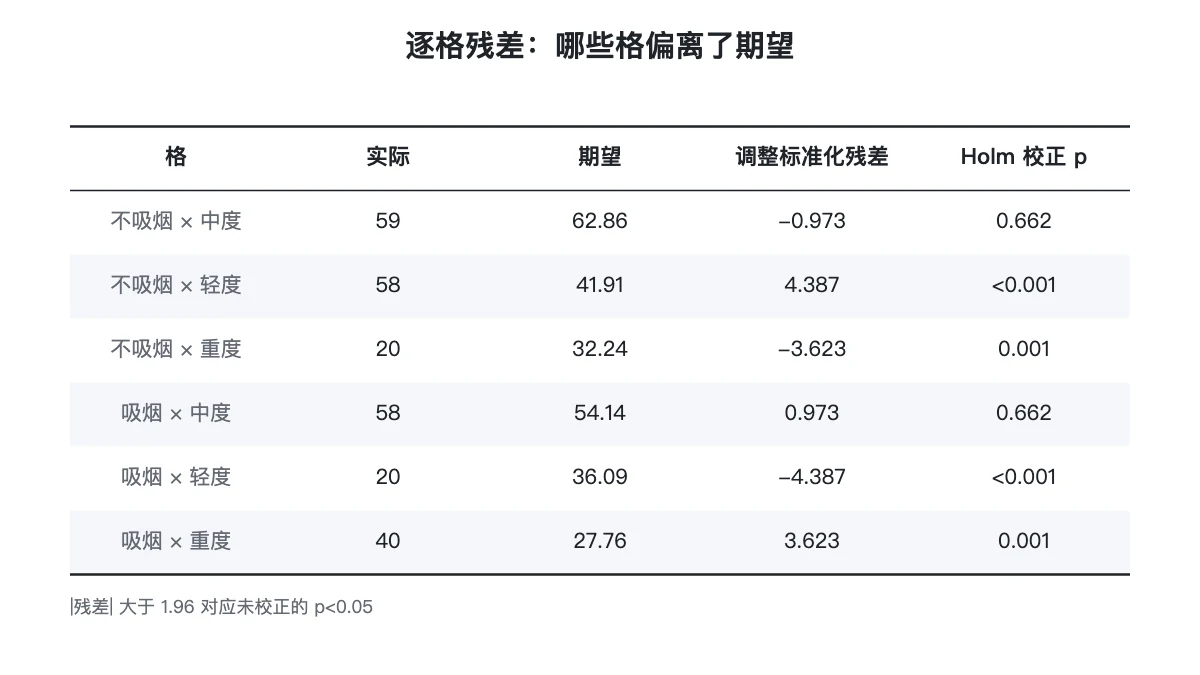
Holm 校正后,不吸烟者轻度显著偏多、重度显著偏少,吸烟者相反,中度两格与期望没有显著差异。读结果时,先看整体检验,再看效应量,最后才看逐格。
论文里怎么写
要点是写出列联表规模、样本量、χ²、自由度、精确 p、Cramér's V 与置信区间:
吸烟状况与疾病严重程度的列联表(2×3,N=255)卡方检验显示关联显著,χ²(2)=23.905,p<0.001,Cramér's V=0.3062,95%CI [0.1957, 0.4168]。逐格分析经 Holm 校正后,不吸烟者轻度偏多、重度偏少,吸烟者相反。
列联表卡方检验常见错误
- 把列百分比读成行百分比:「42.34%」是不吸烟者里轻度的占比,不是轻度患者里不吸烟的占比;后者要切到行百分比,轻度一行 78 人里不吸烟 58 人。
- 把列变量区当成随便放:想比较的分组变量放行变量区,被比较的类别变量放列变量区,放反了表就转置过来,读百分比时分母也跟着变。
- 只写 Cramér's V 的点估计:本例区间 [0.1957, 0.4168] 不窄,点估计 0.3062 只是中间的一个数,论文里连区间一起写。
- 以为缺一个值只丢一格:这里按整行剔除,任一变量缺失,这位被调查者就不进表;本例无缺失,255 行全部有效。
把结果带进论文:导出与会员
交叉表、统计量汇总表和逐格残差表导出后可以放进论文。SPSS 用户熟悉的交叉表,在这里就是第二张卡的交叉列联表。分析和查看结果不用登录;开通会员后可导出 Word / PDF 报告、使用 AI 解读。
延伸阅读
常见问题
- 列联表卡方检验怎么做?
- 在「列联(交叉)分析」里把一个分类变量放进行变量区,把要交叉的分类变量放进列变量区,点击开始分析。报告给出交叉列联表、卡方检验、效应量和逐格残差,不需要另外设置。
- 交叉表括号里的百分比是行百分比还是列百分比?
- 是列百分比,分母是行变量每个类别的人数,不是全表。本例 137 位不吸烟者里轻度 58 人,括号里就是 42.34%。想按疾病严重程度来读,在第三张卡的图表上方下拉框里切换成行百分比。
- 列联表卡方检验显著之后看什么?
- 看关联强度和逐格定位。强度看 Cramér's V 及其置信区间,本例点估计 0.3062,报告判读为中等;定位看调整标准化残差,Holm 校正后本例有四个格仍显著偏离期望。