SPSS 校准曲线怎么看:预测概率与实际概率的对照
更新于
校准曲线怎么看,关键是比较预测概率与同一批对象的实际事件频率,并同时检查分箱稳定性和校准回归。点靠近理想对角线是样本层面的图形表现,检验未显著则表示尚未检出系统失准,两者都需要结合误差大小与验证来源解释。
预测概率与实际概率怎样准备
本例使用完整的演示数据(模拟生成,不代表真实研究结论),共 300 行;每行是一位对象的预测和结局。预测值须在观察结局之前定义,事件的编码方向也应一致;如果把未发生事件当成正类,整张图的含义就会改变。方法入口及适用范围见校准曲线。
| 数据列 | 内容 | 分配位置 |
|---|---|---|
| 是否发生终点事件 | 已观察到的二分类结局 | 放入 [二分类] 结局变量 |
| 模型A预测概率 | 对正类事件的概率预测 | 放入 [定量] 预测概率 |
同一对象的预测与结局应保持同行,尤其是从建模工具导出概率后再合并随访表时,应按对象标识核对。为了区分模型记忆与可推广性能,研究记录还需说明这些概率来自训练集回代、交叉验证还是外部样本;导入概率本身并不会完成这个设计判断。
校准曲线怎么看:先复现分箱设置
- 选择「校准曲线」,按上表放置结局与预测列,核对正类事件定义。
- 保持「分箱数」为 10,与本例设置一致;开始分析后先看样本概览和期望频数检查。
- 将主结果中的斜率、截距与图形配合起来读,再看逐箱偏差,而非只摘一个 p 值。
本次有部分箱的期望事件或非事件数偏少,H-L 的卡方近似应谨慎使用。分箱数还决定每箱能积累多少事件;增加箱数能显示更细的局部差异,却会使每箱实测率更易波动,适当的取舍需要看本次数据的实际分布。
校准曲线与逐箱事件数分别说明什么
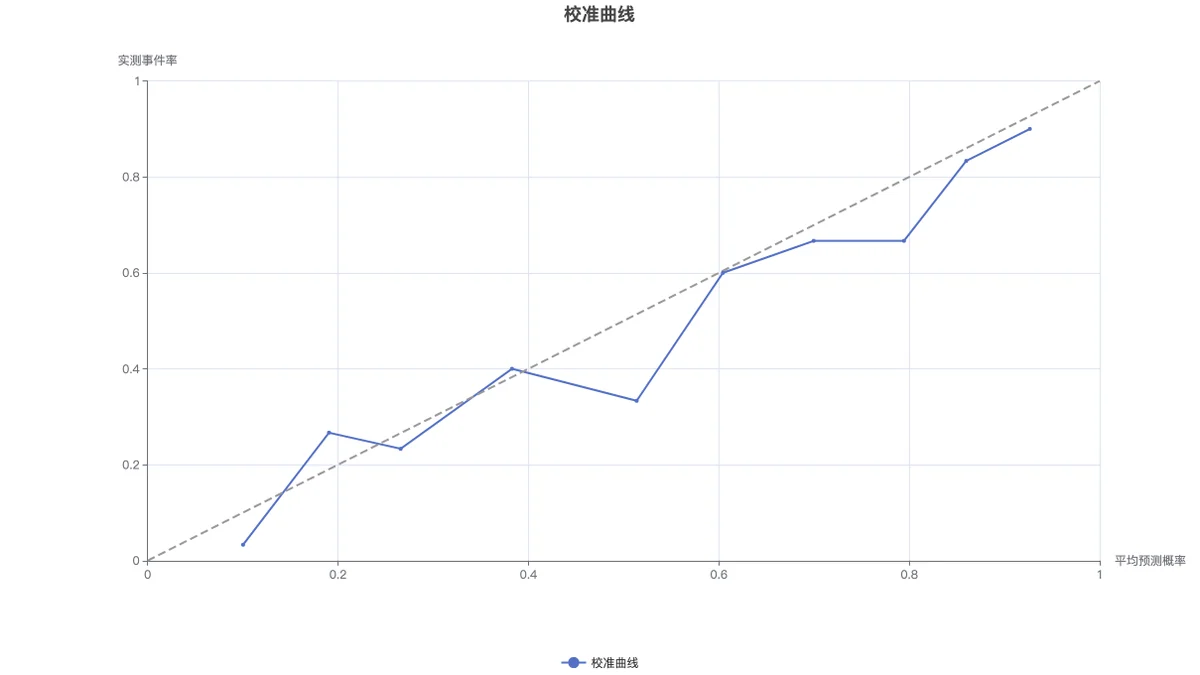
横轴是箱内平均预测概率,纵轴是该箱实测事件率。位于理想线下方的箱表示预测高于实测,位于上方则相反;这种方向判断针对箱均值,尚不足以断言每个个体都被高估或低估。图上局部上下交替,也不自动意味着模型存在稳定的非线性失准。
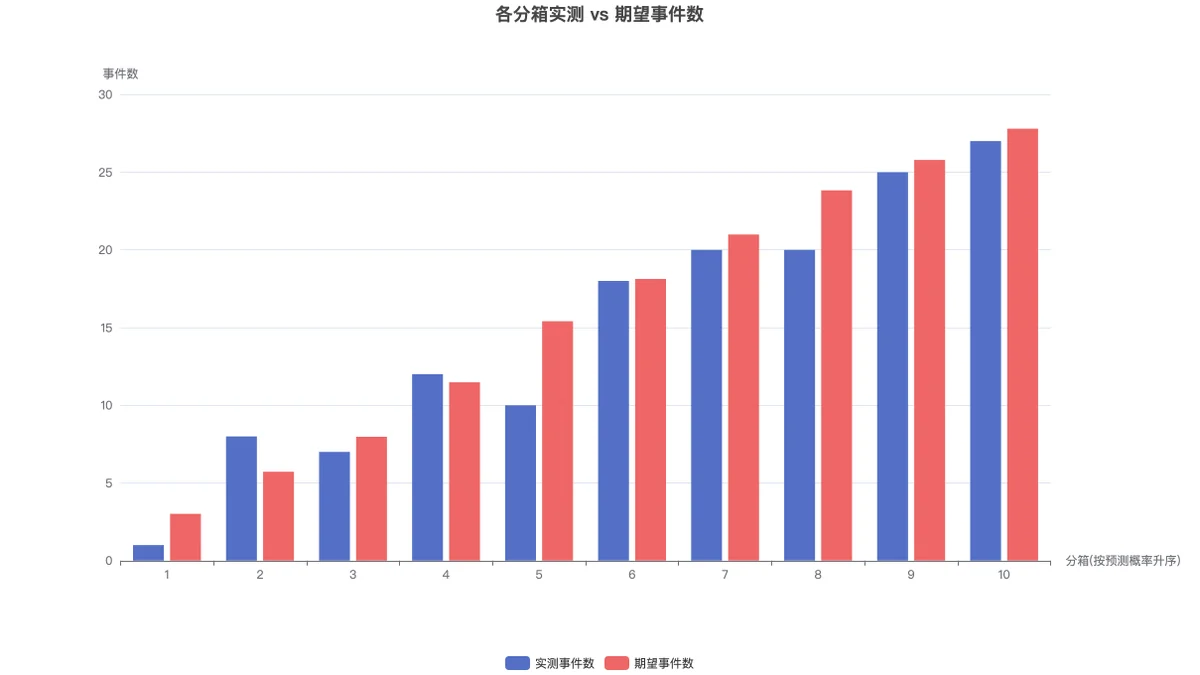
柱状图回到事件数尺度,帮助定位偏差来自哪些分箱。期望事件数是箱内预测概率的总和,实测数则从结局列计数,两者都依赖当前样本;低风险箱事件稀少时,少量个案就能明显改变箱内比率,应同时回看数据量。
本次 H-L 检验 p=0.2403,未检出整体失准;校准斜率为 0.915,区间为 [0.691, 1.139],包含理想值。Brier 为 0.1834,它汇总概率预测与结局之间的平方误差,同时受到区分能力与校准的影响,宜作为补充指标而非单独的校准证明。
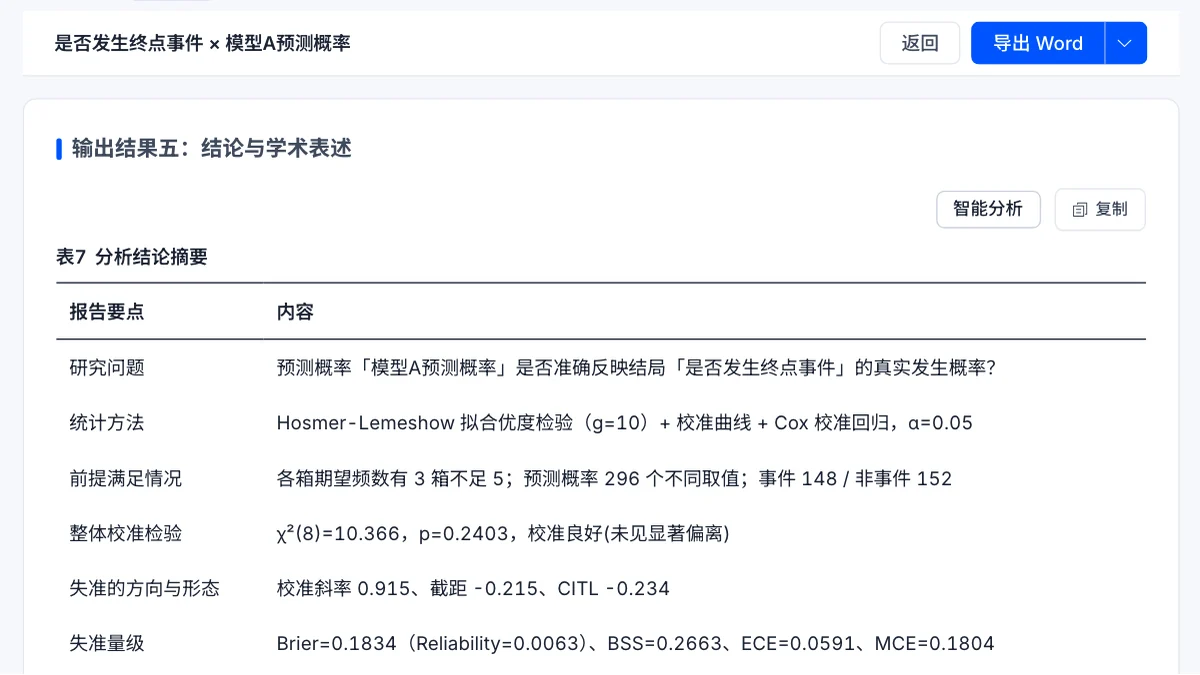
截图展示报告结论卡,使用时应与前面的频数前提和图形一起核对。自动摘要中的评价文字需要研究者结合区间与验证设计审视,尤其是近似条件受限时,正文更适合使用「未检出明显失准」这样的检验口径。
预测模型验证中保留校准度的不确定性
可写为:「采用分箱校准图及校准回归评估概率预测。H-L 检验未检出整体偏离;斜率区间覆盖理想值,但存在低期望频数箱,因此结合曲线及误差指标解释结果。」正式研究应补上实际样本的统计量,并说明是否在独立于建模的数据中完成评估。
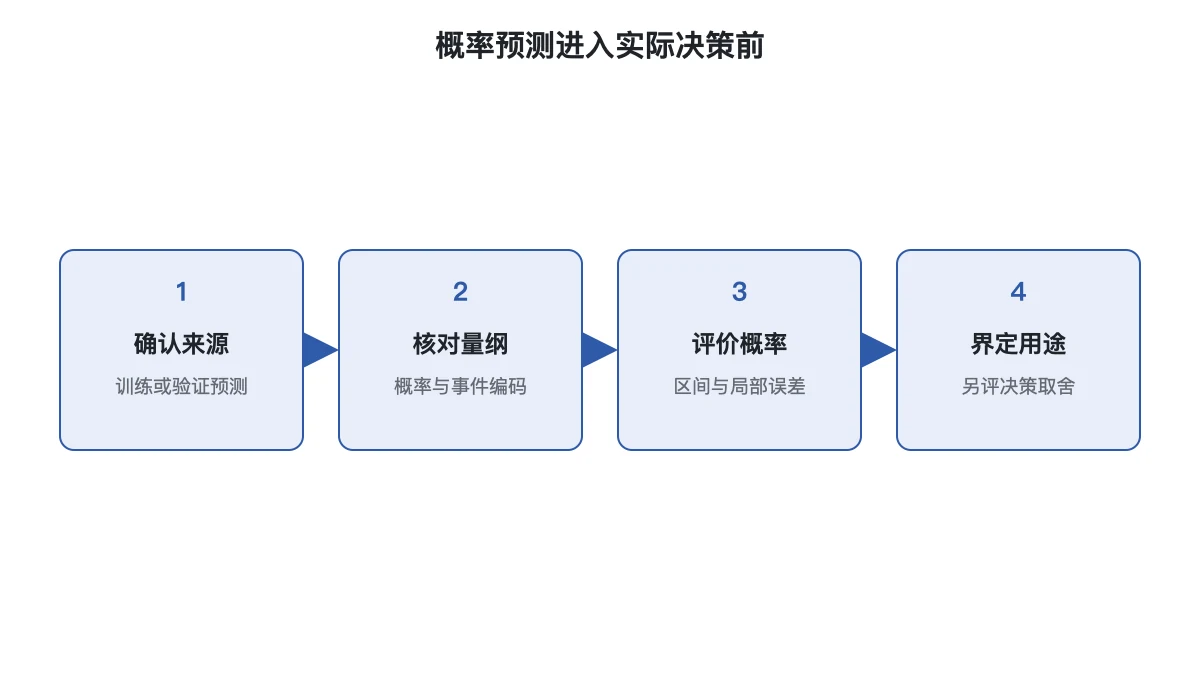
验证路线把概率评价与后续决策衔接起来。校准关注概率是否可信,区分能力关注排序,净获益关注指定阈值下的决策取舍;即便前一环节表现尚可,后一环节仍要按具体用途单独检查。
校准分析常见错误
- 把 H-L 未显著写成校准成立:保留检验未发现差异的措辞,并交代区间和近似条件。
- 用训练集回代图代表外部表现:先说明预测来源,再按研究设计安排验证。
- 把 Brier 当成纯失准指标:将其与斜率、截距及分箱误差结合解释。
- 只凭一个偏离点调整模型:先核查分箱数据与抽样波动,再在适当验证流程中评价调整方案。
开通会员后可导出 Word / PDF 报告、使用 AI 解读。保存结果时也请保留数据来源和分析设置,便于后续核查。
延伸阅读
常见问题
- 校准曲线怎么看,先看哪条线?
- 先辨认横轴预测概率、纵轴实测事件率和理想对角线,再结合分箱人数与置信区间判断偏离。整体检验未显著仍不足以断言模型校准已经达标。
- 校准斜率接近理想值就够了吗?
- 还需看其区间、整体偏移和应用场景容许的误差。斜率衡量预测幅度,截距与大局校准反映整体风险水平,几项指标的对象不同。
- 预测概率与实际概率为什么要分开?
- 前者是模型对个体的数值预测,后者在图中是分箱后的样本事件频率。每箱人数有限,实测频率本身存在抽样波动,应结合区间和验证设计解释。