

P值合并(Fisher/Stouffer)
这个方法是做什么的
当各项研究只报告了 p 值、拿不到可合并的效应量时,可以用 p 值合并方法回答一个更有限的问题:这些研究合起来,是否支持“至少有一项研究在预期方向上存在效应”。模块同时给出四种经典方法:Fisher 法(把各研究 p 值取对数求和,服从自由度 2k 的卡方分布)、Stouffer 法(把 p 值换成标准正态分位数后求和)、按 √n 加权的 Stouffer 法,以及按样本量作自由度加权的 Lancaster 法;后两种需要提供样本量。
所有方法都建立在单侧 p 值上。若文献给的是双侧 p,需要同时提供效应方向列(正数表示预期方向),模块据此换算:方向为正取 p/2,方向为负取 1 − p/2。报告卡③把每项研究的 z 值画成条形图,卡④用留一法检查合并结论是否被单项研究左右。
需要准备什么数据
- 研究标签 (可选)(可选):0~1 个
- 放入 p 值:1 个,定量变量(数值)
- 样本量 (可选)(可选):0~1 个,定量变量(数值)
- 效应方向 (双侧 p 时)(可选):0~1 个,定量变量(数值)
数据要求
- 数据表至少 2 行。
- 单列缺失率不超过 30%。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 文献只报告了检验统计量或 p 值,没有均值、标准差或比值,无法做效应量 Meta 分析
- 各研究的结局测量方式不同(不同量表、不同指标),但检验的是同一方向的同一假设
- 多中心、多批次的独立重复实验,想综合判断效应是否存在
- 基因关联、多个独立数据集的验证分析中,汇总各数据集的证据强度
前提是各研究相互独立,检验的是同一方向的同一假设,并且 p 值计算正确。p 值必须在 0 到 1 之间;文献写“p<0.001”时请录入上限值 0.001。
什么时候不要用它
- 能拿到各研究的效应量和标准误或置信区间:用「通用效应量Meta(亚组/回归)」,它能给出合并效应有多大,而不只是“有没有”。
- 研究报告的是两组均值与标准差:用「连续效应Meta(MD/SMD)」。
- 研究报告的是两组事件数:用「二分类效应Meta(OR/RR/RD)」。
容易误读的地方
- 合并 p 值不是效应量。 它只说明“至少有一项研究存在该方向的效应”,不能写成“合并效应显著”,也不能说明各研究的效应一致。样本量越大的研究越容易给出小 p,所以合并 p 很小也可能只是因为某项大样本研究。
- 双侧 p 不配方向就合并是常见错误。 方向相反的显著结果会被当成支持证据。只有双侧 p 时,务必提供效应方向列;方向无法判断的研究应排除,而不是默认按同向处理。
- Fisher 与 Stouffer 敏感的东西不同。 Fisher 法对少数研究 p 很小特别敏感,Stouffer 法对多数研究同向但都只是轻微显著更敏感,方向相反的研究会拉低 Stouffer 结果。两者结论不一致时都要报告,并说明主分析事先选的是哪一种。
- 研究必须相互独立。 同一批受试者的多次报告、同一研究的多个结局、同一数据集的不同分析都不独立,合并会严重夸大证据强度。
- 发表偏倚同样存在。 只有显著结果被发表时,p 值合并会系统性地夸大证据;留一法只能检查单项研究的影响,不能纠正发表偏倚。
- p 值的精度会影响结果。 文献常把 p 值写成“p<0.05”或“p<0.01”,按上限录入会让合并结果偏保守;录入前尽量从原文的检验统计量反推精确 p 值,实在无法获得时,在方法部分说明采用了上限值。
- 加权方法需要可比的样本量。 √n 加权的 Stouffer 法和 Lancaster 法默认样本量越大的研究信息越多;若各研究的设计差异很大(如配对设计与独立设计混在一起),样本量并不能直接代表信息量,这时以等权的 Fisher 与 Stouffer 结果为主,加权结果只作敏感性分析。
- 研究数太少时结论不稳。 只有两三项研究时,任何一项研究的变化都可能翻转结论,卡④的留一法需要至少 3 项研究;报告时应同时列出每项研究的 p 值,让读者自己判断证据是否集中在某一项研究上。
- 把合并结果写进论文时要交代方法细节。 方法部分应写明纳入了哪些研究、p 值是单侧还是由双侧换算、方向依据是什么、主分析采用哪一种合并方法,以及是否做了加权;读者据此才能判断合并证据的可信程度。
报告里有什么
- 输出结果一:纳入研究与前提检查
- 输出结果二:合并检验主结果表
- 输出结果三:各研究的 z 值
- 输出结果四:敏感性分析(P 值合并没有效应量)
- 输出结果五:结论与学术表述
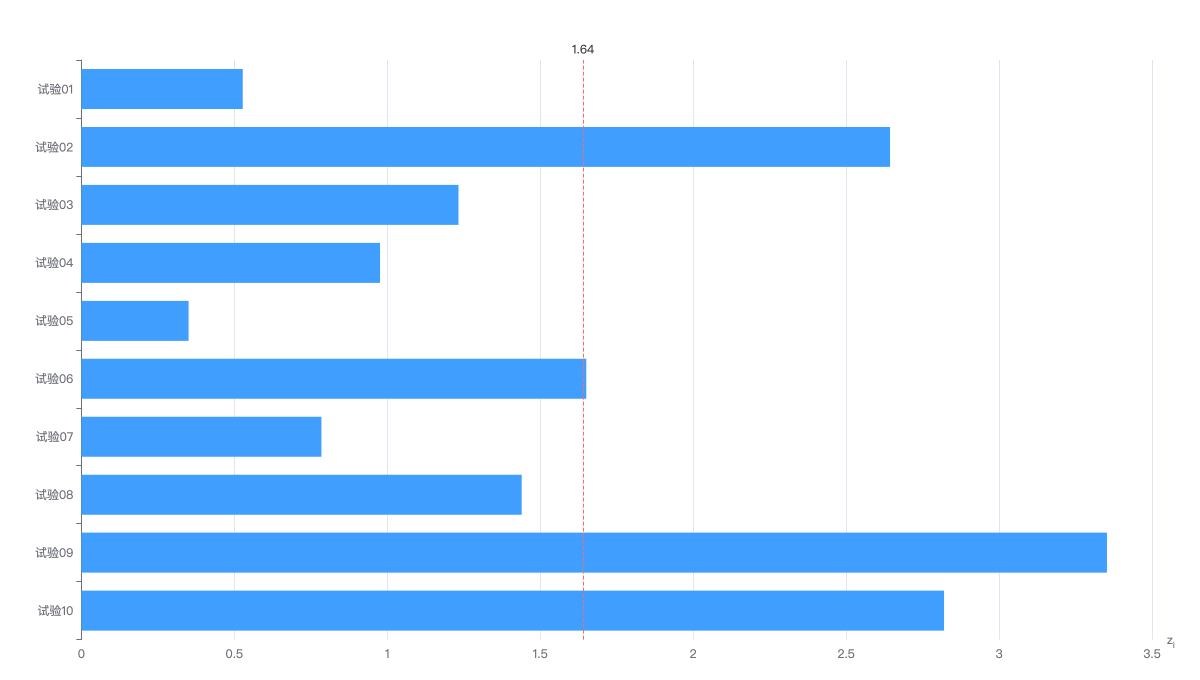
条形长度为各研究单侧 p 对应的标准正态分位数,红色虚线为单侧 p = 0.05 的位置。