
SPSS 调节效应要不要中心化:交互项共线性的处理
更新于
调节效应要不要中心化,关键在于解释参照点与乘积项的共线性,而不是追求显著。本站定量变量的调节分析会对自变量与调节变量做均值中心化;同一完整模型中的交互项检验不会因此被改造成另一种结论。
调节效应要不要中心化:先查交互项共线性
乘积项由自变量和调节变量相乘得到,原始分数距离零点较远时,乘积项可能与组成它的变量高度相关。这与变量内容本身重复不是同一个问题:均值平移能改变前者,却无法创造新的独立信息。看见较高VIF后,应先检查变量含义和模型设定,无法只追求让诊断表变得好看。
本篇使用调节作用分析的演示数据(模拟生成),随机抽取212行。工作绩效是因变量,工作投入是自变量,组织支持感是调节变量,工作年限作为控制变量;所有模型使用同一批有效记录。报告的描述统计仍采用原始分数,后续定量交互模型使用中心化变量,因此应避免把描述表里的均值误读成中心化没有执行。
本篇子样本在上传前按原表行序准备:用 Python 的 random.Random(3).sample 无放回抽取原记录的 85%,再按原行序保存。工作台分析的是这份固定子表,直接载入完整演示表会得到另一组结果。
原因:零点改变,条件解释也改变
中心化是每个分数减去该变量的样本均值,保留原单位和标准差。对包含截距、两个主项及乘积项的同一模型,这只是重新表达参数:原来主项对应另一变量为零时的斜率,中心化后对应另一变量处于样本均值时的斜率。模型拟合和交互项检验保持不变,变化的是主项与截距的解释。
这个结论需要“同一数据、同一完整模型、相同推断口径”的条件。若同时改变样本、删除主项或改用另一种标准误,就不再只是中心化前后的比较。中心化也无法处理遗漏变量、反向关系或测量误差;这些问题需要研究设计与模型论证,无法用一次数值变换解决。
解决步骤
- 选择「调节作用分析」,按角色放入工作绩效、工作投入、组织支持感与工作年限,保留本篇定量设置。
- 开始分析后查看中心化前后的共线性表,确认报告使用中心化后的完整交互模型,不再把自制乘积列当作调节变量重复放入。
- 从交互项行判断调节证据,再读取简单斜率和区间,将条件关联与主项参照点分别写清。
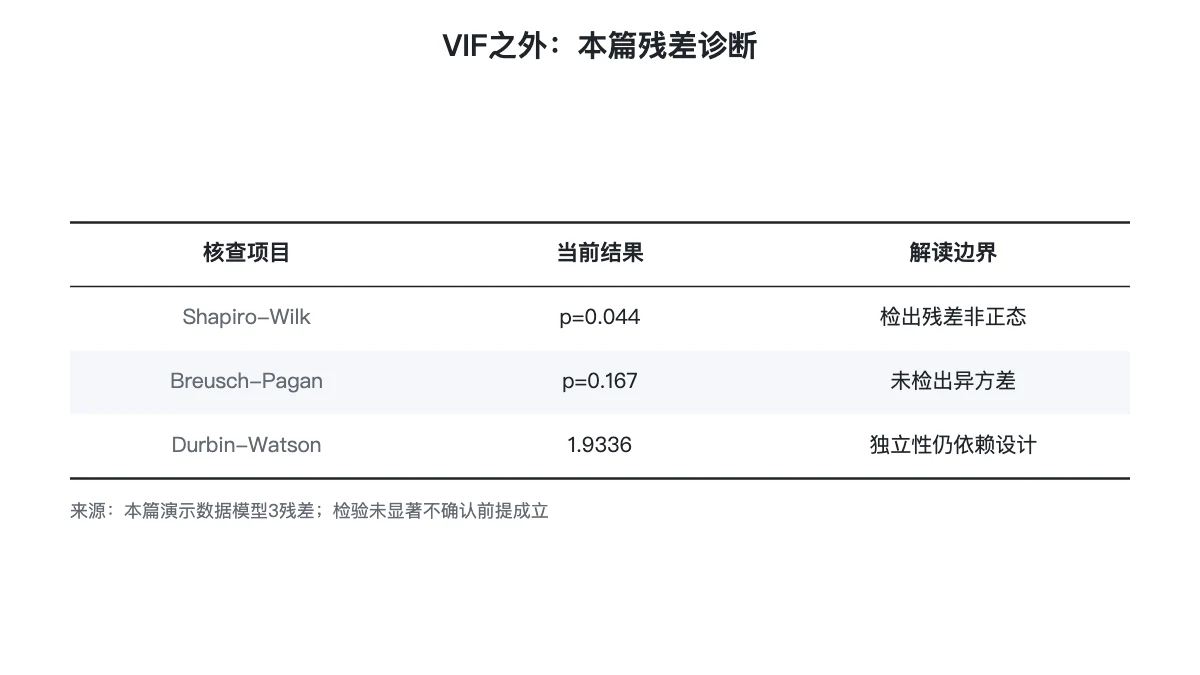
下表补充VIF之外的模型诊断,分别保留各项检验的概率或统计量。数值检查与研究设计保障来自不同证据,应一起记录,而非把共线性改善当成所有前提都成立。
怎么确认已经解决
本例工作投入与组织支持感乘积项的VIF由80.190降至1.041,说明这份资料中的非本质共线性明显减轻。这个变化不是交互效应增大的证据,也不代表所有模型前提自动满足;报告对残差与误差结构另有检查,应一并保留。
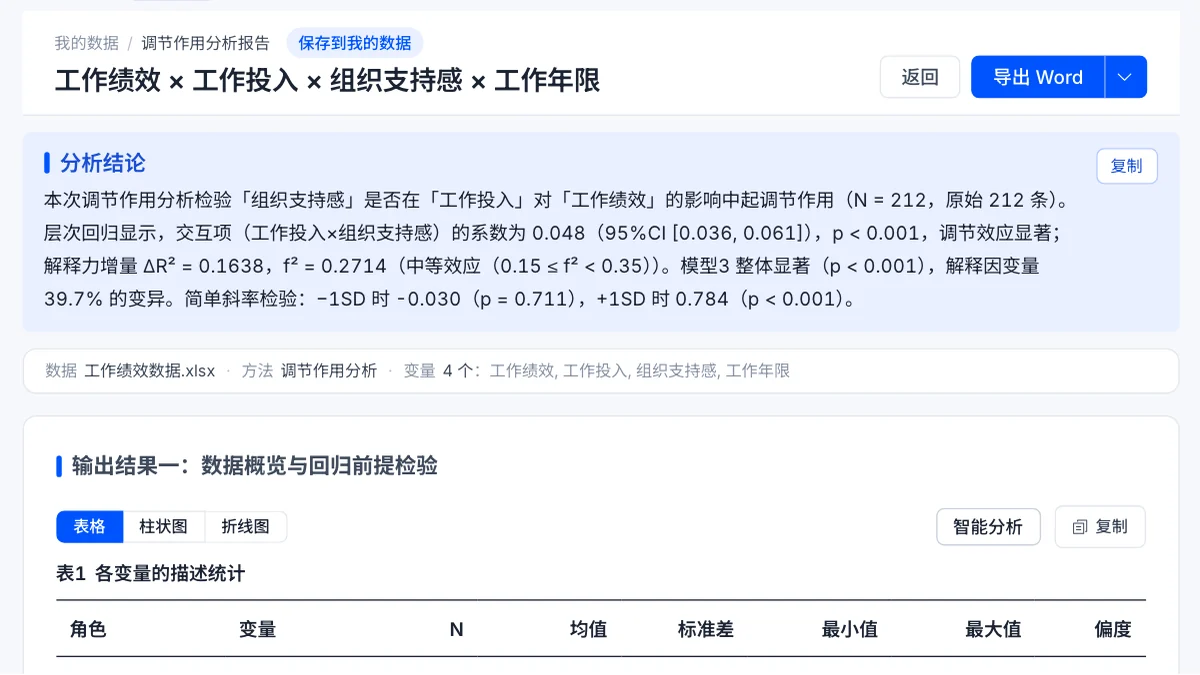
首屏摘要用于核对分析对象和变量角色,无法取代后面的系数表。真正回答调节问题的是交互项:其系数为0.048,区间[0.036, 0.061],p<0.001,支持工作投入与绩效的条件关联随组织支持感而变化。横截面模拟资料无法由此确认组织支持干预会改变绩效。
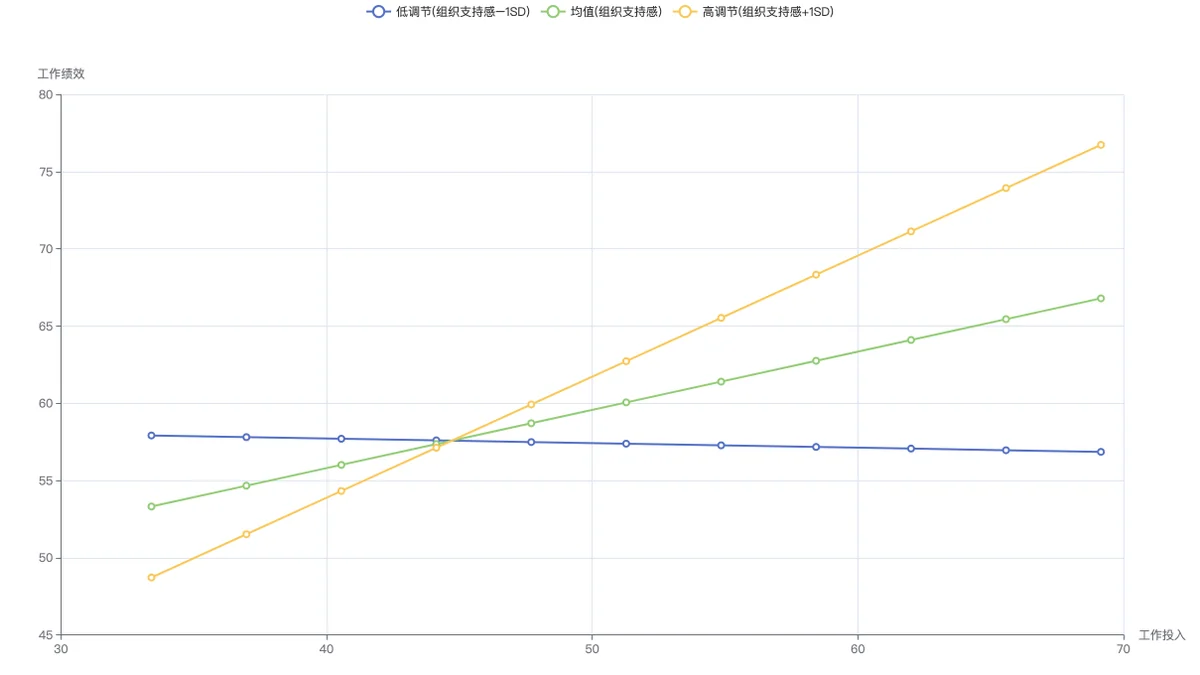
简单斜率图使用低、均值和高的代表性调节水平,图中的预测线不是把人群真实切成几个组。各水平检验回答该水平的关联是否可辨识,无法用“一个显著、一个不显著”直接论证两条斜率有差异;斜率差异仍应回到交互项检验。
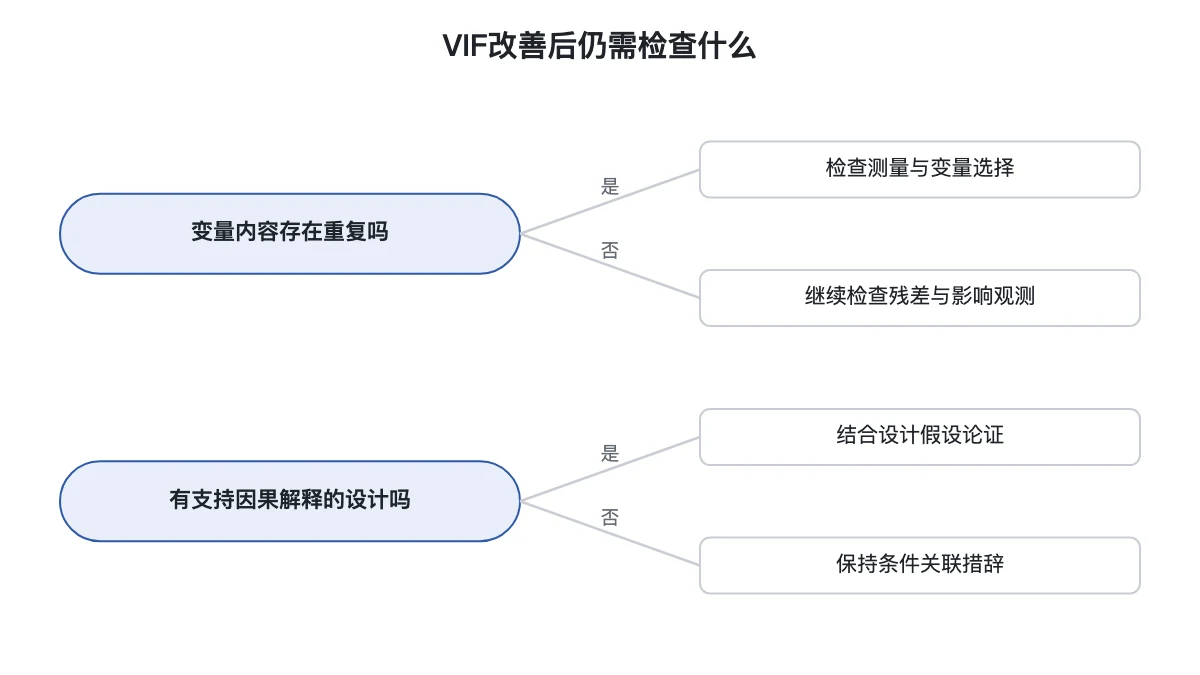
中心化后的零点是当前分析样本的均值,若由于缺失处理或纳入标准改变样本,参照点也可能变化。比较两个模型前,应先核对是否使用同一批对象、相同控制变量和同一种误差口径;否则主项变化可能同时混入样本与设定差异。要比较研究结论的稳健性,宜保存完整设定记录,无法只截取一行VIF下降就宣布问题全部解决。
调节中心化常见错误
- 把中心化当成标准化 → 说明仅减去均值,单位仍与原始分数相同。
- 为降低VIF删除主项 → 保留研究问题要求的完整交互结构,避免改变模型含义。
- 重复手工中心化且不记录 → 使用报告说明的变换口径,并保存变量处理记录。
- 将中心化后主项解释为总体平均效应 → 明确它是在另一变量均值处的条件斜率。
结果可以写:“自变量及调节变量经均值中心化后进入含交互项的模型,报告交互项估计与区间,并用简单斜率说明条件关联。”还应说明控制变量、误差口径和模型诊断,避免只展示一张图而省略可复现的设定。开通会员后可导出 Word / PDF 报告、使用 AI 解读。
延伸阅读
常见问题
- 调节效应要不要中心化以获得显著结果?
- 在同一完整线性交互模型、同一数据与相同推断口径下,均值平移不改变交互项的系数检验。
- 中心化能处理所有共线性吗?
- 无法。它可能减轻乘积项产生的非本质共线性,但无法修复预测变量之间本身的强线性依赖。
- 图上斜率看起来不同就算调节吗?
- 无法单凭图形判定,应查看交互项检验;各水平简单斜率是否显著是另一个问题。